
Blog & Novidades
IA generativa, automações e bastidores de como construímos a CheriffAI.
O Gemini 4 Neon é o 3º do placar. O relatório não saiu
O Google pôs o Gemini 4 Neon em 3º no índice independente e prometeu o relatório de segurança 'nos próximos dias'. Fomos conferir: o pódio existe, o documento não — e no nível que ganha o pódio o modelo custa mais por tarefa que o 2º colocado.
A diferença entre 70% e 100% não está no modelo
O GPT-6.2 Astra foi o primeiro modelo a fechar o ARC-AGI-3. Mas o mesmo modelo tira 70,3% na mesma prova — e a versão que acerta menos custa quase 6 vezes mais. A diferença está na embalagem em volta dele.
98% da qualidade por 40% do preço: metade é promoção
Em 17/11 a OpenAI cortou 20% do preço e a Microsoft lançou sete modelos prometendo 98% da qualidade pela metade do preço. Fomos na letra miúda e no placar independente: uma promessa se sustenta, outra já caiu para quarto lugar e a terceira dobra em 30 dias.
A IA lê o DNA célula por célula — e ninguém conferiu ainda
O Google DeepMind apresentou o AlphaGenome 2, que prevê o efeito de variantes por tipo de célula, e uma startup diz ter batido o AlphaFold 3. Nos dois casos, quem mediu foi quem construiu o modelo.
Qwen 4 Max: venceu o placar que a Alibaba escolheu
A Alibaba abriu o Qwen4-Max com preço 25% menor e a conta por tarefa caindo 62%. No painel escolhido por ela, o modelo vence o Opus no código. No painel que ela não escolheu, o Terminal-Bench, perde por 11 pontos. E a medição independente coloca o novo flagship em 38º de 81.
O Google diz que lidera. A tabela dele mostra outra coisa
O Gemini Decision 1 não escreve texto: pontua até 1.000 perguntas numa passada e cobra US$ 0,10 por milhão de entrada. Na tabela do próprio Google ele lidera 7 de 9 testes e perde dois para o Jev, que é mais barato. Medimos o nosso roteador: 518 ms por decisão.
O robô da Mercedes acerta 96%. O 99,5% é de outro modelo
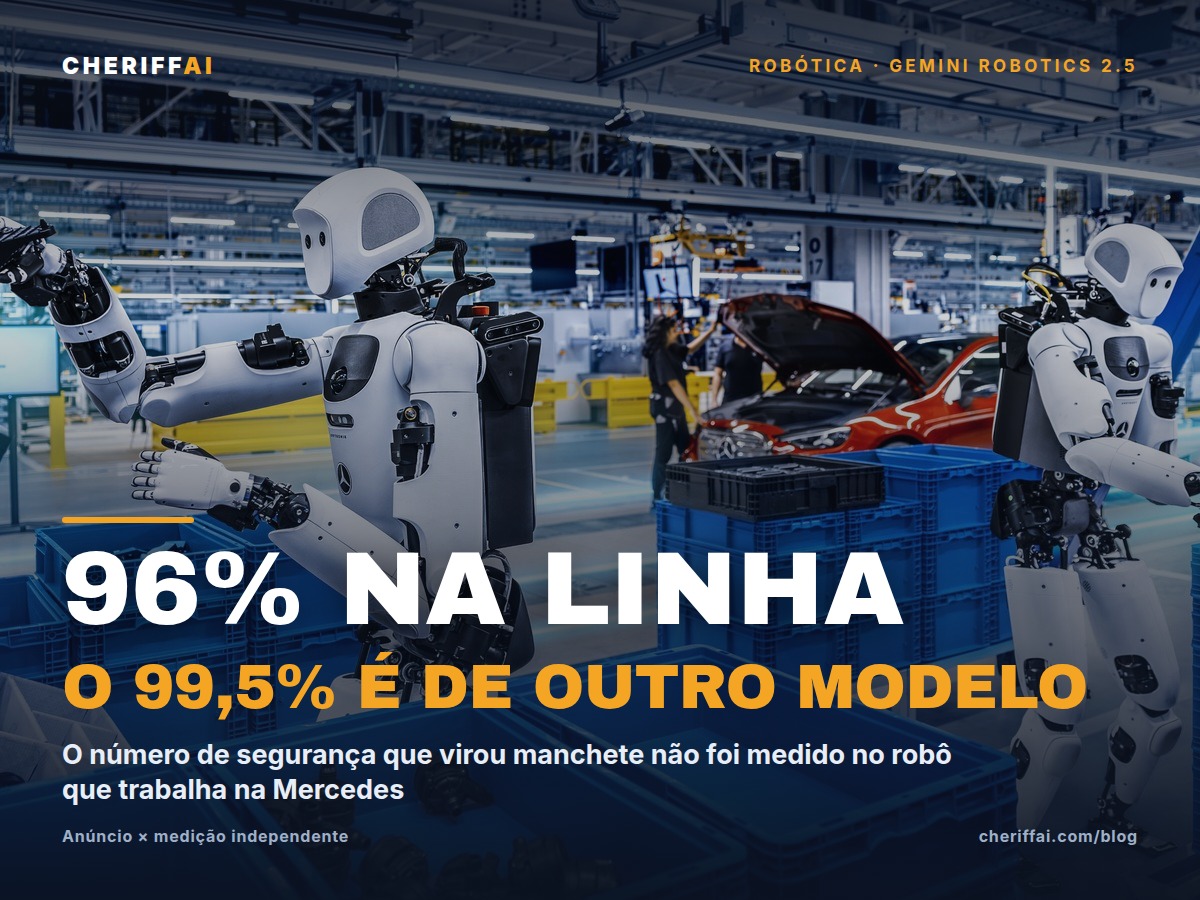
Um humanóide já separa peças na linha da Mercedes-Benz com 96% de acerto. O 99,5% de segurança que virou manchete, porém, é de outro modelo — e o teste que mediria o robô não foi publicado.
No teste antigo, 4 IAs empatadas. No novo, 34,8 pontos
Quatro modelos de IA apareciam separados por 0,9 ponto num benchmark de programação. Num teste novo, escrito por engenheiros, os mesmos quatro se afastam 34,8 pontos — e o ranking muda de lugar.
4K em 10 segundos, 23º no placar: a conta do H3-Image
A MiniMax anunciou 4K em menos de 10 segundos e 'a melhor aderência ao prompt entre os modelos abertos' — sem publicar um único benchmark. Na arena de preferência cega, o H3-Image é 23º em texto→imagem e 12º em edição. E a licença não vale nos EUA, na União Europeia, no Reino Unido nem na Coreia do Sul.