
Na terça-feira, 17 de novembro, dois dos maiores laboratórios de inteligência artificial do mundo publicaram seus anúncios com poucas horas de diferença. A OpenAI lançou o GPT-6.2 Astra e o GPT-6.2 Sol e cortou 20% do preço da API do modelo principal. A Microsoft, no evento Ignite, lançou sete modelos de uma vez mais um acelerador próprio — e a frase que abre o comunicado não é sobre o que a IA sabe fazer, é sobre dinheiro: com o gasto em tokens disparando, os clientes querem modelos a um preço que permita rodar agentes 24 horas por dia.
Repare no que mudou. Durante dois anos, cada lançamento foi uma disputa de placar: quem raciocina melhor, quem passa mais provas, quem tem o maior contexto. Nesta terça, os dois anúncios foram sobre a conta. E quando a conversa vira preço, aparece um tipo de letra miúda que não existia antes: a promocional.
Fomos atrás das três promessas de preço que viraram manchete. Uma se sustenta — e é até melhor do que o fornecedor disse. Uma já caiu. E a terceira depende de um desconto que dobra depois.
O que a Microsoft prometeu, item por item
O comunicado oficial, que lemos na íntegra, lista sete modelos e um chip. O resumo, nas palavras deles:
- MAI Cyber 2 Flash — bate a qualidade do GPT-6 Astra a menos de 2% do custo por tarefa, medido no CyberGymE2E.
- MAI Code 2 — chega a 98% da qualidade de código do GPT-6.1 Sol por cerca de 40% do preço. Contra o Opus 5.5, 96% do desempenho por 5% do preço.
- MAI Code 2 Flash — empata com o GPT-6 Luna por 65% do preço e com o Haiku 5.5 por 20%.
- MAI Image 2.7 — é o número 1 do placar de edição de imagem do Artificial Analysis, batendo o GPT Image 2.6 Sunburst a um quinto do preço.
- MAI Realtime 1 — supera o GPT-Realtime 2.1 e começa em US$ 0,01 por minuto de áudio.
- Dragon Copilot Transcribe — construído sobre o MAI Transcribe 2, já processa 10 milhões de atendimentos de pacientes por mês.
- Decision 1.1 — 50 vezes mais rápido e 79 vezes mais barato que o GPT-Sol 6.1.
- Maia 200 — o acelerador de segunda geração entra em produção com 1,7 vez mais tokens por watt.
Todas essas frases têm a mesma estrutura: um número de qualidade colado a um número de preço. É uma forma de prometer que funciona bem em manchete — e que só vale se os dois números aguentarem a conferência. Três delas aguentam ser checadas hoje. Vamos.
Promessa 1: "número 1 no placar de edição de imagem"
O comunicado da Microsoft é direto: o MAI Image 2.7 "é o nº 1 do Artificial Analysis em edição de imagem, superando o GPT Image 2.6 Sunburst (max) a apenas um quinto do preço".
Abrimos o mesmo placar na manhã de 18 de novembro, um dia depois da publicação. O MAI Image 2.7 aparece em quarto lugar, com 1214 pontos de Elo. O primeiro lugar é do GPT Image 2.6 Sunburst, com 1261 — quarenta e sete pontos de distância. Entre os dois estão ainda o GPT Image 2.5 Sunburst (1229) e o GPT Image 2.6 Flare (1227).
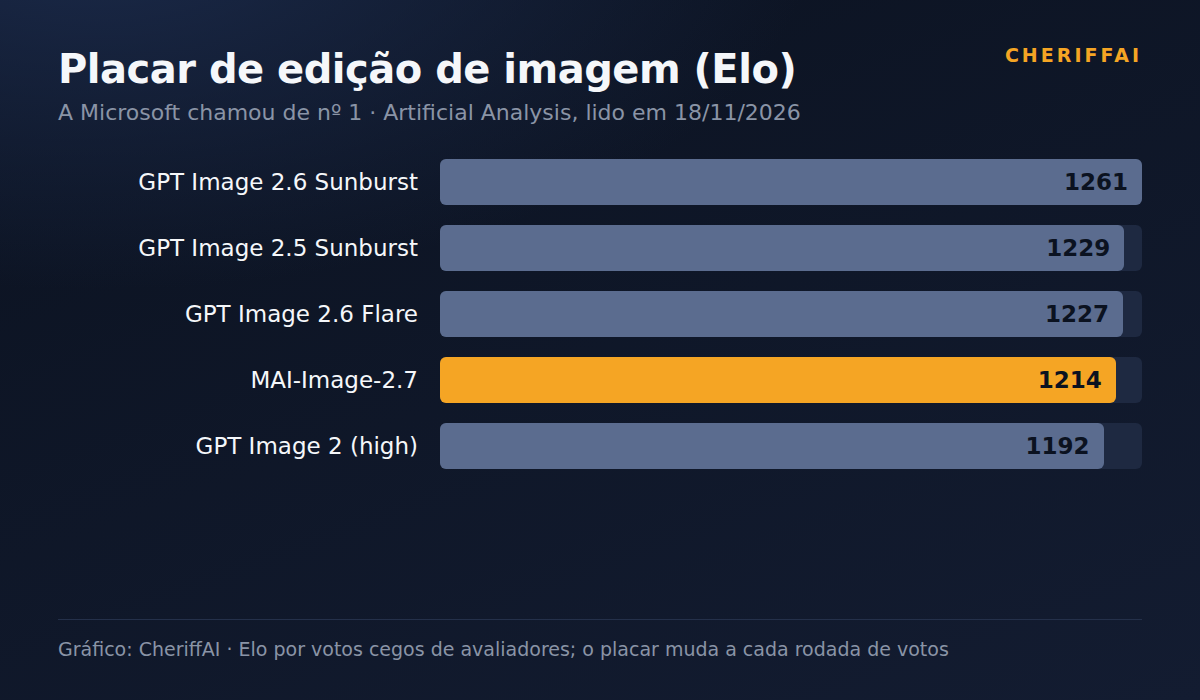
Agora, o detalhe que muda a leitura: esse placar não é uma prova que se corrige. É uma arena de preferência. O próprio Artificial Analysis descreve a nota como "pontuação de Elo a partir de votos cegos dos nossos avaliadores privados". Ou seja: cada voto novo move a tabela, e a diferença entre o primeiro e o segundo lugar costuma ser menor do que o intervalo de confiança da medição.
Isso significa duas coisas ao mesmo tempo, e as duas são verdade. A Microsoft pode ter lido o número 1 de verdade no dia do anúncio — a liderança trocou de mãos várias vezes nas últimas semanas, e há relatos de leituras de 1215 contra 1211 na véspera. E qualquer pessoa que abrir o placar hoje vai encontrar o modelo em quarto. "Nº 1 do ranking" não é uma propriedade do modelo; é uma fotografia com data. Quem escreve a manchete deveria escrever a data junto.
Promessa 2: "a um quinto do preço" — essa se sustenta
Aqui a medição confirma o fornecedor, e por pouco não supera. No mesmo placar, o preço de referência por mil imagens geradas é de US$ 34,82 para o MAI Image 2.7 contra US$ 210,72 do GPT Image 2.6 Sunburst. A razão é 6,05 — a Microsoft prometeu cinco vezes mais barato e entregou seis.
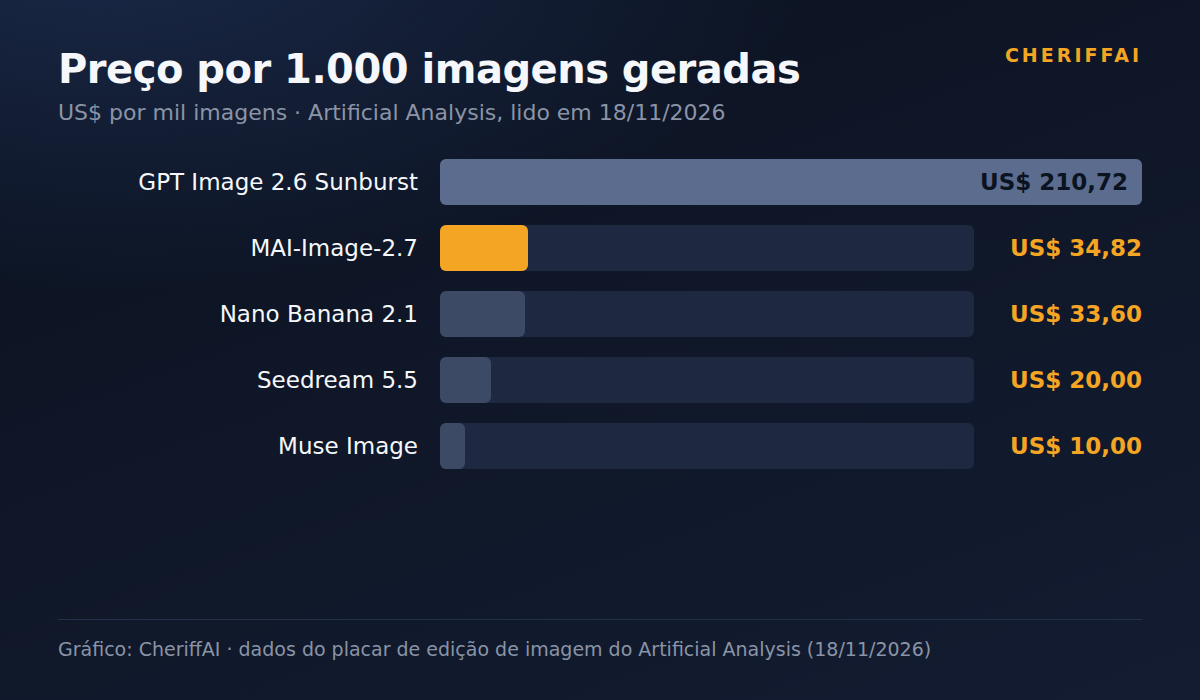
É a promessa mais fácil de checar e a menos impressionante das três. Preço publicado é preço publicado: quem anuncia tabela pode ser conferido no mesmo dia, com uma calculadora. E o gráfico mostra o que o "seis vezes mais barato que o líder" esconde: o Muse Image da Meta custa US$ 10 por mil imagens — um terço do MAI Image 2.7. Ser muito mais barato que o campeão não faz de ninguém o mais barato do mercado.
Promessa 3: "98% da qualidade por 40% do preço"
Essa é a frase que virou manchete, e é a que tem dois asteriscos — os dois na própria página da Microsoft.
O primeiro está na nota metodológica do post sobre os modelos de código. Dos quatro testes citados para sustentar os "98%", três foram rodados na MSBench, a plataforma interna de avaliação da Microsoft, com o GitHub Copilot CLI e sem subagentes: DeepSWE 1.1, TerminalBench 2.1 e SWE Atlas. Só o quarto, o FrontierCode 1.1, vem de fora — do Artificial Analysis. Não é irregular: todo laboratório mede o que constrói. Mas "98% da qualidade" é uma média tirada majoritariamente de uma régua que o próprio fornecedor segura.
O segundo asterisco está na mesma nota, em uma linha que passa despercebida: "o custo do MAI-Code-2 é mostrado com seu preço promocional de 50%". É isso. O "40% do preço" não é o preço do modelo. É o preço dele durante a promoção. Quando a promoção terminar, o mesmo modelo custa o dobro — e a frase que sobra é outra: 98% da qualidade por cerca de 80% do preço.
A promessa não é falsa. Ela é temporária — e o prazo não está na manchete.
Não é um detalhe burocrático. Se você está decidindo a arquitetura de um produto que vai rodar por dois anos, a diferença entre 40% e 80% do preço do concorrente é a diferença entre um projeto que fecha a conta e um que precisa ser refeito. Preço promocional serve para ganhar o cliente; ele não serve para dimensionar custo.
Do outro lado: a OpenAI cortou 20% e continua em segundo
O anúncio da OpenAI, no mesmo dia, tem números mais limpos e uma história menos confortável. Do lado do preço, a mudança é real e sem asterisco: o GPT-6.2 Astra passou de US$ 10 para US$ 8 por milhão de tokens de entrada e de US$ 50 para US$ 40 por milhão de saída, com o token em cache caindo 60%, para US$ 0,40. O GPT-6.2 Sol manteve US$ 2 / US$ 10.
Do lado da qualidade, a OpenAI afirma que o Astra marca 5,2 pontos a mais que o GPT-6 Astra no Agents' Last Exam — um teste de trabalho profissional de várias etapas — gastando menos de um terço por tarefa. E que terminou 5,5 pontos à frente do Claude Fable 5.2 da Anthropic a 5% do custo. Só que essa última comparação não usou todas as tarefas: segundo o relato do ForkLog, nove tarefas ficaram de fora do resultado do Claude porque envolviam um modelo de reserva (fallback). Comparar contra o concorrente com o concorrente rodando no modo degradado é uma forma de ganhar que não sobrevive à pergunta seguinte.
A medição independente, lida hoje, coloca o Astra em segundo lugar, com 62 pontos no índice de inteligência do Artificial Analysis. O primeiro é do Claude Fable 5.2, com 65. A distância é de três pontos. O que muda a conversa é o preço por tarefa: US$ 4,00 para o Astra contra US$ 26,54 para o Fable.
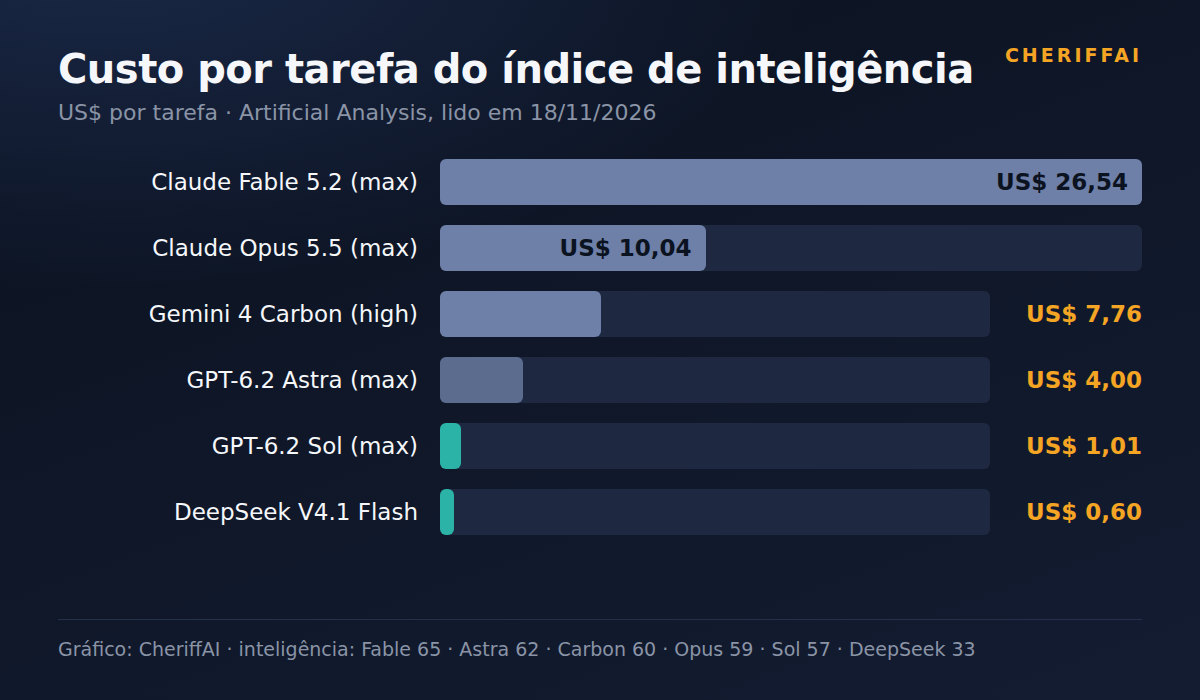
Coloque os dois números lado a lado e a manchete se escreve sozinha: três pontos de inteligência custam 6,6 vezes mais. O Astra não é o modelo mais capaz do mundo — é o modelo mais capaz por dólar no topo da tabela. E essa é uma frase muito mais útil do que "o mais inteligente", porque ela responde à pergunta que quem paga a conta realmente faz.
Vale olhar o chão da tabela, porque ele explica o movimento melhor do que o topo: o DeepSeek V4.1 Flash, aberto, custa US$ 0,60 por tarefa — 6,7 vezes menos que o Astra e 44 vezes menos que o Fable, com 33 pontos de inteligência contra 62. A fronteira hoje é uma faixa estreita e cara no alto e uma base larga e barata embaixo. Quase todo produto real vive na base.
O que isso muda para quem constrói no Brasil
Um: o número que importa não é o preço por token, é o custo por tarefa. Um modelo que gasta três vezes menos tokens para chegar ao mesmo resultado pode custar o dobro por token e ainda sair mais barato. Todos os anúncios desta semana falam em preço por milhão de tokens porque é o número que parece pequeno; a sua fatura chega em tarefas.
Dois: leia a nota de rodapé antes de fechar arquitetura. "Promocional", "preview", "preço introdutório" e "sujeito a alteração" são as quatro expressões que decidem se o seu produto fecha a conta em 2027.
Três: desempenho declarado em plataforma interna do fornecedor é indício, não prova. Procure a linha que diz onde o teste rodou. Se os quatro benchmarks vieram da mesma casa que vende o modelo, o resultado é uma hipótese bem fundamentada.
Quatro: placar com data. Nenhum ranking de preferência é estável o suficiente para virar argumento de venda sem o dia da leitura ao lado. Quem cita "nº 1 do ranking" sem data está vendendo uma fotografia como se fosse uma propriedade.
Como conferir sozinho, em cinco minutos
O roteiro que usamos aqui não precisa de conta paga nem de ferramenta especial:
- Vá ao comunicado oficial e copie as frases de comparação exatamente como estão escritas, com o número e o benchmark.
- Abra o placar independente citado e anote a data e a hora da leitura antes de olhar a posição.
- Procure a nota metodológica e responda duas perguntas: onde cada teste rodou e se o preço citado é de tabela ou promocional.
- Converta tudo para custo por tarefa — é a única unidade comparável entre modelos que gastam quantidades diferentes de token.
- Se a diferença entre primeiro e segundo lugar for menor que o intervalo de confiança, escreva "empate técnico", não "liderança".
Nada disso é desconfiança. É o mínimo que um número merece. O que a terça-feira de 17 de novembro mostrou é que os dois laboratórios mais ricos do setor, no mesmo dia, escolheram falar de preço — e que um deles colocou na manchete um número que a própria nota de rodapé desmente em 30 dias. A parte boa é que dá para conferir. A parte ruim é que quase ninguém confere.
Fontes
- Microsoft AI — Seven new world class models at scalable price-performance (17/11/2026)
- Microsoft AI — MAI Code 2 and Code 2 Flash: everyday coding at scalable prices (17/11/2026, nota metodológica com o preço promocional de 50%)
- Artificial Analysis — Image Arena, aba Image Editing (lido em 18/11/2026)
- Artificial Analysis — Intelligence Index, custo e tempo por tarefa (lido em 18/11/2026)
- SiliconANGLE — OpenAI rolls out GPT-6.2 Astra and Sol (17/11/2026)
- ForkLog — OpenAI launches GPT-6.2 Astra and Sol (18/11/2026)