
A primeira nota 100% — e a nota 70% do mesmo modelo
No dia 17 de novembro a OpenAI colocou no ar dois modelos novos, o GPT-6.2 Astra e o GPT-6.2 Sol. No mesmo dia, a organização que roda o teste ARC-AGI publicou os resultados verificados: o Astra foi o primeiro modelo da história a fechar 100% no ARC-AGI-3. É o tipo de número que vira manchete e slide de conferência.
Só que o mesmo documento traz outro número, na linha de baixo, para o mesmo modelo, na mesma prova: 70,3%. Não é outra versão, não é outro dia, não é um modelo menor. É o GPT-6.2 Astra, com o mesmo peso, rodando de outra maneira.
A diferença entre acertar 7 de cada 10 e acertar 10 de 10 não estava na inteligência do modelo. Estava na embalagem em volta dele — e essa embalagem, como quase tudo nessa área, tem preço. Só que, aqui, o preço veio ao contrário do que qualquer pessoa esperaria.
O ARC-AGI-3 não é uma prova de múltipla escolha
Vale entender o teste antes do placar. O ARC-AGI ficou conhecido por aqueles quebra-cabeças coloridos que a IA precisa resolver sem instrução nenhuma. O ARC-AGI-3 é a versão interativa: são 25 jogos em que o modelo precisa agir, ver o que aconteceu e descobrir as regras na tentativa e erro — como uma pessoa que abre um jogo novo sem manual.
Isso muda a natureza da medida. Em prova de papel, você conta acertos. Em jogo, cada jogada errada custa tempo, custa dinheiro e custa a memória daquilo que já foi descoberto. A partir daí, "acertar" passa a depender tanto do que o modelo sabe quanto de quanto ele consegue não se perder no meio do caminho.
A embalagem tem nome: é o que o modelo pode levar de um passo para o outro
O ARC Prize mede o ARC-AGI-3 de duas formas, e a própria página de resultados explica cada uma em uma frase:
- Modo padrão: o modelo pode carregar adiante as anotações que ele mesmo escolher manter ao longo do jogo.
- Modo adaptador: o fornecedor guarda o raciocínio interno do modelo entre uma chamada e outra e o comprime quando a conversa fica longa, para que ele reaproveite o trabalho já feito em vez de refazer.
Traduzindo para a vida real: é a diferença entre um aluno que faz a prova com uma folha de rascunho que ele mesmo organiza e outro que tem o rascunho inteiro preservado, sem precisar reescrever a conta a cada nova questão. O conhecimento é o mesmo. O que muda é quanto esforço se perde no caminho.
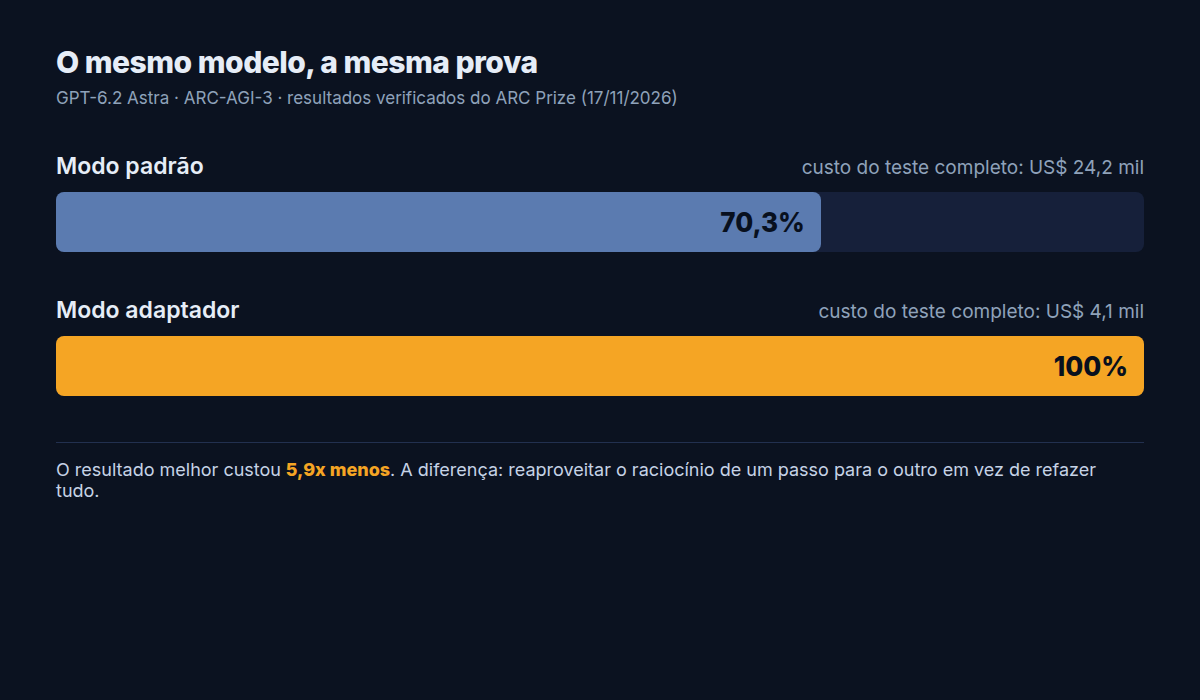
No modo padrão, o Astra acerta 70,3%. No modo adaptador, o mesmo Astra chega a 100% — o melhor resultado já medido no teste. São 29,7 pontos de diferença produzidos por um detalhe de encanamento, não por treino novo.
E a conta virou de cabeça para baixo
Aqui está a parte que separa este post de uma nota de release. Normalmente, no mercado de IA, o resultado melhor é o mais caro. Neste caso, o ARC Prize publicou as duas pontas: 100% no modo adaptador custando US$ 4,1 mil, e 70,3% no modo padrão custando US$ 24,2 mil.
Ou seja: o modo que acerta 10 de 10 saiu 5,9 vezes mais barato que o modo que acerta 7 de 10. A explicação está no mesmo lugar. Reaproveitar o raciocínio anterior significa mandar menos token, repetir menos passo e gastar menos jogada. O ARC Prize mediu que, nos 25 jogos, o Astra usou 64,1% menos ações do que o ser humano de referência e 53% menos tokens de raciocínio na primeira jogada em comparação ao GPT-6 Astra.
Nesta prova, a configuração que joga melhor é a que joga mais barato — porque ela passa menos tempo se repetindo. Quem só olha a nota não vê isso. Quem olha a nota e a conta vê o mecanismo.
Para efeito de comparação: o Sol, o irmão barato, chega a 98,2% no modo adaptador por US$ 1,5 mil — 64% menos custo para ficar 1,8 ponto atrás.
Não é truque de uma casa só
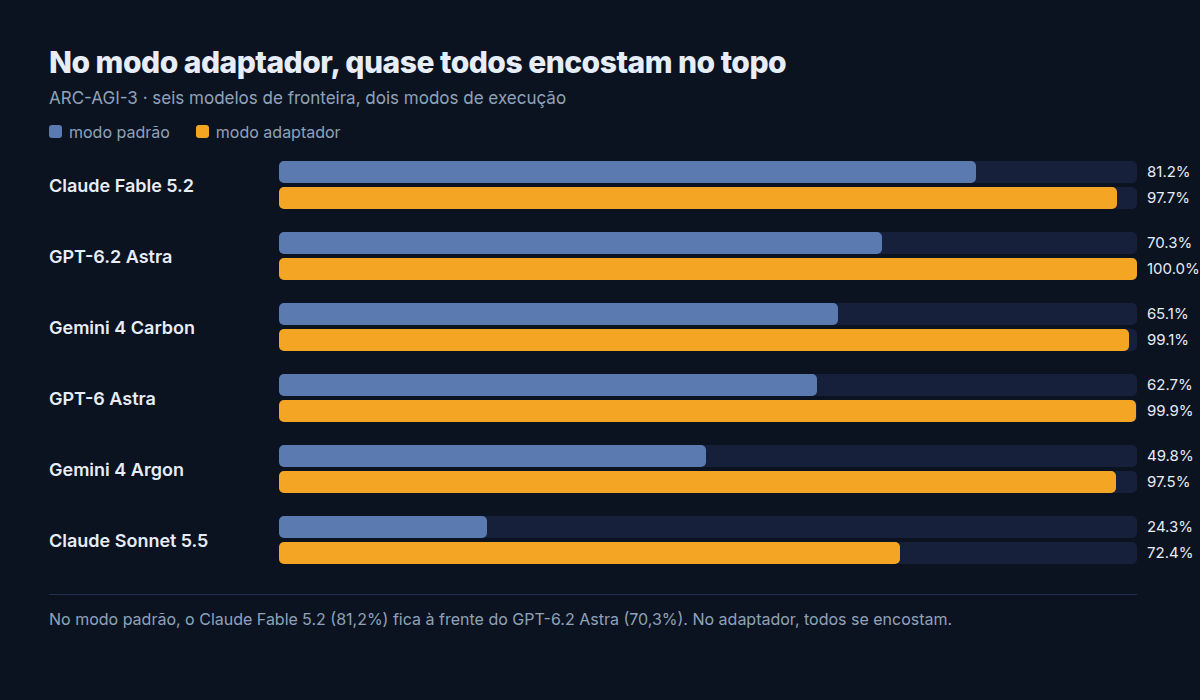
Seria fácil ler o caso acima como "a OpenAI arrumou um jeito de inflar número". O problema dessa leitura é que o efeito aparece em todo mundo que aceitou ser medido nos dois modos. Os números abaixo saem todos do placar público do ARC Prize, na mesma coluna, na mesma data de leitura:
| Modelo | ARC-AGI-3 modo padrão | ARC-AGI-3 modo adaptador | Diferença |
|---|---|---|---|
| GPT-6.2 Astra (17/11) | 70,3% | 100,0% | +29,7 |
| Claude Fable 5.2 (09/11) | 81,2% | 97,7% | +16,5 |
| Gemini 4 Carbon (10/11) | 65,1% | 99,1% | +34,0 |
| GPT-6 Astra (02/09) | 62,7% | 99,9% | +37,2 |
| Gemini 4 Argon (13/10) | 49,8% | 97,5% | +47,7 |
| Claude Sonnet 5.5 (28/09) | 24,3% | 72,4% | +48,1 |
Repare no que a tabela faz com a manchete. No modo adaptador, quase todo mundo de fronteira fica perto de 100% — o teste perde poder de separar modelos. No modo padrão, a ordem se mexe: o Claude Fable 5.2 acerta 81,2% e fica à frente do Astra, que marca 70,3%. A mesma semana, os mesmos modelos, e o "primeiro da história" some quando você muda a régua.
Dois casos práticos para o seu trabalho
Caso 1 — comparar modelos com honestidade. Se você for montar um piloto, a pergunta certa deixa de ser "qual tem a maior nota" e passa a ser "qual entrega o resultado que eu preciso pelo menor custo por tarefa". O ARC Prize publica justamente essa relação. No placar, o Fable 5.2 lidera o modo padrão com 81,2% a US$ 21,9 mil de execução, enquanto o Astra fecha 100% no modo adaptador a US$ 4,1 mil. Quem monta planilha só com a coluna de acerto escolhe o mais caro e não percebe.
Caso 2 — a compra do dia a dia. No preço de tabela da API da OpenAI, o Astra custa US$ 8 de entrada e US$ 40 de saída por milhão de tokens (US$ 0,40 no cache). O Sol custa US$ 2 e US$ 10 (US$ 0,10 no cache) — quatro vezes menos. No teste, essa diferença de preço comprou 1,8 ponto. Se o seu problema é classificar chamado de suporte ou resumir reunião, os 98,2% do Sol resolvem; o Astra faz sentido quando cada erro custa caro o bastante para justificar 2,7 vezes mais gasto por execução. É uma decisão de negócio, não de vaidade de ranking.
O contraponto: quem usa no dia a dia não viu 100%
O placar é uma coisa, o uso é outra. No mesmo 17 de novembro, Simon Willison testou os dois modelos no teste que ele repete a cada lançamento (uma animação 3D em que um prédio se levanta como robô) e escreveu: "nenhum dos dois fez um trabalho bom o bastante", comparado ao Claude Fable 5.2 e ao Gemini 4 Carbon. Ele também registrou que "o burburinho em volta destes modelos está misturado" e reproduziu a reclamação de outro desenvolvedor: em tarefa longa, o Astra interrompe o trabalho para perguntar um detalhe interno que o usuário não tem como responder.
Nada disso anula o ARC-AGI-3, e o ARC-AGI-3 não anula isso. Um mede raciocínio em ambiente controlado com custo publicado; o outro mede a paciência de quem trabalha com a ferramenta oito horas por dia. São duas medições diferentes do mesmo produto — e é exatamente por isso que as duas precisam aparecer juntas.
Três perguntas antes de acreditar em um "número 1"
- Qual versão do teste? ARC-AGI-1, 2 e 3 medem coisas diferentes. O Astra marca 98,5% no primeiro e 70,3% no terceiro, na mesma configuração.
- Qual modo de execução? Se a resposta não vem junto com o número, o número não significa nada. "100%" e "70,3%" são o mesmo modelo.
- Quanto custou rodar? Um score sem custo por tarefa é metade de um resultado. E, neste caso, a metade que falta é justamente a que explica o mecanismo.
O que isso muda para quem está no Brasil
Para a maioria das empresas brasileiras, a decisão não é entre Astra e Sol — é entre usar um modelo caro num problema simples e usar um barato num problema que exige o caro. A lição deste placar é que a embalagem em volta do modelo (quantas chamadas, o que se reaproveita entre elas, quanta memória se preserva) mexe no resultado e na conta mais do que a troca de fornecedor. Quem monta o próprio encanamento de inferência pode ganhar mais pontos ajustando o encanamento do que pagando por um modelo de fronteira.
E fica o hábito que vale para toda segunda-feira de lançamento: antes de repassar um "melhor modelo do mundo" para a diretoria, peça a versão do teste, o modo de execução e o custo por tarefa. Se algum dos três faltar, o número ainda não está pronto para virar decisão.
Fontes
- ARC Prize — GPT-6.2 Astra, resultados verificados (17/11/2026)
- ARC Prize — série GPT-6.2 (Astra e Sol), definição dos dois modos de execução (17/11/2026)
- ARC Prize — placar público do ARC-AGI, leitura de 19/11/2026
- ARC Prize — publicação dos resultados e custos do Astra (17/11/2026)
- ARC Prize — resultados e custo do GPT-6.2 Sol (17/11/2026)
- OpenAI — tabela de preços da API, lida em 19/11/2026
- Simon Willison — GPT-6.2 Astra and Sol (17/11/2026)