
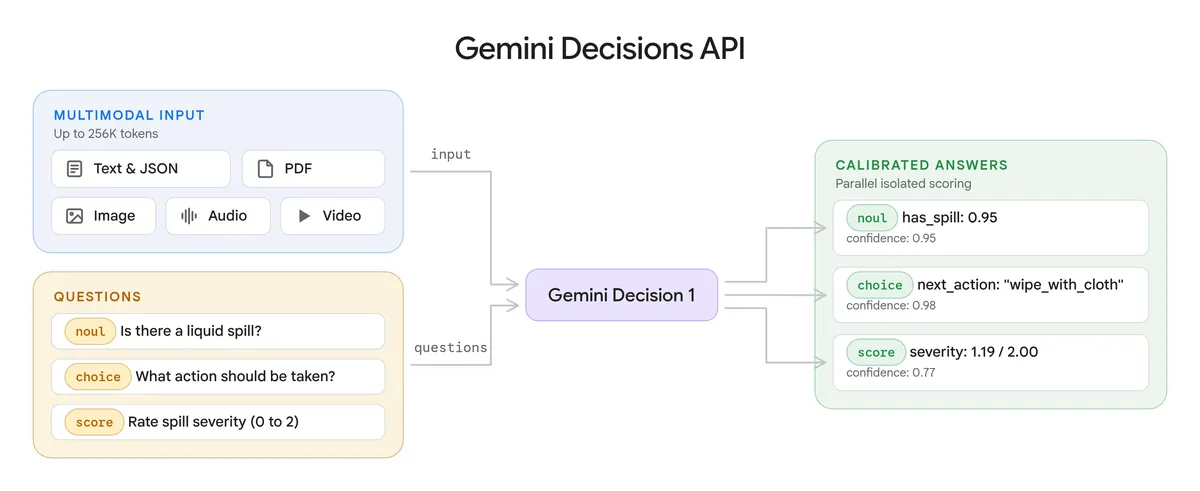
O Google publicou em 11 de novembro um modelo que não escreve texto. Ele não completa frase, não redige resposta, não inventa parágrafo. Recebe uma entrada só — texto, imagem, áudio, vídeo ou PDF — junto com uma lista de perguntas de resposta fechada, e devolve probabilidades. Chama-se Gemini Decision 1, e o endpoint que o serve é a Gemini Decisions API.
Quem acompanha a CheriffAI já viu esse desenho aqui: a categoria de modelos que decidem em vez de escrever foi o assunto do post sobre o modelo da Microsoft que não escreve. A diferença é que agora virou endpoint de nuvem com preço publicado, camada grátis no AI Studio e tabela de benchmarks assinada pelo Google — e, quando o fornecedor publica a própria tabela, dá para ler a letra miúda.
O que ele faz, em português
Esqueça o chatbot. Pense num conferente. Você entrega o material (a foto do balcão, o laudo escaneado, a gravação da ligação) e entrega o checklist: “tem líquido derramado?”, “qual ação cabe aqui?”, “que nota de gravidade, de 0 a 2?”. O conferente não escreve relatório; ele carimba cada item do checklist com um grau de certeza.
É literalmente isso. São três primitivas: noul (sim ou não, com probabilidade), choice (escolha entre 2 e 255 opções, com as probabilidades de todas) e score (nota numa rubrica ordenada). Toda resposta volta com uma confiança entre 0 e 1 — o que permite mandar o caso ambíguo para uma pessoa em vez de decidir no escuro.
O número que organiza a proposta é este: até 1.000 perguntas independentes por requisição, sobre uma única entrada de até 256 mil tokens. O material é cobrado uma vez; cada pergunta acrescenta só o texto da instrução e dos critérios. Em vez de gerar resposta token por token, o modelo pontua as opções numa passada só de cálculo.
Os números que o Google publicou
Do anúncio, sem arredondar para o lado bonito:
- 150 a 250 ms de ponta a ponta, dos quais 50 a 100 ms são conta do modelo;
- latência quase plana de 1 a 100 perguntas por requisição;
- US$ 0,10 por milhão de tokens de entrada e zero token de saída cobrado;
- “quase 5× mais barato” que o Gemini 3.5 Flash-Lite com a Interactions API, no conjunto de benchmarks que o próprio Google montou.
O texto também lista usos internos. O Gemini Notebook usa a API como roteador em tempo real — classifica a intenção em milissegundos e serve consultas simples com até 40% menos latência, guardando os modelos de raciocínio profundo para o difícil. O CC, do Google Labs, escolhe a reação certa num palheiro de mais de 200 emojis. E a busca usa a mesma API como camada de segurança contra comportamento adversarial em ferramentas MCP.
A letra miúda da latência
Aqui está a primeira coisa que a manchete não conta. A entrada aceita até 256 mil tokens, mas a frase sobre latência “quase plana” tem um recorte: ela vale “em entradas multimodais e contextos de até 16 mil tokens”. São dois números diferentes na mesma página, e é fácil ler um pelo outro.
Traduzindo: até 16 mil tokens — uma gravação longa ou um contrato inteiro — a conta não cresce quando você empilha perguntas. Acima disso, o anúncio não promete planura nenhuma: quem quer 200 mil tokens de PDF e mil perguntas no mesmo pedido tem de medir o próprio tempo.
Na tabela do próprio Google, ele não lidera tudo
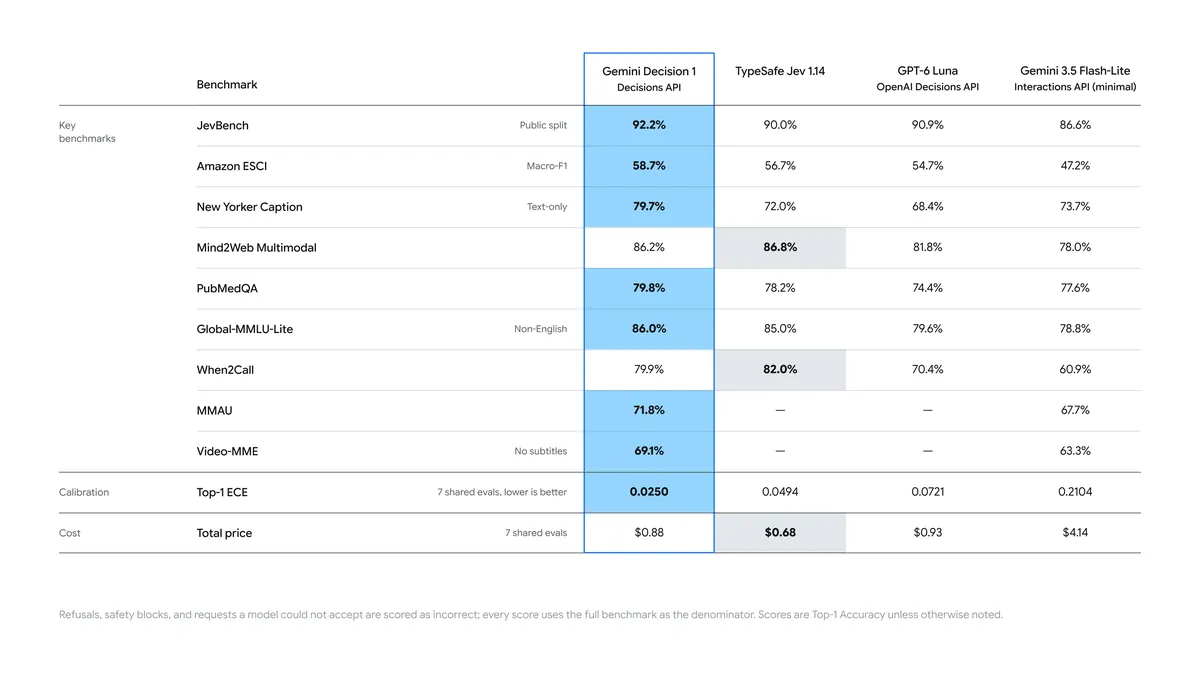
O gráfico de benchmarks da página é o documento mais interessante do anúncio — porque nele o Google colocou os concorrentes lado a lado, com nome e preço. São quatro colunas: Gemini Decision 1, TypeSafe Jev 1.1.4 (o modelo da startup que criou a categoria), o Decisions API da OpenAI (rodando o GPT-6 Luna) e o Gemini 3.5 Flash-Lite na Interactions API.
O texto diz que o Decision 1 “lidera em toda a suíte, com o menor erro de calibração”. O erro de calibração é o único ponto em que ele ganha com folga e sem asterisco: 0,0250 contra 0,0494 do Jev, 0,0721 do Luna e 0,2104 do Flash-Lite. Numa API em que a confiança decide se o caso vai para um humano, esse é o número que mais importa — e nele a vantagem é real.
Mas “toda a suíte” são nove benchmarks, e o próprio gráfico mostra dois em que ele perde:
- Mind2Web Multimodal (agente em página web): 86,8 do Jev contra 86,2 do Decision 1;
- When2Call (quando interromper uma conversa): 82,0 do Jev contra 79,9 do Decision 1.
E há uma linha de preço no mesmo gráfico, calculada sobre os sete testes que os quatro modelos conseguem fazer: US$ 0,88 o Gemini Decision 1, US$ 0,68 o Jev, US$ 0,93 o Luna e US$ 4,14 o Flash-Lite. Ou seja, o “5× mais barato” fecha contra o 3.5 Flash-Lite (4,7×, na conta do próprio gráfico), mas o modelo que o Google escolheu comparar não é o mais barato da comparação — ele custa 29% mais que o Jev. O Jev também cobra zero pela saída e lista US$ 0,042 por milhão de tokens de entrada no catálogo do OpenRouter, menos da metade do preço do Google.
A categoria que a gente cobriu primeiro virou endereço padrão
Um detalhe na documentação explica o momento melhor que qualquer benchmark: o guia do OpenRouter registrava, em 16 de outubro, 22 modelos de decisão de 13 fabricantes — todos atrás da mesma Decisions API, com nomes como OpenAI, Microsoft, Perplexity, Cloudflare e Liquid AI. O formato da chamada virou interface comum antes de virar padrão de qualidade.
A TechCrunch conta o lado do mercado: a TypeSafe, dona do Jev, virou empresa de US$ 7,6 bilhões; o Decisions API da OpenAI, anunciado no Dev Day de 29 de setembro, abriu para todos os clientes em 22 de outubro. O Google chegou 57 dias depois do acesso antecipado do Jev, com uma vantagem clara em multimodalidade e uma desvantagem clara em preço.
A nossa medição: 518 ms por decisão, 10 de 10 rotas certas
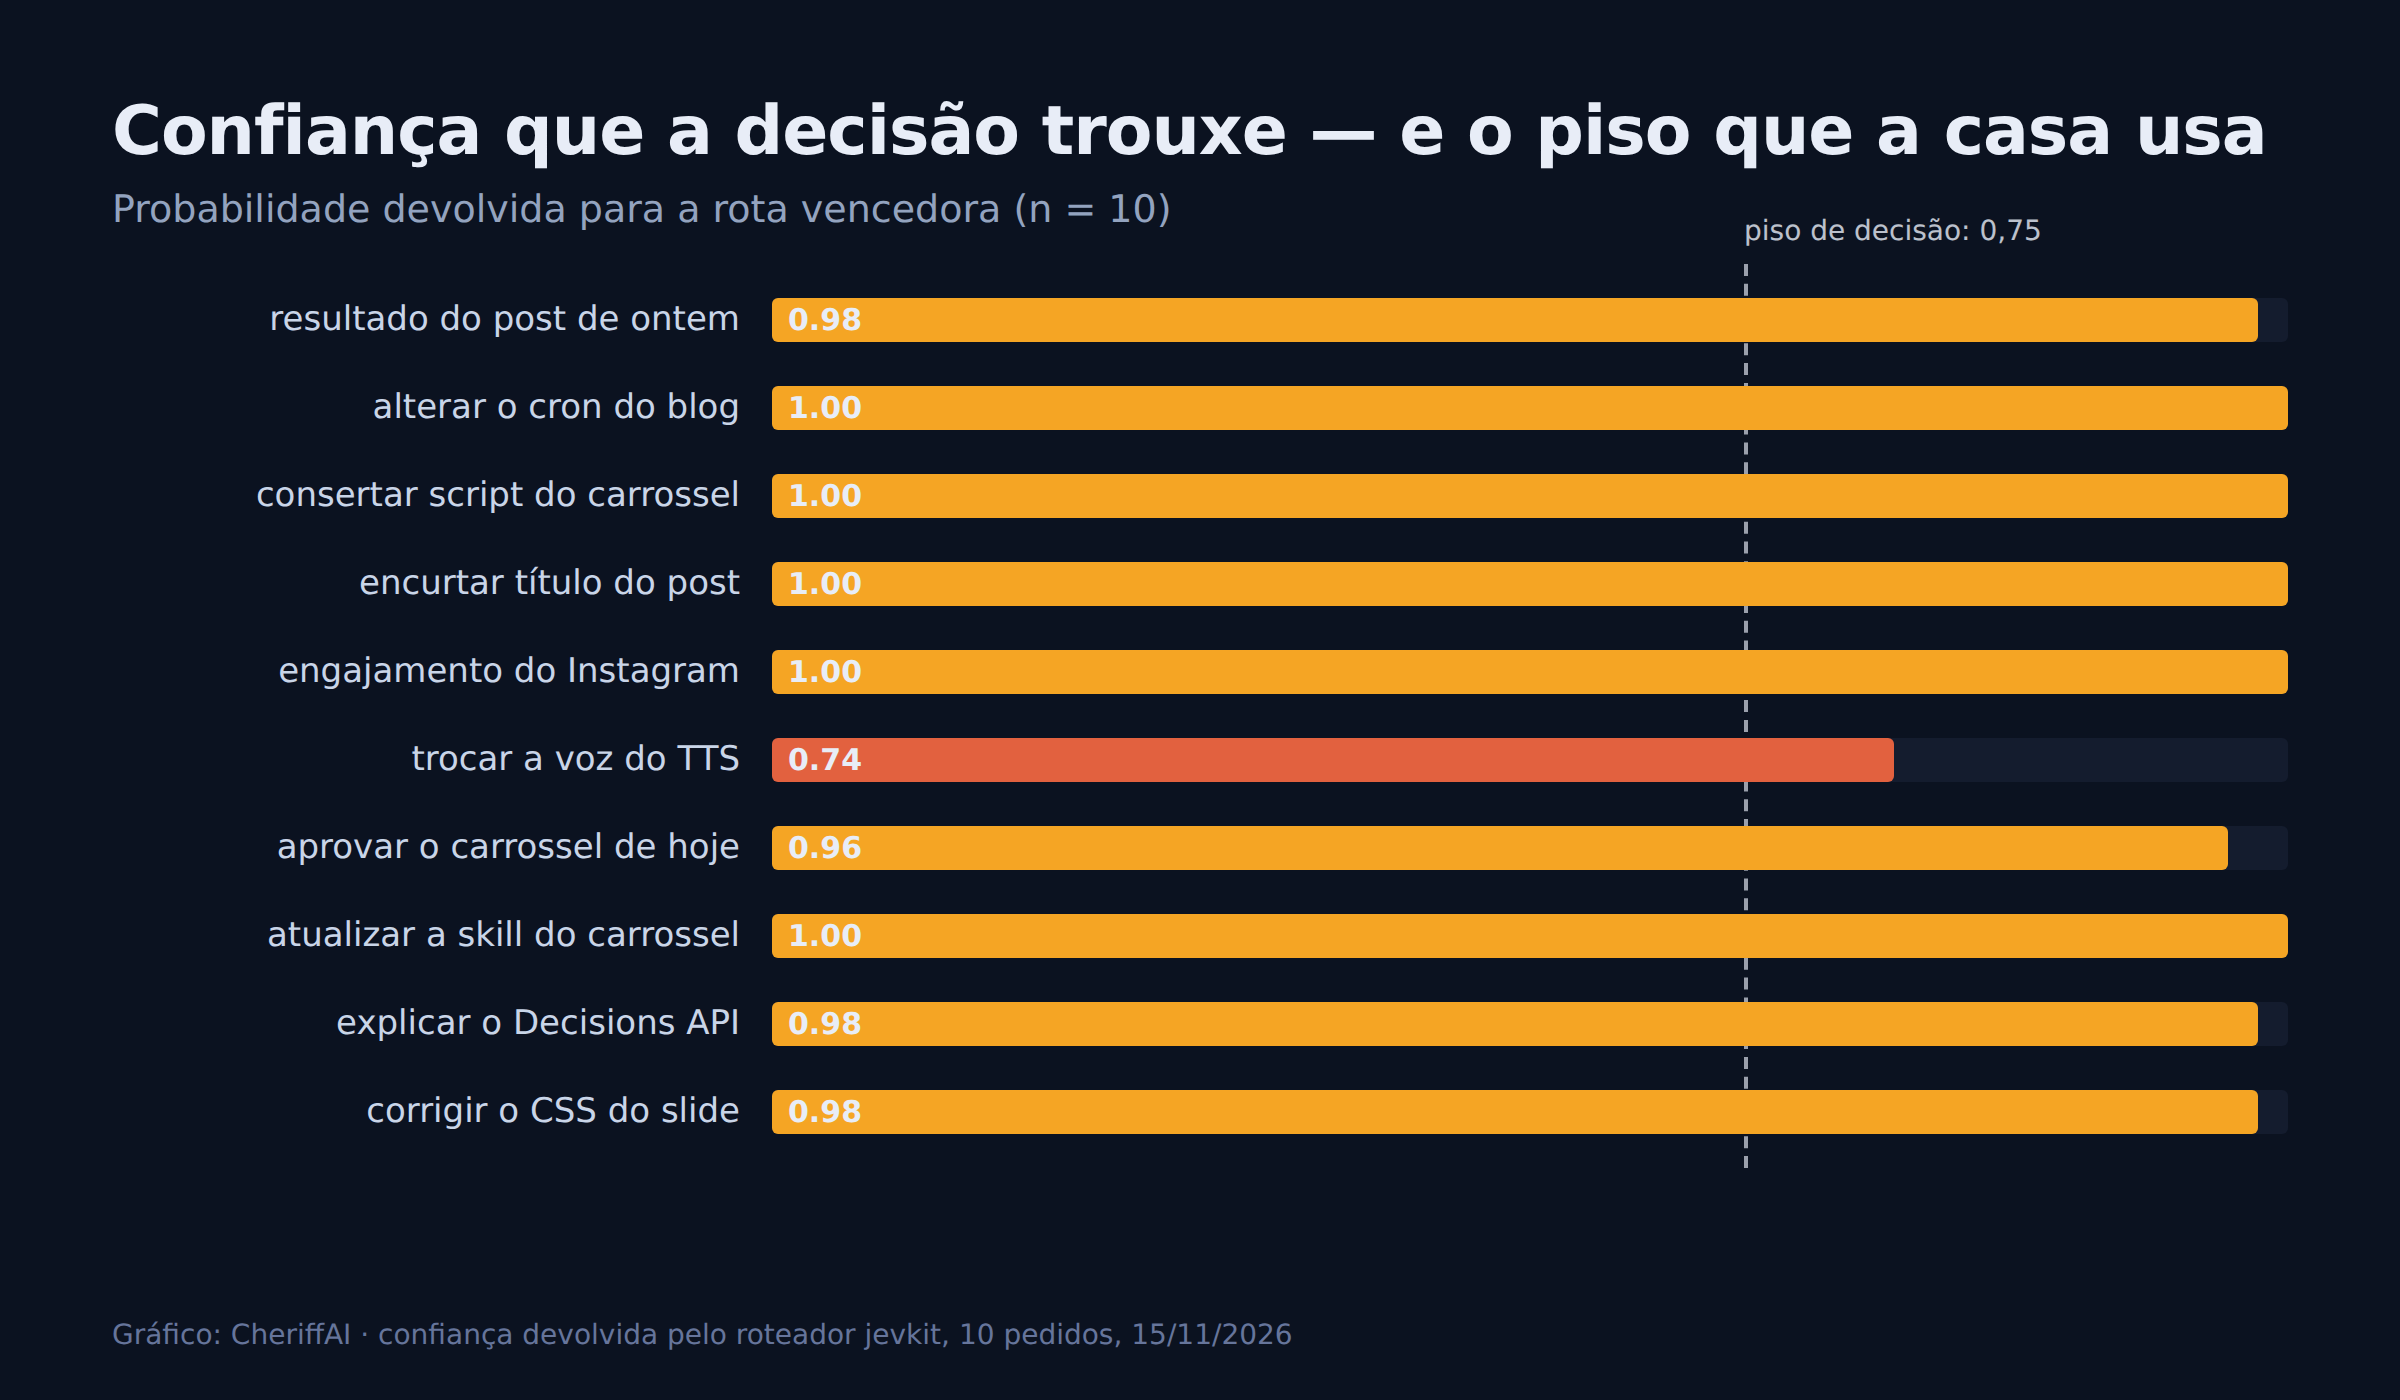
A CheriffAI usa esse desenho na prática, todo dia. O roteador de modelo deste perfil — script jev_rota.sh, que decide se um pedido vai para conversa rápida ou para o modelo caro que mexe em código — é exatamente uma decisão de escolha: duas opções (opus ou flash), com probabilidade em cada uma, e um piso de confiança de 0,75 abaixo do qual a resposta não deveria ser levada a sério.
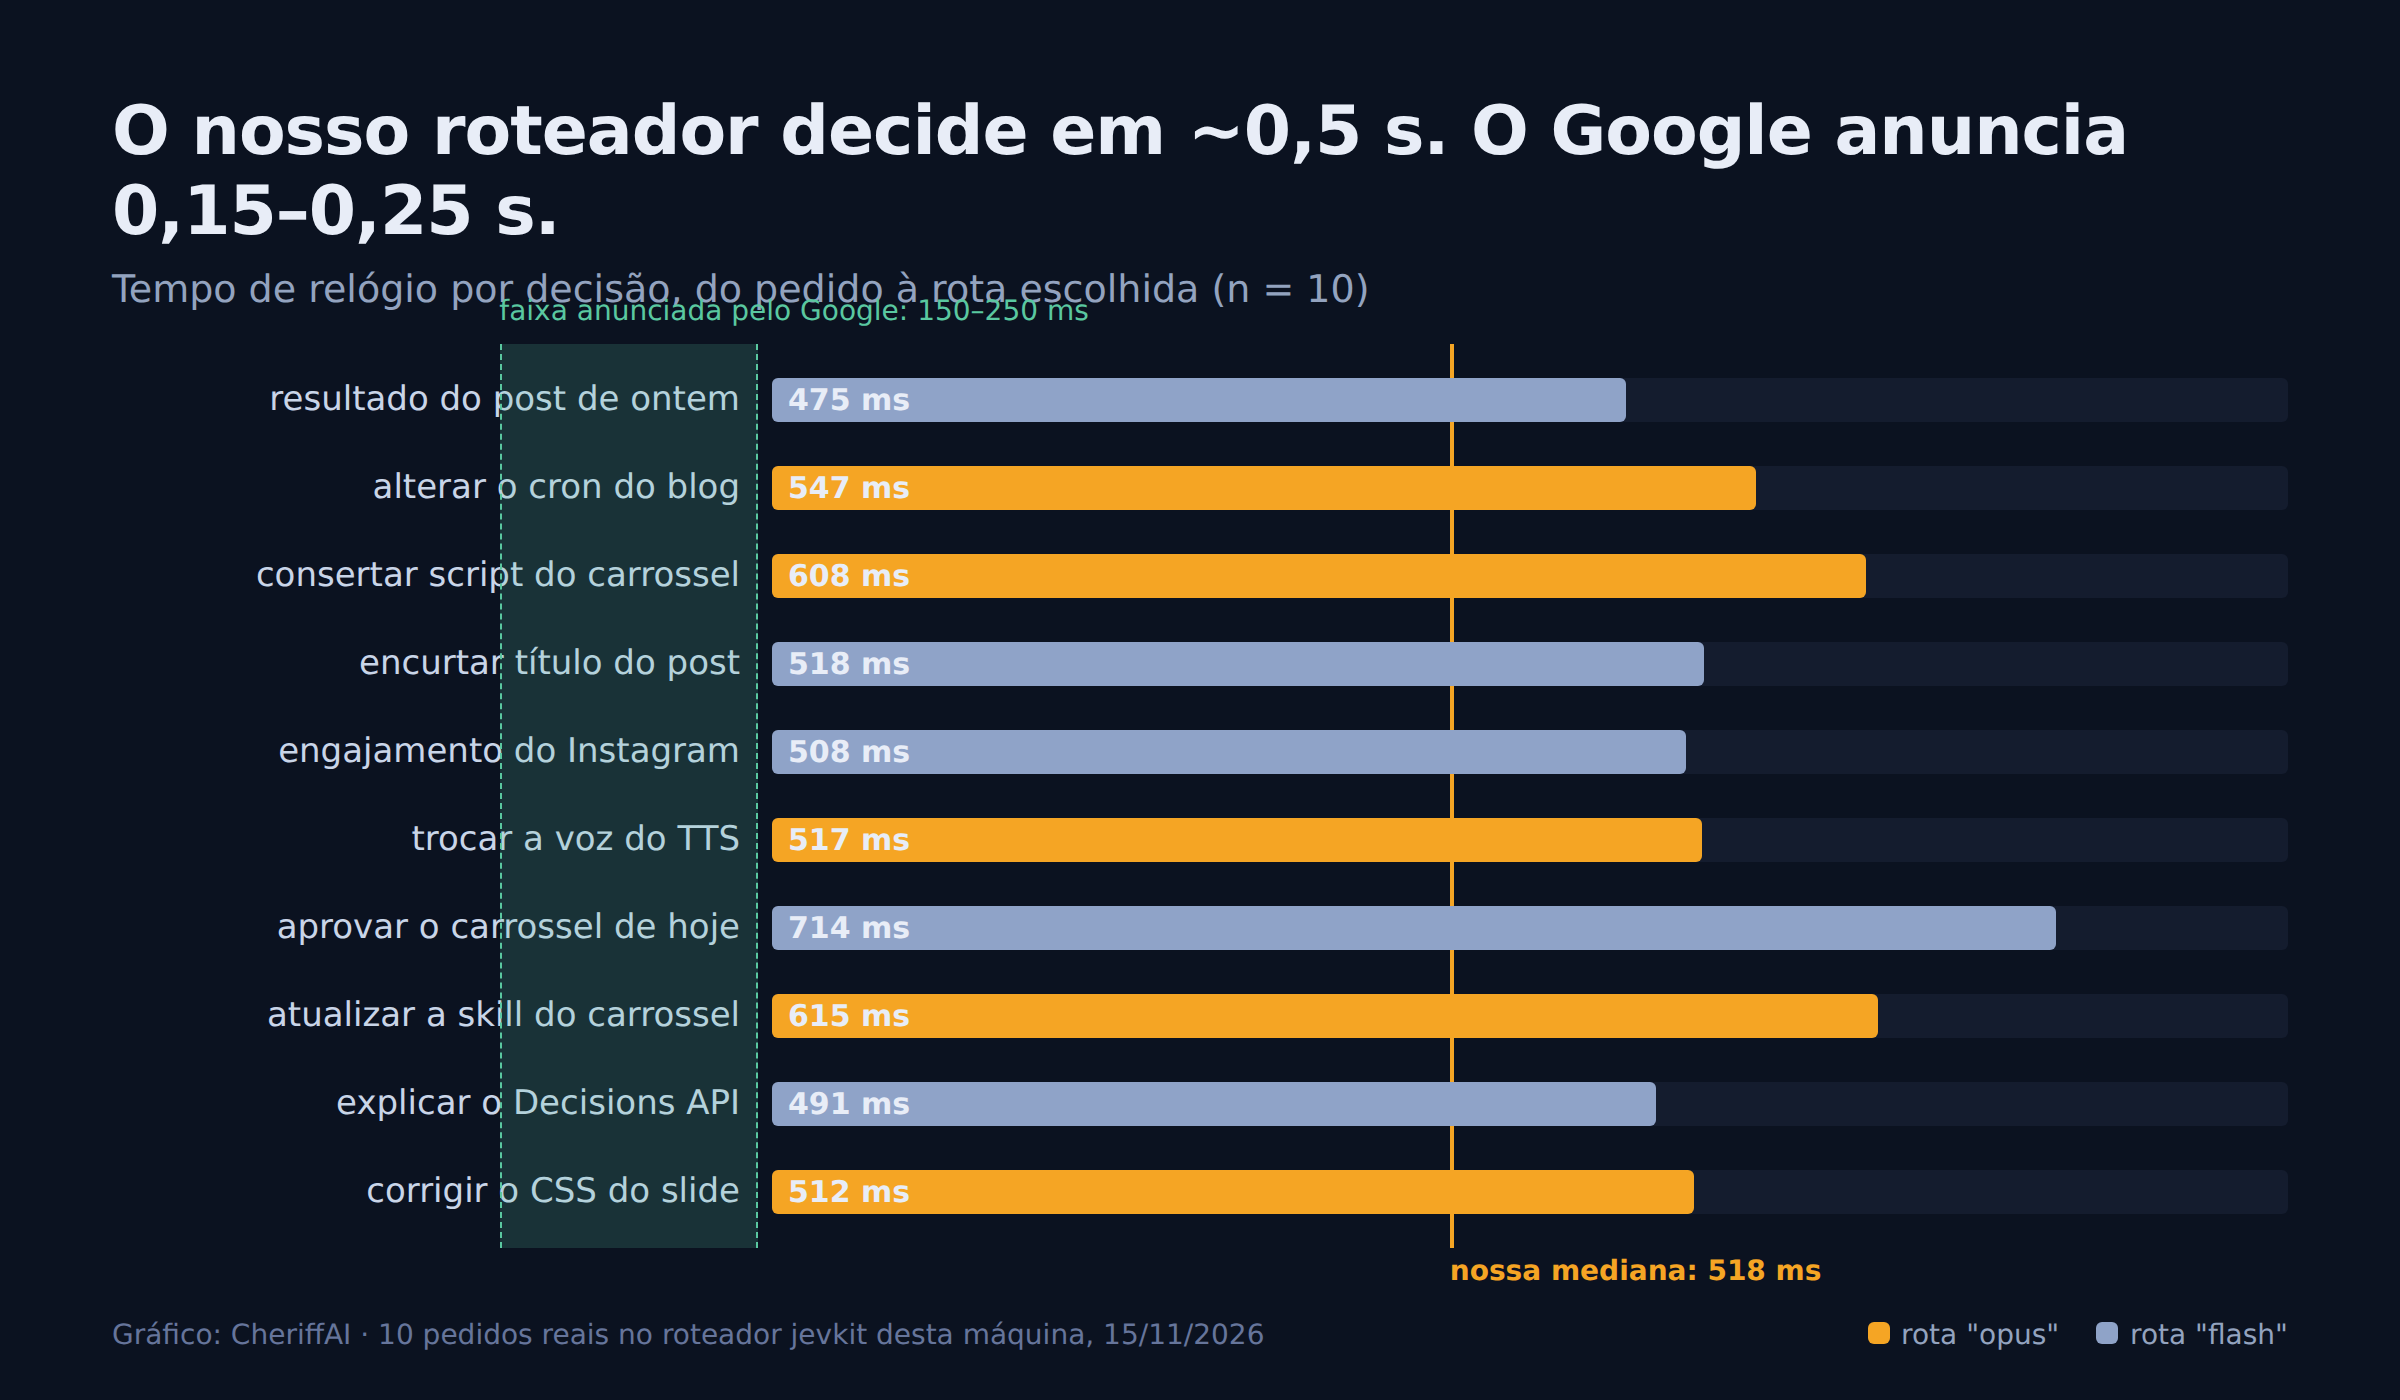
O motor não é o mesmo do Google: o nosso roda local, num modelo pequeno, sem chamada de nuvem. Então o número não é comparável em igualdade de condições — e é justamente por isso que vale publicar. Rodei 10 pedidos reais pelo roteador hoje, cronometrando o relógio de parede:
- mediana de 518 ms por decisão (mínimo 475 ms, máximo 714 ms, média 550 ms);
- a faixa anunciada pelo Google é de 150 a 250 ms — de 2 a 3,5 vezes mais rápida no papel;
- a rota escolhida foi a que eu teria escolhido à mão nos 10 casos;
- e o custo por decisão aqui é zero: roda na máquina, o texto não sai de casa.
A parte mais útil da medição não foi o tempo — foi a confiança. Nove dos dez casos vieram com probabilidade igual ou acima de 0,96: o roteador tinha certeza. Um caso veio com 0,74, logo abaixo do piso que a casa usa: “troca a voz do TTS para o perfil novo”. A rota escolhida estava certa, mas a certeza não estava — e num sistema de verdade é aí que você para e chama alguém. O campo de confiança só vale alguma coisa se o código que o consome souber o que fazer quando ele é baixo.
O que muda na prática
Três coisas, na ordem em que elas economizam dinheiro.
Um: cobrança por pergunta deixou de ser o gargalo. Um exemplo trabalhado que circulou esta semana, aplicando o preço do Google: 20 checagens sobre um registro de 4.000 tokens sai por cerca de US$ 0,50 por mil registros, contra US$ 8,10 no caminho antigo de uma chamada generativa por pergunta — porque a entrada é cobrada uma vez só. É a diferença entre auditar 1% e auditar tudo.
Dois: confiança calibrada é o que separa automação de aposta. 0,025 de erro de calibração quer dizer que quando o modelo diz “80%”, dá para planejar em cima. Um classificador que erra a própria confiança obriga você a revisar 100% dos casos — e aí o ganho de tempo desaparece.
Três: para o que não é decisão, não use. Escrever, resumir, redigir e-mail, conversar: nada disso é decisão fechada. A recomendação que a própria TypeSafe faz — o modelo de decisão decide, o modelo de linguagem escreve — é a arquitetura que faz sentido, e é o oposto de trocar o chatbot pelo conferente.
E no Brasil
Para quem tem dado de cliente no meio do caminho, a pergunta não é latência: é onde o texto vai parar. Triagem de laudo, classificação de chamado, checagem de política interna — tudo é decisão fechada, e é o tipo de dado que a LGPD manda segurar. A rota local existe e é mais lenta: o nosso roteador faz em 518 ms o que o Google anuncia em 150 a 250 ms. Para um humano esperando na tela, 300 ms de diferença é invisível; para um pipeline de 50 mil registros, é a conta que decide o projeto.
O que muda de verdade em 11 de novembro de 2026 é que a decisão virou commodity com preço de tabela. Quando a categoria nasceu, há dois meses, era startup de um pesquisador e clone aberto no fim de semana. Hoje são 13 fabricantes na mesma interface, dois bilhões de dólares de avaliação e a letra miúda de sempre: lidera em sete de nove, é o mais calibrado da turma e não é o mais barato. Quem mede, escolhe. Quem só lê o título, paga.
Fontes
- Google — “Gemini Decisions API: Fast, calibrated multimodal decisions” (11/11/2026)
- Google AI Studio — documentação da Decisions API
- OpenRouter — guia do Jev (TypeSafe) e catálogo de modelos de decisão (16/10/2026)
- TechCrunch — “OpenAI makes its Jev competitor widely available as decision model competition heats up” (22/10/2026)
- Tech Times — exemplo de custo de 20 checagens por registro (13/11/2026)
- AI Search — “Gemini 4 Carbon, Alpha Genome 2… AI NEWS” (15/11/2026), de onde saiu a pauta