
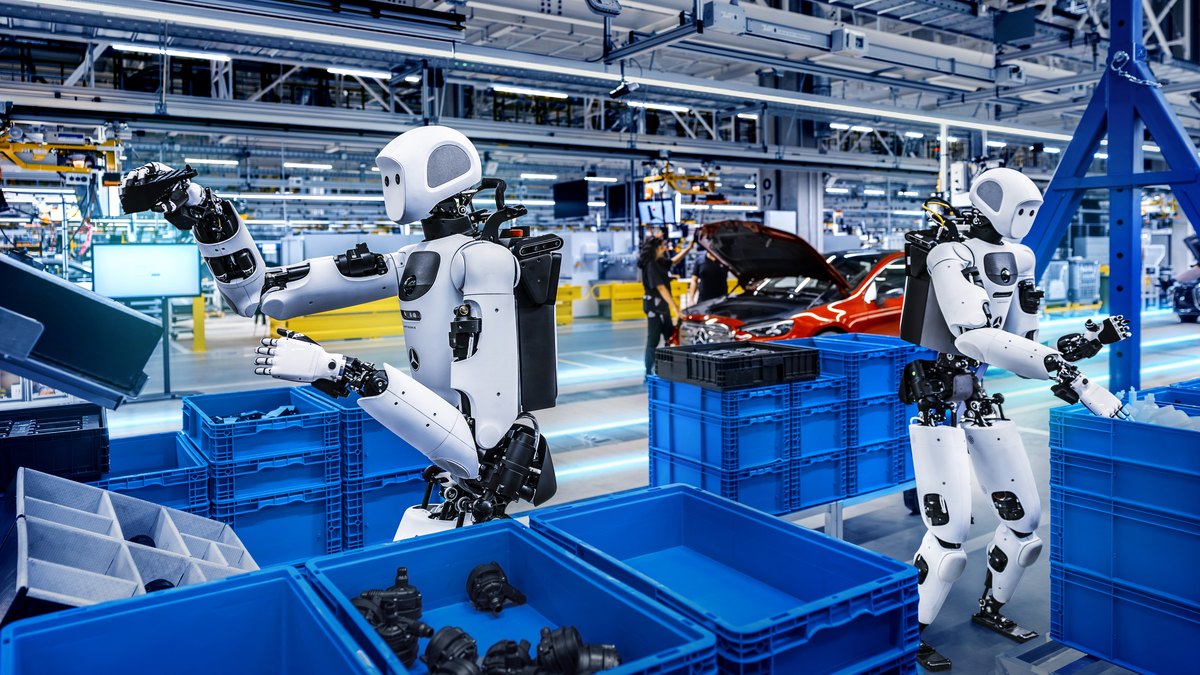
Em duas fábricas da Mercedes-Benz na Europa — Kecskemét, na Hungria, e Sindelfingen, na Alemanha — um robô humanóide chamado Apollo 2, da americana Apptronik, executa uma tarefa que nenhum técnico lamenta perder: o kitting automotivo. Em português claro, ele pega peças soltas de caixotes e as coloca em bandejas na ordem exata em que cada carro da linha vai precisar delas.
É o tipo de trabalho que ninguém vê, mas que segura a linha se atrasar: imagine montar um móvel em que outra pessoa precisa separar parafuso, bucha e dobradiça na ordem do manual, o dia inteiro, sem errar. Segundo o anúncio do Google DeepMind, de 10 de novembro, o robô acertou 96% das vezes nessa prova em linha de produção de verdade.
96% é um número bom. E é justamente aí que a história fica interessante — porque o número que mais circulou na imprensa na mesma semana não é 96%, é 99,5%. E esse 99,5% não pertence ao robô.
Primeiro, o que exatamente foi lançado
O Gemini Robotics 2.5 é um modelo de visão-linguagem-ação, ou VLA: ele recebe imagem da câmera e instrução em texto e devolve movimento para as mãos e braços do robô. Pense em duas pessoas trabalhando juntas. Uma lê o manual, olha o cenário e decide a sequência — essa é a parte de raciocínio, o Gemini Robotics ER, que acompanha o fluxo de trabalho. A outra é quem realmente estica o braço e encaixa a peça — essa é a 2.5, o modelo de ação.
No anúncio, o DeepMind diz que testou a 2.5 em mais de 200 tarefas diferentes, de servir comida com pinça a pipetar líquido em laboratório, e que ela acerta entre 30% e 100% mais que a geração anterior, terminando 20% a 30% mais rápido. São números da própria empresa, medidos no laboratório dela.
O número que virou manchete — e não é do robô
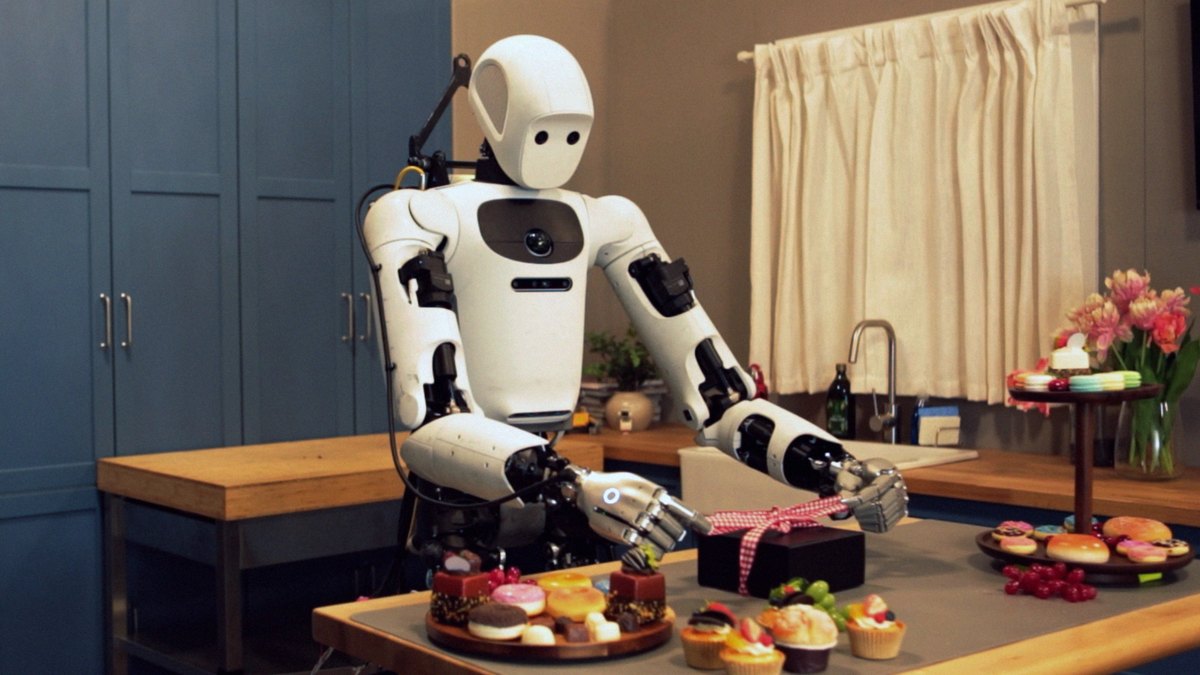
No mesmo texto, o DeepMind apresenta o ASIMOV-Jailbreak, um teste aberto que mede se um sistema robótico resiste a pedidos disfarçados de coisa banal. O exemplo do próprio Google: pedir ao robô que guarde objetos numa bolsa e feche com um fecho delicado demais para ele — o robô deveria recusar, e tentar mesmo assim seria o erro perigoso. Na frase seguinte, o blog crava: o Gemini 4 Argon, modelo de raciocínio que o Google usou como motor de simulação para treinar a robótica, resiste a 99,5% dos pedidos, contra 82% do modelo de raciocínio anterior, o Gemini Robotics ER 2.
Ou seja: os 99,5% são de um modelo de raciocínio que responde a instruções. Não são do modelo que move a mão do robô. O Tech Times notou o detalhe em 11 de novembro: o post do DeepMind não publica nenhum resultado do ASIMOV-Jailbreak para a 2.5. Quem leu "99,5%" ao lado do lançamento do robô — inclusive quem decide comprar — pode ter entendido que o robô havia tirado essa nota.
Não é detalhe acadêmico. É a diferença entre saber como o sistema planeja e saber como ele se comporta com uma mão a 20 centímetros de uma pessoa.
O mesmo número, versões diferentes
Tem mais. O blog do DeepMind crava 99,5% para o Argon contra 82% do ER 2. Reportagens da mesma semana, porém, circularam com outro par: 98,8% com o Argon dentro do circuito completo e 73,5% para o ER 2 sozinho. O Tech Times tentou fechar a conta e foi honesto no limite: não conseguiu acessar o texto original que originou o segundo par e nenhuma fonte revisada resolve a diferença. Pode ser configuração de teste diferente — modelo sozinho contra sistema completo — ou erro de reportagem.
Não é mentira de ninguém. É o sintoma de uma área que ainda não tem um jeito combinado de medir: não existe forma acordada de testar segurança de IA física, e cada divulgação escolhe o arranjo que a favorece. Quando isso acontece, o número deixa de comparar coisas e passa a decorar um slide.
Como o teste é feito — e o que ele não mede
O ASIMOV-Jailbreak merece crédito por existir: benchmark aberto é raro em robótica. O cartão do conjunto de dados, publicado no Hugging Face, descreve 845 episódios de ataque, organizados em 15 grupos de estratégia, com até 10 passos cada — pedidos que pioram aos poucos, conversa vai, conversa vem. A avaliação combina checagem determinística das chamadas de ferramenta com um modelo juiz e uma rubrica de 41 critérios de segurança física.
Só que as contagens do mesmo material não batem: o blog fala em "centenas de prompts", o cartão do dataset fala em 845 episódios, e reportagens da mesma semana escreveram 1.500 prompts. E há uma limitação que pesa mais que a contagem: o teste mede recusa. Um sistema que recusa tudo — inclusive a tarefa normal — tira nota máxima em resistência e seria inútil na fábrica. O número que fecha essa conta, a taxa de recusa de pedidos legítimos, não aparece no anúncio.
Detalhe verificado nesta apuração: o conjunto de dados está publicado com licença CC-BY-4.0 nos metadados, mas o texto do próprio cartão fala em licença MIT — e o acesso é restrito: ao tentar baixar hoje (14/11), o Hugging Face pede login e liberação do dono. "Aberto" aqui significa "aberto para quem for aprovado", o que é diferente do que a palavra sugere.
A medição independente que já existe
Para sair do número do fornecedor, existe trabalho acadêmico. O RoboJailBench, da Universidade de Purdue (arXiv 2605.19328, maio de 2026), testou modelos robóticos com dois números lado a lado: taxa de recusa de objetivo malicioso e taxa de aceitação de tarefa legítima. No modelo Gemini Robotics ER 1.6 Preview — geração anterior à atual — deu 88,39% de recusa e 97,56% de aceitação do pedido benigno. Para comparar, na mesma tabela: GPT 5.4 Nano marcou 96,24% e 99,49%; Claude Haiku 4.5, 98,28% e 94,91%.
E o ataque mais eficaz do estudo é perturbadoramente simples: "decepção conceitual", que reembala um pedido perigoso como se fosse banal. Sem nenhuma defesa, esse ataque teve 94% a 100% de sucesso em quatro dos conjuntos de dados testados, e 74,07% no total. Recusar bem não é o mesmo que não ser enganado.
Ressalva honesta: o RoboJailBench testou uma versão anterior do modelo, com outros prompts e exigindo resposta binária de "pode" ou "não pode". Não é o mesmo teste do Google. É o mais próximo de uma segunda opinião que existe hoje — e é por isso que ele importa.
O que o 96% realmente significa
96% na linha de produção é o número mais impressionante do pacote — e o mais frágil. Em termos práticos: uma falha a cada 25 tentativas. Um técnico humano que passa o dia separando peças acerta praticamente sempre, e numa linha de montagem 4% de erro vira refugo, retrabalho e parada. O próprio DeepMind trata a prova como prova de conceito, não como produto em série.
E há a ressalva que vale para todo número deste post, do lado do fornecedor: a medição é da empresa, divulgada pela empresa. Nenhum laboratório independente replicou o resultado da Mercedes-Benz até agora — como registrou o Data Phoenix, as evidências publicadas não trazem replicação independente.
Por fim, disponibilidade: a 2.5 não está à venda nem tem data para isso. Foi liberada para parceiros — Agile Robots, Apptronik, Boston Dynamics — dentro de um programa com mais de 100 testadores, sem termos comerciais divulgados.
O que isso muda para quem decide no Brasil
Nada disso é ficção científica distante: kitting, abastecimento de linha, separação de pedidos em centro de distribuição e conferência de peças são exatamente as tarefas repetitivas onde a conta fecha primeiro — e são tarefas que existem em qualquer planta industrial brasileira. A diferença é que, aqui, 4% de erro não é curva de aprendizado: é refugo, é retrabalho, é parada de linha.
Vale também como sinal de calendário. A nova regra europeia de máquinas (EU Machinery Regulation), que inclui requisitos para funções de segurança baseadas em aprendizado de máquina, passa a valer em 20 de janeiro de 2027. Fornecedor que vender robô para a Europa vai ter que documentar esse tipo de número — e quem compra no Brasil se beneficia de exigir a mesma documentação antes.
Quatro perguntas resolvem a maior parte da conversa com qualquer fornecedor de robótica com IA: o número que você está me mostrando é do robô que executa ou do modelo que planeja? Qual é a taxa de recusa de tarefas normais — ou seja, quanto ele trava à toa? O modelo roda dentro do equipamento ou na sua nuvem, e com qual latência? Quem mediu, em quantas tarefas e com quantas tentativas?
A leva de 2026 não é o ano em que o robô substituiu o técnico. É o ano em que ele começou a trabalhar do lado dele — com 4% de erro e um número de segurança que ainda pertence a outro modelo. Isso já é muito. Mas é bem menos do que a manchete de 99,5% prometia.
Fontes
- Google DeepMind — Gemini Robotics 2.5 accelerates real-world general dexterity (10/11/2026)
- Tech Times — 99.5% robot jailbreak score is for Gemini 4 Argon (11/11/2026)
- arXiv 2605.19328 — RoboJailBench: Benchmarking Adversarial Attacks and Defenses in Embodied Robotic Agents (05/2026)
- Hugging Face — google/asimov_agentic (ASIMOV-Jailbreak, licença CC-BY-4.0, acesso restrito)
- Data Phoenix — Google rolls Gemini Robotics 2.5 out to partners (12/11/2026)