
Na semana passada, o Qwen4-Max era o modelo mais estranho do mercado: existia, respondia, mas não tinha um único benchmark publicado, nem model card, nem preço por token, nem pesos abertos — e já vinha com data de morte marcada para 25 de novembro. Neste fim de semana a Alibaba mudou de ideia. O blog oficial do Qwen4-Max saiu na noite de domingo (15), e a API com preço por token está no ar hoje: US$ 1,50 por milhão de tokens de entrada e US$ 4,50 de saída — 25% abaixo do Qwen3.8-Max, que custava US$ 2 e US$ 6.
Junto com o preço veio o painel de benchmarks que faltava. E é aí que o post começa de verdade: o painel é feito quase todo de testes de terceiros, mas quem escolheu quais testes aparecem foi a parte interessada. Quando você olha o painel inteiro — e não só os números da manchete — o retrato muda.
O que a Alibaba entregou
Tecnicamente é o maior modelo já lançado pela empresa: 2,4 trilhão de parâmetros no backbone, 71 bilhões ativos por token e mais 328 bilhões de parâmetros de embedding N-gram, segundo o próprio anúncio. A arquitetura nova junta Gated DeltaNet (que comprime o histórico em estados de tamanho fixo) com uma atenção esparsa que usa um indexador leve para escolher pedaços de contexto, além de ramos residuais com portões dinâmicos. Na prática: 1 milhão de tokens de contexto, visão nativa e entrada de vídeo, com saída de até 262 mil tokens somando raciocínio e resposta.
O número que a Alibaba colocou no centro do anúncio é de custo: a conta média por tarefa no Work360 caiu de US$ 4,43 para US$ 1,67, uma redução de 62% contra o Qwen3.8-Max. Ela vem de dois lugares: preço por token 25% menor e menos tokens gastos no mesmo trabalho — 24% a 35% menos no Work360, 48% a 49% menos no Terminal-Bench 4.0. O cache implícito também despencou, de US$ 0,25 para US$ 0,075 por milhão de tokens.
Só que “menos tokens que o modelo anterior” não é a mesma coisa que “poucos tokens”. Voltamos nisso já já.
O painel: dois lados da mesma tabela
O anúncio traz um painel de comparação direta com o Claude Opus 5.5, o GPT-6.1 Sol e o Kimi K3.1 Pro. Nas notas de rodapé, a Alibaba é transparente sobre a origem: os resultados de AA-Briefcase e AutomationBench-AA são citados da Artificial Analysis, os de HLAB-Vals vêm do índice da Vals, os de AgentArena vêm da Arena. São benchmarks de terceiros, reunidos por quem está sendo avaliado.
E a seleção funciona. Em DeepSWE v1.1, o Qwen4-Max marca 75,7 contra 74,2 do Opus 5.5 e 75,2 do GPT-6.1 Sol — primeiro lugar por meio ponto. Em Agents' Last Exam, 46,7 contra 43,4. Em HLAB-Vals, 21,3 contra 9,2. Em BioMysteryBench, 85,0 contra 81,9. É o material da manchete.
No mesmo painel, porém, o Terminal-Bench 4.0 — o teste de agente de longa duração, o que mais se parece com “deixar a IA trabalhar sozinha” — marca 48,5 para o Qwen4-Max e 59,6 para o Opus 5.5. O Kimi K3.1 Pro fica em 67,2. No ProgramBench é pior: 31,5 contra 65,0 do Opus. Em HealthBench Professional, 60,0 contra 65,1. Em Chartography, 54,2 contra 66,3. Contando os 16 testes do painel, o Qwen4-Max lidera em 7 — nos outros 9, quem está na frente é o Opus 5.5.
E há vitórias que merecem ser ditas: em AA-Briefcase, o teste da Artificial Analysis para trabalho de conhecimento agêntico em arquivos de negócio reais, o Qwen4-Max marca 1686 de Elo contra 1555 do Opus 5.5. Ou seja: no trabalho de escritório com agente, ele está na frente de todos os modelos do painel. É exatamente por isso que o painel precisa ser lido inteiro, e não pela manchete.
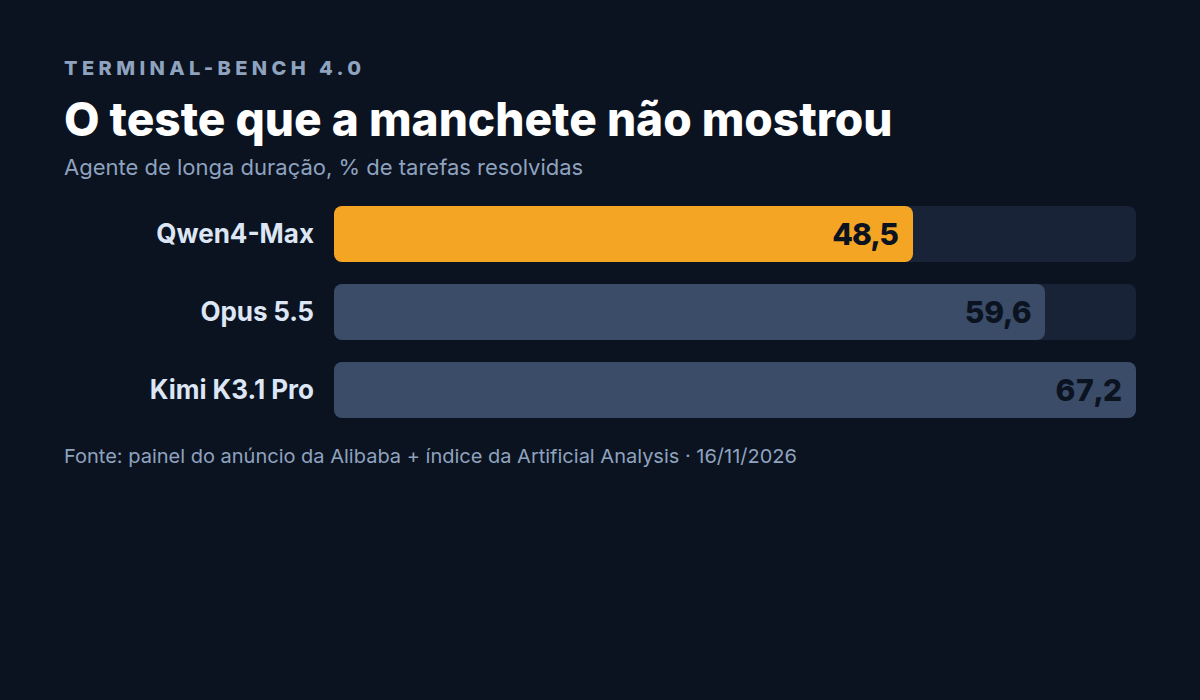
Nada disso é trapaça: mostrar os testes em que você ganha é o esporte nacional de todo lançamento de modelo, de São Francisco a Hangzhou. Mas é exatamente a diferença entre o que o fornecedor anuncia e o que a medição independente mostra — e o Terminal-Bench 4.0 é o teste que mais interessa a quem vai colocar um agente para trabalhar.
A medição independente: 38º de 81
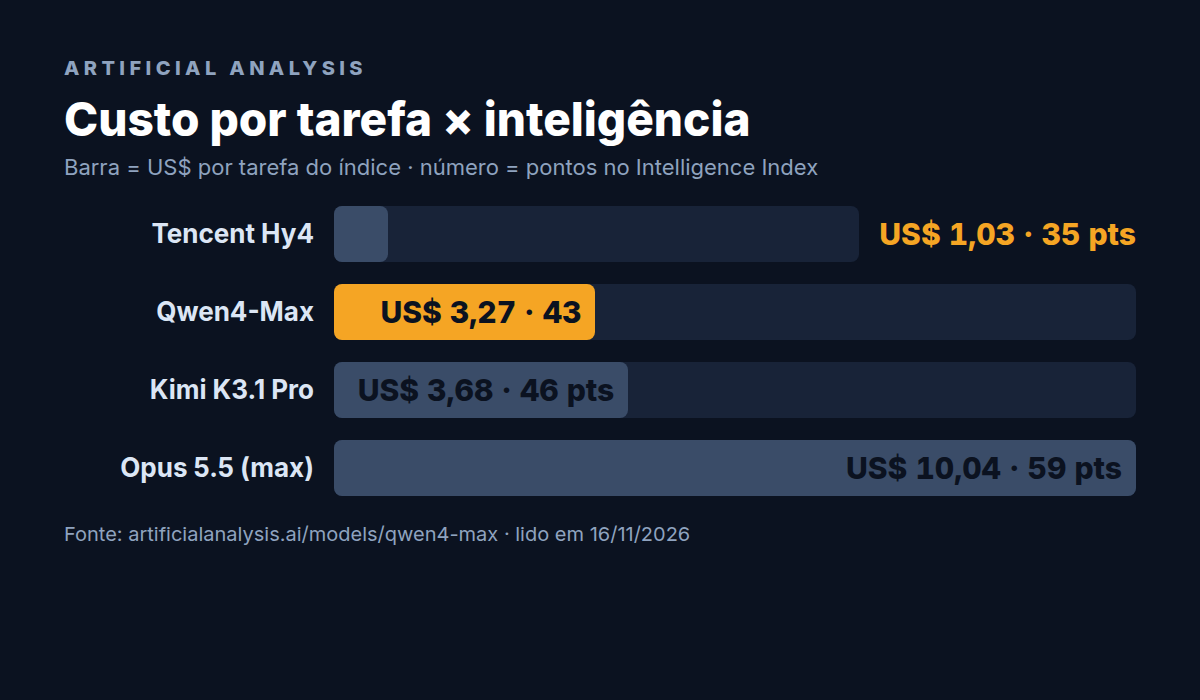
A Artificial Analysis já colocou o Qwen4-Max no ar. Lido hoje, o número principal não bate nem com o melhor nem com o pior dos cenários: 43 pontos no Intelligence Index, 38º lugar entre 81 modelos. É um salto real de 9 pontos sobre o Qwen3.8-Max (34) e fica 3 pontos atrás do Kimi K3.1 Pro (46). Está acima da mediana da faixa de preço (41), ou seja: o modelo é bom, mas não é o líder que o painel sugere.
No custo, o anúncio se confirma. A Artificial Analysis mede US$ 3,27 por tarefa do índice, contra US$ 10,02 do antecessor — 67% menos, quase o mesmo 62% que a Alibaba divulgou no Work360, agora em um conjunto de testes que ela não controla. O Kimi K3.1 Pro custa US$ 3,68 por tarefa e entrega 3 pontos mais; o Tencent Hy4 custa US$ 1,03 e entrega 8 pontos menos.
E aqui aparece o detalhe que nenhum release conta: verbosidade. A Artificial Analysis mede 127 milhões de tokens de saída para rodar o índice inteiro, contra mediana de 78,6 milhões — o Qwen4-Max é o 65º mais verboso entre 80 modelos. A economia de 39% de tokens é contra o antecessor, não contra o mercado. Para quem paga por token de saída, isso importa: US$ 4,50 por milhão em um modelo que escreve 60% mais que a média não é o mesmo que US$ 4,50 em um modelo econômico.
Um teste de código com testes ocultos
Quem quis ir além do painel do fornecedor já tem resultado. O kingy.ai rodou 16 execuções de agente de código em quatro mini-repositórios, duas tentativas para cada, com testes visíveis e ocultos: Opus 5.5 passou 8 de 8, o Qwen4-Max passou 7 de 8 (45 de 46 métodos ocultos). O Qwen gastou US$ 0,285 nas oito execuções contra US$ 1,033 do Opus — 72% menos — e foi mais lento no relógio: 56,5 segundos de mediana contra 40,2. Diferença pequena de confiabilidade, economia grande de conta. É o retrato mais honesto do momento: o Qwen4-Max é um bom modelo a um preço agressivo, não um novo líder de capacidade.
O nosso teste: 40 acertos em 40 nos três
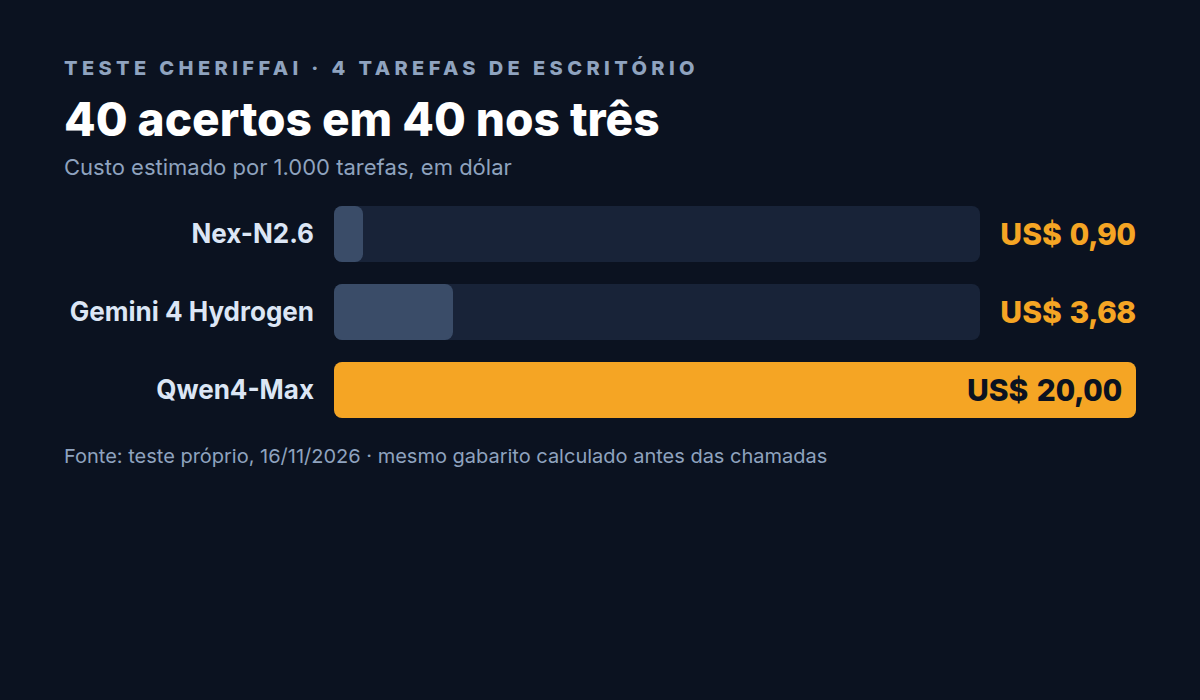
Rodamos hoje, aqui na CheriffAI, quatro tarefas de escritório — cotação de fornecedor, exceção de reembolso, ata de reunião e cálculo de SLA — em três modelos, com o gabarito calculado em código antes das chamadas. O resultado foi 40 acertos em 40 nos três modelos. Em tarefa de escritório do dia a dia, a fronteira não aparece: quem responde certo, responde certo.
A conta, porém, não empata. Levando para 1.000 tarefas: US$ 20,00 no Qwen4-Max, US$ 3,68 no Gemini 4 Hydrogen e US$ 0,90 no Nex-N2.6. A explicação é o raciocínio cobrado como saída: 95% dos tokens de saída do Qwen4-Max foram de raciocínio, contra 90% do Gemini e 71% do Nex. Ele também foi o mais rápido no relógio (50,3 s contra 68,5 s e 86,1 s no total das quatro chamadas) — modelo que pensa muito de uma vez, em vez de conversar em rodadas.
O que fazer com isso na segunda-feira
Três leituras práticas para quem está escolhendo modelo para produção no Brasil:
- Preço por token não é preço por tarefa. O Qwen4-Max é 25% mais barato por token que o antecessor e ficou 5 vezes mais caro por tarefa do que um concorrente no nosso teste — porque pensa mais antes de responder. A única métrica que vale é a sua: quantas tarefas por real, no seu fluxo.
- O painel do fornecedor é um bom ponto de partida, não uma resposta. Aqui, o teste em que o Qwen4-Max ganha é o de código em passo único e o de trabalho de escritório com agente; o que ele perde é o de agente que precisa terminar o serviço sozinho — justamente o que mais se aproxima de trabalho real. Ler o painel inteiro, e não a manchete, é o que separa avaliação de torcida.
- Self-hosting não está na mesa. O Qwen4-Max é hospedado e fechado; a Alibaba diz que os modelos menores da família Qwen4 virão com pesos abertos. Para quem precisa de dado no próprio servidor por LGPD, o caminho é esperar os pequenos ou seguir com modelos abertos de outro tamanho.
O que a Alibaba fez de fato impressionante não foi o ranking. Foi encolher a conta por tarefa em dois terços em um trimestre e colocar 1 milhão de tokens de contexto com vídeo nativo por US$ 1,50 a entrada. Para volume alto de extração, triagem e geração longa, é uma opção séria. Para o agente que precisa terminar o trabalho sem supervisão, os números de hoje ainda apontam para outro lugar.
E a lição que fica vale para todo lançamento: quando o fornecedor publica seis benchmarks e não publica o sétimo, o sétimo é o que você precisa medir.
Fontes
- Qwen — Qwen4-Max: Your New Teammate Has Arrived (15/11/2026)
- Artificial Analysis — Qwen4 Max: Intelligence, Performance & Price Analysis (lido em 16/11/2026)
- kingy.ai — Qwen4-Max vs Claude Opus 5.5: benchmarks, costs and tests (16/11/2026)
- Tech Times — Qwen4-Max-Preview retires November 25 with no benchmarks, model card or price (12/11/2026)
- ShiftDelete — Qwen4-Max cuts average task cost 62% to $1.67 (16/11/2026)
- Qwen (@Alibaba_Qwen) no X — anúncio do Qwen4-Max (16/11/2026)
- Teste próprio da CheriffAI — 4 tarefas de escritório × 3 modelos, 40/40 nos três (16/11/2026)