
Duas notícias de biologia, dois dias seguidos
Na terça-feira, 10 de novembro, uma startup chamada Geodesic Intelligence anunciou o NovaAtom-Lite, um modelo que prevê a forma tridimensional de proteínas, DNA, RNA e das moléculas pequenas que se grudam nelas. No dia seguinte, 11 de novembro, o Google DeepMind publicou o AlphaGenome 2, um modelo que lê uma sequência de DNA e diz o que ela faz dentro de um tipo específico de célula.
As duas notícias são boas — e as duas têm o mesmo defeito de fábrica: todos os números que provam que funcionam foram produzidos por quem construiu o modelo. Não é acusação, é o estado normal da área. Mas muda o que você pode concluir.
Este post olha para os dois anúncios do jeito que a CheriffAI olha para tudo: o que o fornecedor afirma, quem efetivamente mediu, e onde a conta deixa de fechar.
O problema que o AlphaGenome 2 foi resolver
Toda célula do seu corpo carrega o mesmo manual de instruções: o mesmo DNA. O que muda é qual página cada célula lê. Uma célula do músculo do coração liga um conjunto de genes; um glóbulo branco que está combatendo uma infecção liga outro. Isso é o que faz uma célula virar fígado e a outra virar cérebro.
A primeira versão do AlphaGenome, do ano passado, pegava um trecho de um milhão de letras de DNA e previa, de uma vez, milhares de experimentos de vários tecidos. Era eficiente — e o próprio DeepMind admite o custo disso, no anúncio e no relatório técnico: prever tudo em paralelo "espalhava a capacidade do modelo" e dificultava enxergar diferenças entre tipos de célula parecidos.
É a diferença entre a média da turma e a nota de cada aluno. Se você só tem a média da escola, não consegue dizer que o aluno A foi mal em matemática e que o aluno B foi bem. O AlphaGenome 1 entregava a média dos tecidos. O AlphaGenome 2 passou a entregar a nota individual.
Como o modelo ficou "condicional"
A mudança técnica tem nome simples: o modelo agora é condicional. Ele recebe duas coisas: a sequência de DNA e uma condição biológica — um tecido, um tipo de célula ou um estado de célula. Essa condição entra em todas as etapas da arquitetura, e não só na entrada. O modelo aprende como o mesmo trecho de DNA é lido de forma diferente em cada célula.
O treinamento usou mais de 107 milhões de perfis de célula única, de humano e de camundongo, em 68 tecidos. E há um detalhe que interessa a qualquer pesquisador: se o cientista tiver dados de célula única do próprio experimento — mesmo de algumas dezenas de células —, o chamado cell encoder transforma esse material numa condição nova, e o modelo passa a prever para um estado celular que nunca viu, sem treinar de novo. No anúncio, o DeepMind mostra isso funcionando com dados de um estudo de vacina de mRNA contra a covid: o modelo distinguiu células T ativadas pela vacina das células T em repouso.
Também entraram duas coisas que os geneticistas pediam havia tempo: um novo tipo de leitura, a metilação do DNA, e a capacidade de "imputar" medições que faltam — se você só tem a atividade dos genes de uma célula, o modelo estima a acessibilidade da cromatina daquela mesma célula.
O número que virou manchete — e quem o mediu
O dado que rodou o mundo: o AlphaGenome 2 identifica quase o dobro de variantes que mudam a expressão dos genes em células, comparado ao modelo anterior do próprio DeepMind.
O teste foi no TenK10K, um mapa de célula única com 28 tipos de célula imune do sangue. Ali, o modelo novo identificou 30% das variantes causais contra 16% do AlphaGenome 1 ajustado para célula única, e acertou a direção do efeito — se o gene sobe ou desce — em 43% dos casos contra 23%. O relatório técnico resume como "dobrar o recall de eQTLs causais de célula única a 90% de precisão".
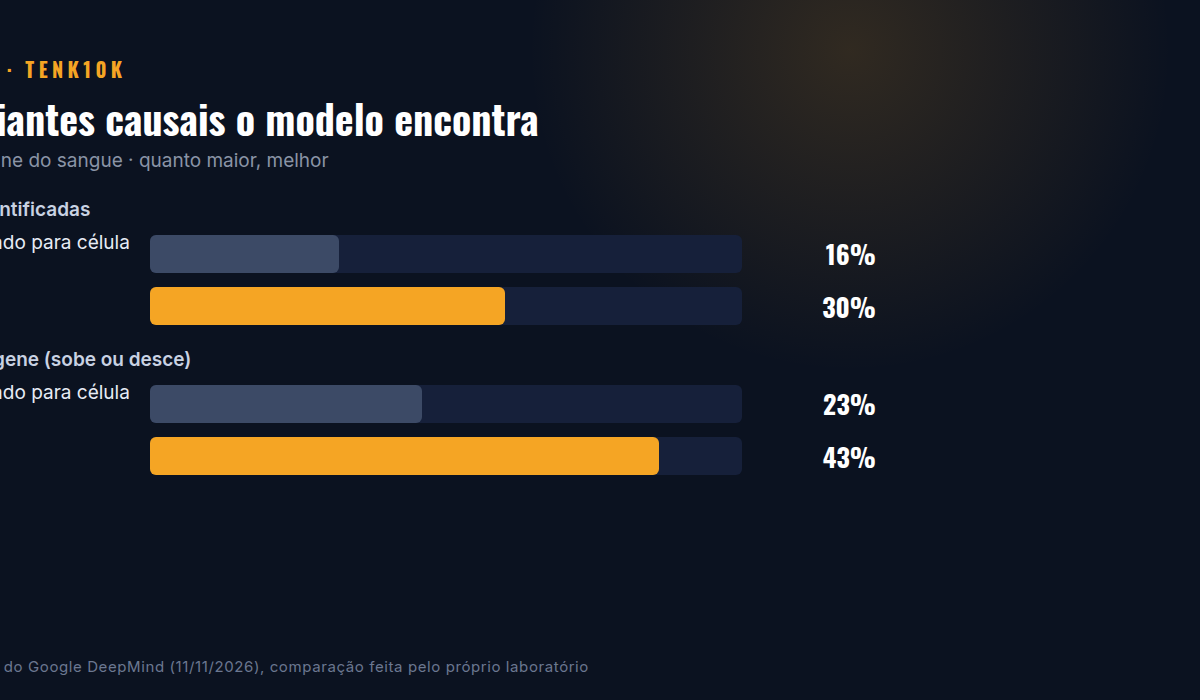
Agora a parte que o anúncio não põe em destaque: a régua é do fornecedor. O AlphaGenome 2 foi comparado ao AlphaGenome 1 ajustado e a "ferramentas especializadas" — todas avaliadas no mesmo conjunto, pelos mesmos autores, no mesmo relatório. Isso é legítimo e é o jeito normal de publicar um modelo novo. Só não é medição independente. Nenhum grupo de fora rodou o AlphaGenome 2 no TenK10K antes do anúncio.
O segundo resultado citado é uma reprodução computacional. Um estudo publicado na Nature mostrou que uma variante distante no DNA causa doença inflamatória intestinal ao exagerar a ativação do gene ETS2 em macrófagos do intestino. O AlphaGenome 2, sozinho, apontou a variante e mostrou que ela mexe no ETS2 só naquele tipo de célula. É um bom sinal — o modelo reencontrou um achado que levou anos de bancada. Mas reencontrar não é descobrir, e o anúncio é claro: as previsões estão sendo comparadas com o que já se sabia.
A segunda notícia: a startup que diz bater o AlphaFold 3
No mesmo dia 10, a Geodesic Intelligence apresentou o NovaAtom-Lite, que olha para o outro lado da biologia: em vez de prever o que um trecho de DNA faz, ele prevê o formato físico das moléculas — cada átomo pesado de proteínas, DNA, RNA e ligantes, com confiança por resíduo e por interface.
O número do anúncio é forte. No FoldBench, na tarefa de interface entre anticorpo e antígeno, o NovaAtom-Lite acertou 79,07% das 172 interfaces (critério DockQ de 0,23 ou mais), escolhendo a melhor entre 25 previsões por alvo. A comparação vem em três linhas: IsoDDE 75,58%, AlphaFold 3 47,90%.
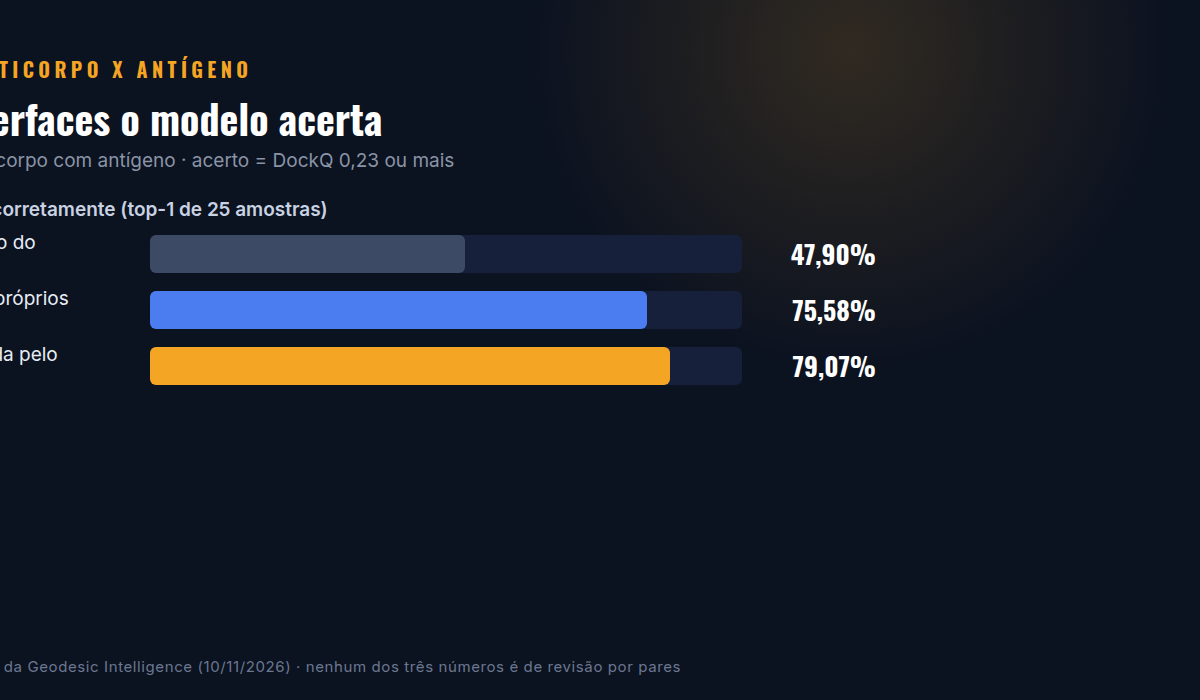
Aqui a honestidade do anúncio merece crédito, porque ele diz exatamente quem mediu o quê: o número do NovaAtom-Lite é "our run, scored with FoldBench's official evaluation" — rodado por eles, pontuado pela métrica oficial do benchmark. O do IsoDDE é "as reported by its developers" — ou seja, o número que os próprios concorrentes publicaram. E o do AlphaFold 3 é a avaliação do próprio FoldBench, que conseguiu avaliar 167 das 172 interfaces.
Duas assimetrias ficam visíveis quando você lê com cuidado. Primeira: o denominador muda. São 172 interfaces para o NovaAtom-Lite e 167 para o AlphaFold 3 — os cinco casos que o benchmark não conseguiu avaliar no AF3 simplesmente não entram na conta dele. Segunda: a tarefa. O AlphaFold 3 é um modelo de propósito geral; o NovaAtom-Lite foi desenhado e afinado justamente para interfaces de anticorpo, que é onde a diferença aparece. Comparar um especialista com um generalista no exame do especialista é uma pergunta válida — mas é uma pergunta diferente de "qual modelo prevê melhor estruturas".
O que o anúncio faz certo, e vale elogiar: o corte de treino é 30 de setembro de 2021, o mesmo do AlphaFold 3, e todos os testes usam estruturas depositadas depois dessa data. Sem isso, a comparação seria propaganda.
O que os dois anúncios deixam de fora
Nenhum dos dois passou por revisão por pares. O AlphaGenome 2 tem um relatório técnico de 21 MB hospedado no Google, não um artigo aceito em revista. O NovaAtom-Lite tem uma página de anúncio com um gráfico interativo. Isso não invalida nada — na velocidade em que a área anda, o anúncio chega meses antes do paper. Só significa que, hoje, a única coisa que você pode afirmar é: os autores dizem que funciona.
E há uma diferença de acesso que costuma passar batido. O AlphaGenome 2 está liberado hoje para pesquisa não comercial pela API do AlphaGenome, e em preview privado para uso comercial no Google Cloud. O DeepMind é explícito: o modelo é "para uso em pesquisa" e não foi validado nem aprovado para fins clínicos ou de diagnóstico. Ou seja: nenhum médico vai usar isso para fechar diagnóstico amanhã.
Por que isso importa para quem está no Brasil
Doenças raras são o caso óbvio. O caminho até o diagnóstico costuma ser longo: anos de consultas, exames repetidos e um teste genético que muitas vezes volta sem resposta porque a variante encontrada é "de significado desconhecido". Um modelo que aponta a variante causal e o tipo de célula onde ela age encurta a lista de suspeitos que o geneticista precisa investigar na bancada.
O acesso gratuito para pesquisa é o que torna essa conversa real aqui: laboratórios públicos e grupos de universidade não têm orçamento para licenciar modelo comercial, e a API de pesquisa é justamente a porta que abre. O que não existe ainda é caminho regulatório — e enquanto a Anvisa não olhar para isso, é ferramenta de pesquisa, não de clínica.
Vale lembrar também do outro lado da família: o AlphaGenome Atlas publicou previsões para todas as 9 bilhões de mudanças de uma letra possíveis no genoma humano. O mapa existia; o que faltava era o modelo que lê o mapa célula por célula. E o relatório técnico do AG2 acrescenta uma camada: um novo atlas de ligações entre enhancers e genes, com escores para 7 milhões de variantes comuns.
Como ler o próximo anúncio de modelo biológico
Cinco perguntas resolvem a maior parte dos casos, e valem para qualquer área:
- Quem rodou o benchmark? "Nosso resultado" e "resultado de terceiro" são coisas diferentes. Quando o laboratório diz em voz alta qual é qual, como fez a Geodesic, você já sabe o peso de cada número.
- O corte de treino está declarado? Sem data de corte, o modelo pode ter visto o gabarito.
- A comparação é com o modelo anterior do próprio autor ou com o concorrente? As duas são válidas; a primeira é mais fácil de ganhar.
- Os denominadores batem? 172 e 167 interfaces parecem a mesma coisa e não são.
- Passou por revisão? Se não, trate como promessa com números — não como resultado estabelecido.
O que muda de verdade
A parte que sobrevive ao ceticismo é a mudança de granularidade. Prever o efeito de uma variante no "tecido médio" era o gargalo real da genética computacional: a maioria das variantes associadas a doenças fica em DNA que não codifica proteína, e age só em alguns tipos de célula. Passar da média do tecido para o tipo de célula — e conseguir fazer isso para um estado celular que o modelo nunca viu, com um punhado de células do próprio pesquisador — é a diferença entre um mapa de rodovia e um mapa de rua.
O resto é a rotina desta coluna: número de fornecedor é ponto de partida, não chegada. O AlphaGenome 2 dobrou o recall na régua do DeepMind, e o NovaAtom-Lite ganhou do AlphaFold 3 no exame que ele mesmo escolheu para ser o seu. As duas frases são provavelmente verdadeiras. Nenhuma das duas foi conferida por quem não tem interesse no resultado — ainda.
Fontes
- Google DeepMind — AlphaGenome 2: Deciphering how cells read DNA to better understand disease (11/11/2026)
- Relatório técnico — AlphaGenome 2 predicts regulatory activity and variant effects across cell states (Google DeepMind, 11/11/2026, PDF)
- Geodesic Intelligence — Introducing NovaAtom-Lite (10/11/2026)
- Nature — estudo do lócus ETS2 em macrófagos do intestino na doença inflamatória intestinal (2024)
- Google DeepMind — AlphaGenome Atlas: a predictive map of every possible DNA letter change (2025)
- Google DeepMind — página de ciência do AlphaGenome
- Nota de pesquisa interna — cheriffai/ideas/ai-search-2026-11-15 (Obsidian, 15/11/2026)