
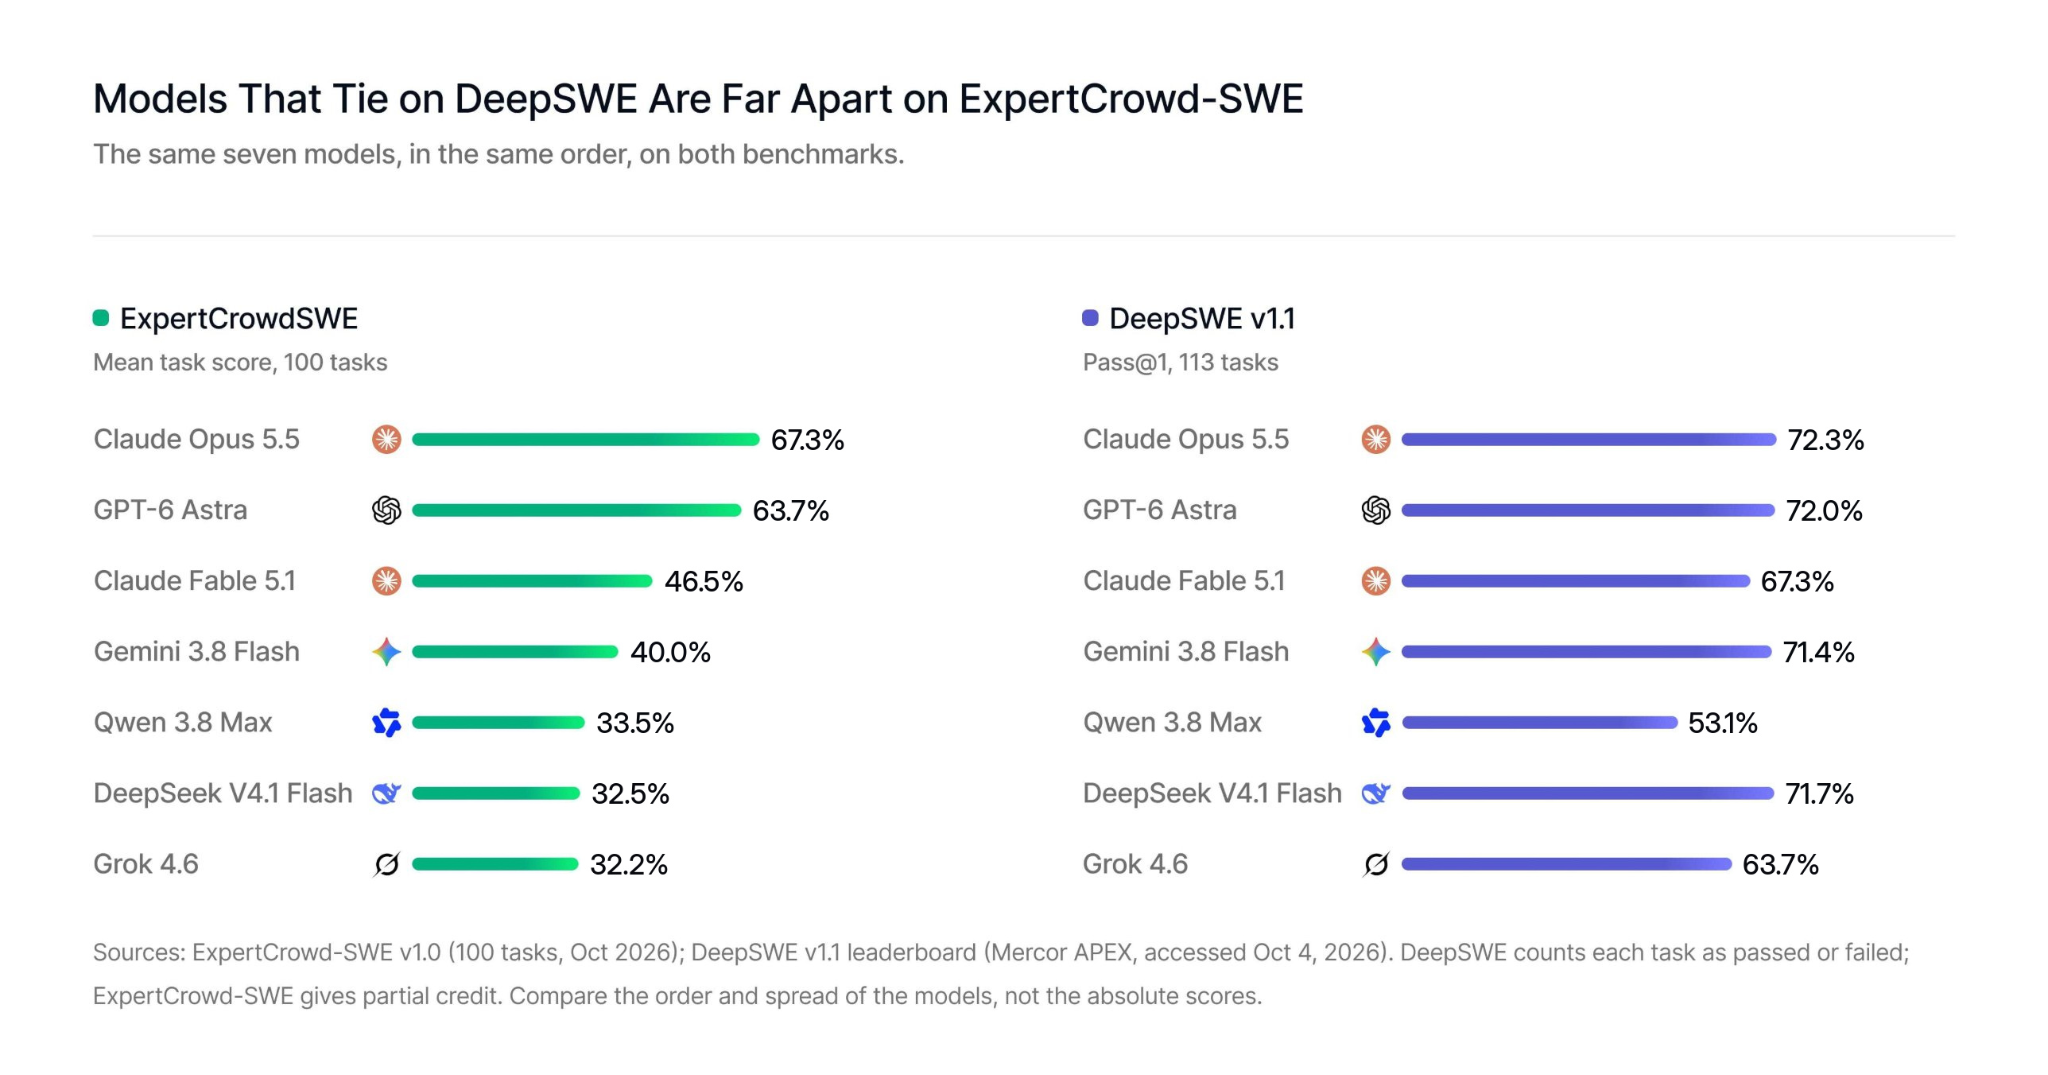
Imagine uma prova de matemática em que a turma inteira tira entre 9 e 10. A prova não está errada. Ela só não separa ninguém. É mais ou menos o que acontecia com um dos principais testes usados para comparar modelos de IA em programação: no DeepSWE, quatro modelos de laboratórios diferentes aparecem separados por 0,9 ponto, entre 71,4% e 72,3%. Em qualquer leitura rápida, estão empatados.
Nesta semana, um grupo de engenheiros publicou um teste novo, o ExpertCrowd-SWE (paper no arXiv, submetido em 09/11/2026), com 100 tarefas escritas à mão por gente que programa para viver. Os mesmos quatro modelos, no mesmo tipo de trabalho, agora aparecem separados por 34,8 pontos. O empate era, em boa parte, um efeito da prova.
Como o teste foi construído
Cada tarefa é um pedido de correção escrito por um engenheiro experiente contra um commit travado de um repositório real: o tipo de bilhete que chega na segunda-feira de manhã. O bilhete mediano tem 148 palavras — curto, do jeito que um pedido de trabalho chega de verdade —, mas a solução de referência mexe, na mediana, 471 linhas de código. Ou seja: pouca instrução, muita investigação.
Ao todo são 100 tarefas em 87 projetos de código aberto e 11 linguagens. Estão lá desde bibliotecas de banco de dados (SQLAlchemy, SQLGlot) e sistemas distribuídos (containerd, MinIO) até ferramentas de autenticação (OAuth2 Proxy, Ory Kratos) e filas de tarefas (Celery, Asynq). O agente recebe o repositório inteiro, um sandbox para rodar comandos e testes, e um teto de 1.000 passos por tentativa.
A nota não é "passou ou não passou". Cada tarefa tem uma rubrica escrita pelo próprio engenheiro que a criou: testes automatizados para o comportamento e um modelo avaliador (Claude Sonnet 4.6) para o que teste não pega. Quem chega perto do conserto leva crédito parcial — o que é mais honesto com o trabalho real, mas também embaralha os números: 60% numa tarefa não quer dizer "acertou 60% do bug".
E, detalhe importante para quem desconfia de placar: 24 das 100 tarefas são públicas e 76 ficam guardadas, para que um modelo não seja treinado exatamente no que vai ser medido. Antes de fechar a lista, os autores compararam suas tarefas com 499.647 registros de 93 benchmarks públicos procurando a mesma tarefa disfarçada. Nenhuma era igual.
O placar
Sete modelos, cinco rodadas por tarefa, 3.495 execuções válidas. A coluna DeepSWE é o placar antigo, o mesmo que mostrava todo mundo empatado:
| Modelo | ExpertCrowd-SWE | DeepSWE | Passos por execução |
|---|---|---|---|
| Claude Opus 5.5 | 67,3% ± 4,7 | 72,3% | 171 |
| GPT-6 Astra | 63,7% ± 5,5 | 72,0% | 37 |
| Claude Fable 5.1 | 46,5% ± 3,7 | 67,3% | 134 |
| Gemini 3.8 Flash | 40,0% ± 4,3 | 71,4% | 182 |
| Qwen 3.8 Max | 33,5% ± 3,3 | 53,1% | 147 |
| DeepSeek V4.1 Flash | 32,5% ± 3,7 | 71,7% | 162 |
| Grok 4.6 | 32,2% ± 3,5 | 63,7% | 80 |
A média dos sete é 45,1%. Nenhum modelo passa de 68%, e a diferença entre o primeiro e o segundo (3,6 pontos) não é estatisticamente significativa: o intervalo de confiança do par vai de menos 1,4 a mais 9,7. Ou seja, não dá para dizer que Opus 5.5 é melhor que GPT-6 Astra neste teste. O que dá para dizer é que os dois formam um grupo, Fable 5.1 forma outro, Gemini 3.8 Flash um terceiro, e os três últimos são indistinguíveis entre si.
A distância que o outro placar apagava
Repare na coluna do DeepSWE: Opus 5.5 (72,3%), GPT-6 Astra (72,0%), DeepSeek V4.1 Flash (71,7%) e Gemini 3.8 Flash (71,4%). Quatro modelos, 0,9 ponto de diferença. Se você escolhesse o seu fornecedor por esse número, eles seriam a mesma coisa.
No ExpertCrowd-SWE, esses mesmos quatro vão de 32,5% a 67,3%. E o DeepSeek, que era terceiro no placar antigo, cai para sexto no novo. Não porque piorou — porque o teste novo mostra o que o antigo esconde.
Aqui é obrigatório colocar a ressalva, que é dos próprios autores: as 100 tarefas foram escolhidas justamente entre as mais difíceis para esses modelos. A nota baixa não significa "IA não sabe programar". Significa "este teste separou só o que a IA ainda não faz". Eles também escrevem, com todas as letras, que o resultado não é um ranking de produtos nem de qualidade geral dos modelos.
A média esconde o que mais importa
O dado mais útil do paper não é o ranking — é o que acontece tarefa por tarefa:
- Em 80 das 100 tarefas, nenhum modelo tirou nota cheia nas cinco rodadas.
- Das 699 combinações de modelo e tarefa, só 26 gabaritaram sempre e 14 zeraram sempre. O resto ficou no meio, variando de rodada para rodada.
- Em 15 tarefas, um dos cinco modelos de baixo superou os dois líderes.
- O exemplo mais cru: numa tarefa do OAuth2 Proxy (correção de sessão e cookie CSRF), nenhum modelo passou de 22% — o melhor fez 21,8%. É um buraco que todos compartilham.
- O inverso também existe: numa tarefa do Asynq, Opus 5.5 zerou em todas as rodadas, enquanto o DeepSeek V4.1 Flash, sexto colocado geral, tirou 75,6%.
Traduzindo: um número único de benchmark diz muito pouco sobre o que vai acontecer no seu código. O modelo que lidera o placar pode ser o pior possível na tarefa que você tem na mão.
Quem dá mais passos não acerta mais
Outro achado que interessa a quem paga a conta: Opus 5.5 e GPT-6 Astra terminam praticamente empatados em nota, mas chegam lá por caminhos opostos. O Astra resolve com uma mediana de 37 passos por execução; o Opus 5.5, com 171. O Gemini 3.8 Flash dá 182 passos e ainda fica em quarto.
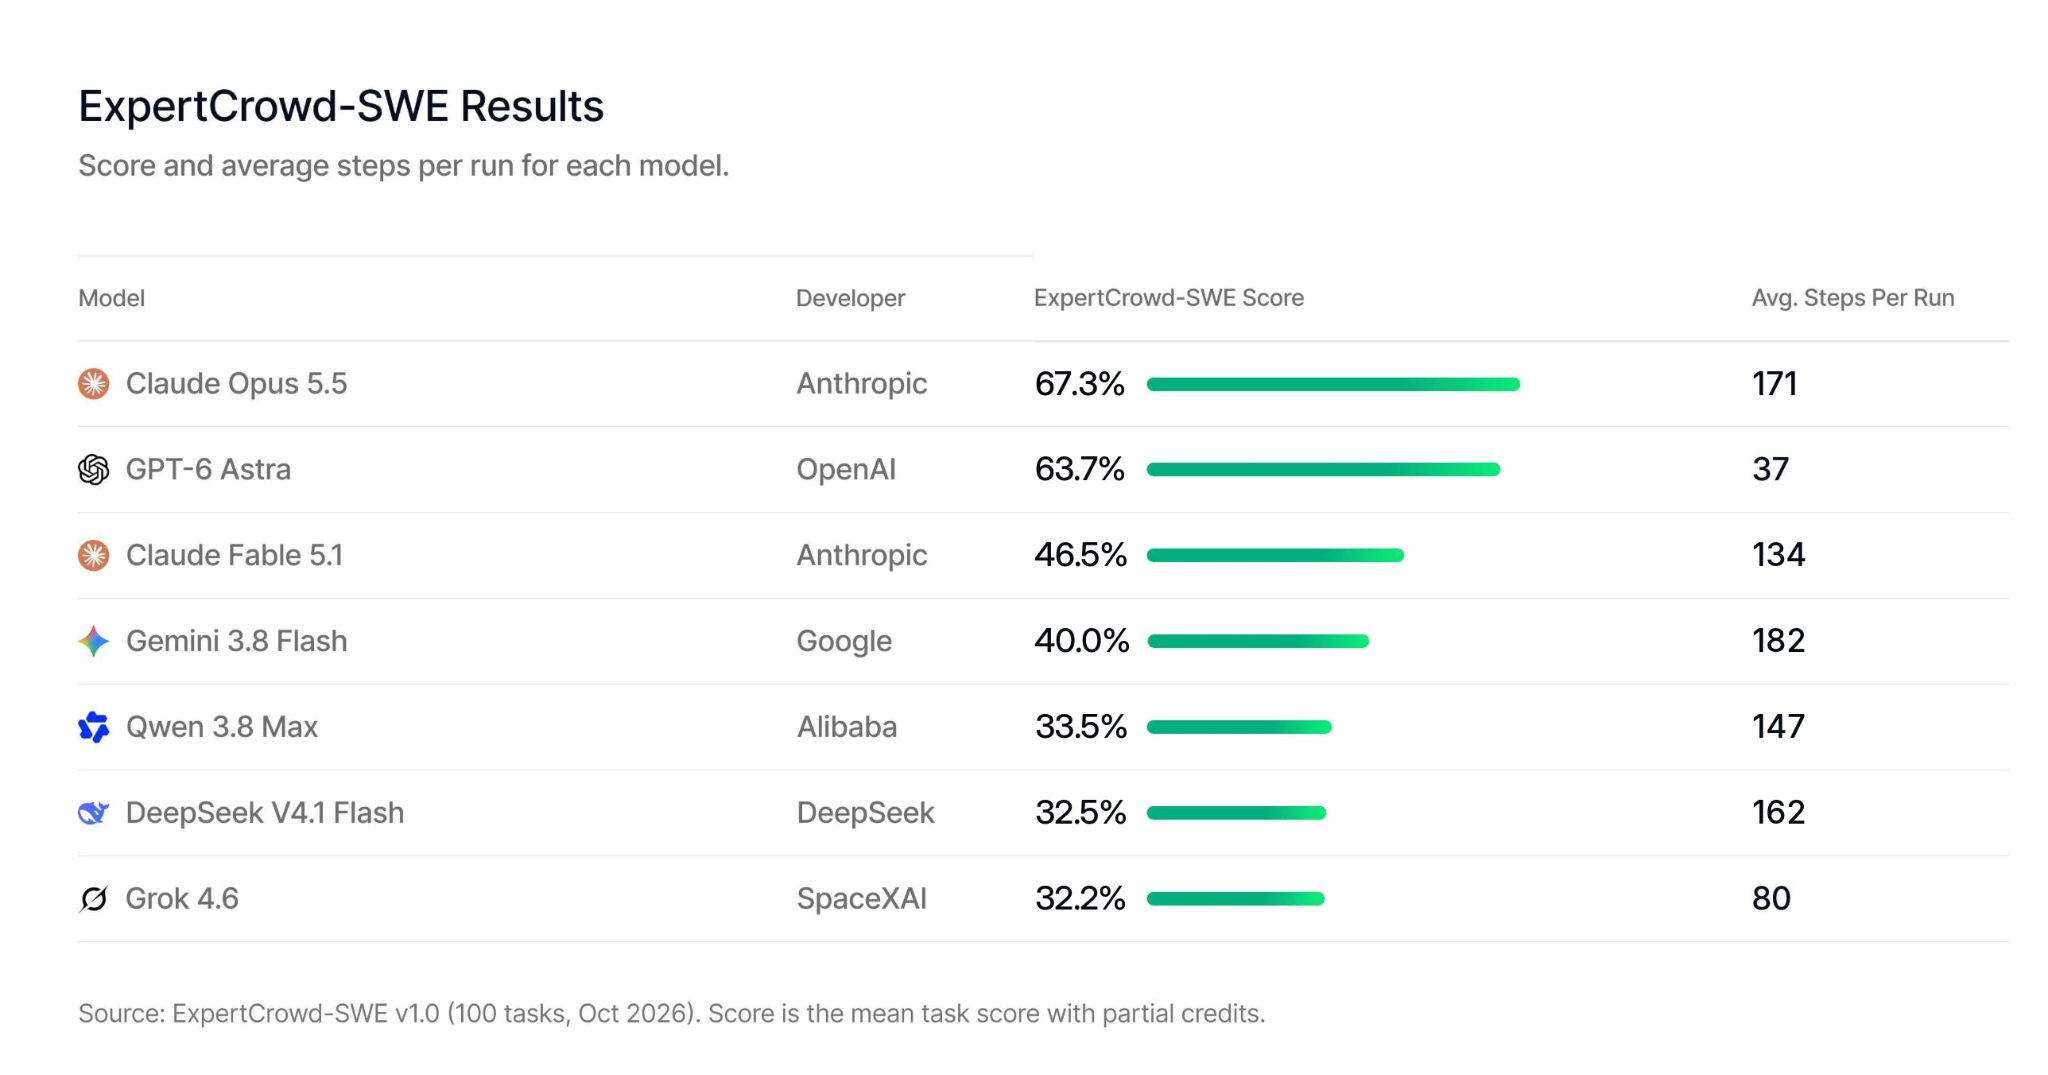
Passo não é sinônimo de eficiência — o próprio paper diz que a mediana de passos varia de 33 a 166 entre modelos sem relação clara com a nota. Mas, para quem roda agente em escala, cada passo é uma chamada de modelo, às vezes uma ferramenta, sempre um custo. Dois modelos com a mesma nota e 4,6 vezes mais passos não custam a mesma coisa.
O que fazer com isso na prática
O recado não é "troque de modelo". É "pare de comprar modelo por posição em placar". Se a sua empresa está escolhendo entre dois ou três modelos para tarefas de código, três coisas resolvem mais que qualquer leaderboard:
- Monte o seu mini-benchmark. Separe 20 ou 30 problemas reais do seu repositório — issues fechadas, com o conserto no histórico — e rode cada modelo cinco vezes. É exatamente o desenho deste paper, em escala de empresa.
- Dê nota parcial e olhe a variância. "Passou/não passou" joga fora justamente a informação que separa os modelos. E rode mais de uma vez: um modelo que acerta 3 a cada 5 rodadas não é confiável só porque a média é 60%.
- Meça o custo junto com a nota. Passos por tarefa, tokens e tempo por execução mudam a conta final — e dois modelos empatados no acerto podem ser bem diferentes no orçamento.
O que a CheriffAI tira disso é o de sempre: número de fornecedor é ponto de partida, não veredicto. Neste caso os próprios autores foram honestos sobre o limite do teste deles — e isso, mais do que o placar, é o que dá para usar na segunda-feira.
A pergunta que fica para o time de dados é simples: quantas das suas tarefas de engenharia a IA de hoje resolveria sozinha, cinco vezes em cinco? Ninguém no Brasil deveria responder isso de memória.
Fontes
- arXiv — ExpertCrowd-SWE: Measuring Frontier Coding Agents on Expert-Authored Engineering Tasks in Unfamiliar Codebases (09/11/2026)
- arXiv (versão HTML) — texto completo, tabelas e discussão dos resultados (nov/2026)
- ExpertCrowd / Toptal — Introducing ExpertCrowd-SWE: An AI Benchmark for Coding Agents (nov/2026)
- Hugging Face — dataset ExpertCrowd/ec-swe (24 tarefas públicas, ambientes e notas)