
A Mistral lançou, em 6 de outubro, o maior modelo de IA já construído fora dos Estados Unidos e da China. Chama-se Mistral Large 4, tem 1 trilhão de parâmetros e ganhou um apelido interno: Le Chonk — mais ou menos "o gordo", em referência ao tamanho. Foi treinado do zero na Europa, em 3.800 GPUs de última geração da Nvidia, dentro de datacenters da própria Mistral.
Duas semanas depois, os números que importam não vêm do anúncio. Vêm da medição independente — e contam uma história bem menos confortável: o modelo de 1 trilhão de parâmetros é, sim, o melhor modelo aberto já feito fora da China, e ainda assim fica atrás de modelos chineses que qualquer pessoa pode baixar hoje. Para o mesmo tipo de tarefa, ele custa mais de quatro vezes mais.
É a lição que este blog repete sempre: em IA, o número do comunicado e o número medido são duas coisas diferentes. E os dois precisam vir com link.
O que a Mistral realmente construiu
Vale reconhecer o tamanho do trabalho antes de cobrar o resultado. O Mistral Large 4 é um modelo de mistura de especialistas (MoE): tem cerca de 1,05 trilhão de parâmetros no total, mas só uma parte é acionada a cada palavra gerada — o anúncio fala em 49 bilhões de parâmetros ativos, e a página de documentação da empresa já mostra 52 bilhões. É a primeira divergência de números, e ela está dentro da própria Mistral.
Além do texto, ele entende imagem (com um codificador de visão separado, de 1,6 bilhão de parâmetros) e foi treinado com dados em mais de 160 idiomas, incluindo todas as línguas oficiais da União Europeia. O treino usou cerca de 4.000 GPUs ao longo de dois meses, o que, segundo o vice-presidente de ciência da empresa, Pierre Stock, é "duas a três vezes menos poder de computação" do que os concorrentes chineses usaram.
O anúncio diz "fronteira". A medição diz 38.
A Mistral descreve o modelo como quem "empurra a fronteira do desempenho em pesos abertos" e diz que ele supera "significativamente" qualquer modelo aberto desenvolvido nos EUA ou na Europa. Isso é verdade — e é também uma frase que esconde o principal, porque não diz nada sobre a China, onde está a real concorrência dos modelos abertos.
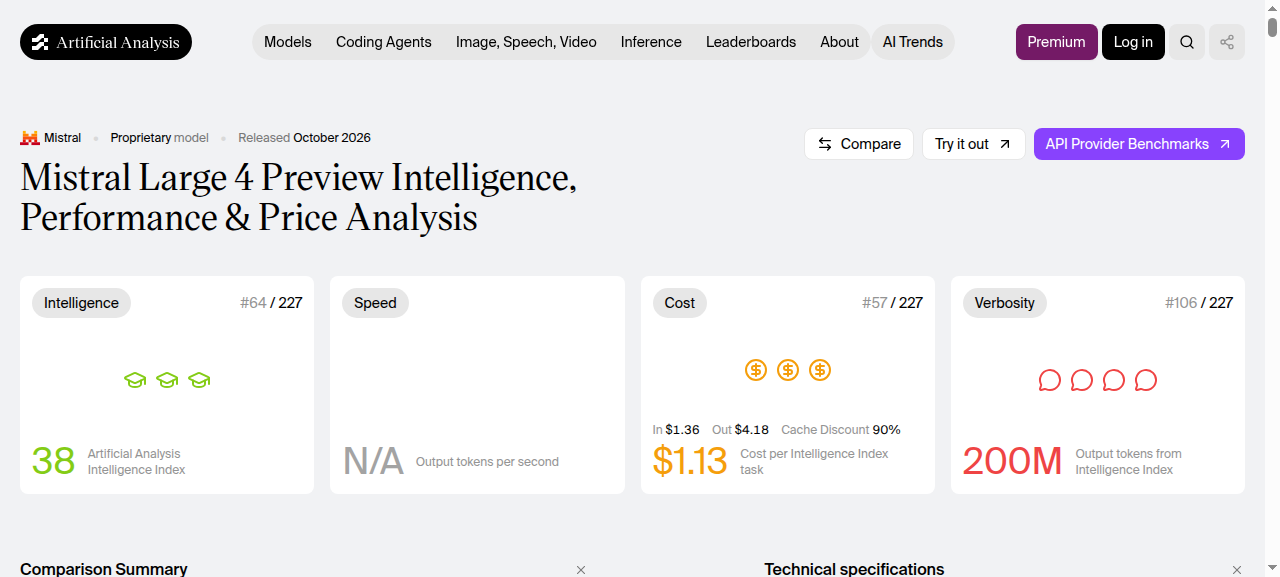
O índice que a maioria do setor usa para comparar é o Artificial Analysis Intelligence Index, uma média de dez avaliações diferentes — raciocínio, código, matemática, tarefas longas de escritório. O Mistral Large 4 tirou 38. Para contexto: a mediana dos modelos comparáveis é 26, e o modelo anterior da casa, o Large 3, tirava 9. O salto é enorme.
Só que 38 coloca o modelo na posição 64 entre 227 avaliados. E, entre os modelos de pesos abertos, os quatro melhores são chineses:
| Modelo | Origem | Índice (AA) | Pesos baixáveis hoje? |
|---|---|---|---|
| MiMo-V2.6-Pro | Xiaomi (China) | 46 | Sim |
| GLM-5.3 | Z.ai (China) | 45 | Sim |
| Kimi K3 | Moonshot (China) | 44 | Sim |
| Qwen3.8 2.4T A95B | Alibaba (China) | 40 | Sim |
| Mistral Large 4 | Mistral (França) | 38 | Ainda não |
| Nemotron 3 Ultra | NVIDIA (EUA) | 23 | Sim |
Ou seja: o melhor modelo aberto do Ocidente perde para seis ou sete modelos abertos chineses. Do lado americano, o quadro é pior ainda: o Nemotron 3 Ultra, da NVIDIA, marca 23, e o gpt-oss-120b, da OpenAI, marca 12 — bem abaixo do novo modelo francês.
A conta que dói: US$ 1,13 por tarefa
O dado mais duro do relatório independente não é a nota — é o preço. Cada tarefa do índice custa US$ 1,13 no Mistral Large 4. O GLM-5.3-Flash, com inteligência quase igual, resolve a mesma tarefa por US$ 0,25; o DeepSeek V4.1 Flash, por US$ 0,27. Mais de quatro vezes de diferença para o mesmo trabalho.
A tabela oficial ajuda a explicar: US$ 1,36 por milhão de tokens de entrada e US$ 4,18 por milhão de saída, com 90% de desconto em cache — e uma "promoção" de 50% nas duas primeiras semanas. É preço de laboratório de fronteira, não de commodity.
Tem mais um detalhe que encarece a conta real: o modelo é tagarela. Para responder às dez avaliações do índice, ele gerou 200 milhões de tokens, contra uma mediana de 82 milhões entre os modelos comparáveis. Modelos que "pensam muito" cobram por isso — e a fatura aparece no fim do mês, não no benchmark.
Os primeiros testes práticos também não são unanimidade: em um relato no Hacker News, o desenvolvedor Simon Willison notou que o modelo só aceita dois níveis de raciocínio ("nenhum" ou "alto") e que a diferença entre eles não pareceu mudar o resultado. Em um ambiente de programação com agentes, o excesso de raciocínio estourou a janela de contexto do teste.
Onde ele é o melhor de verdade
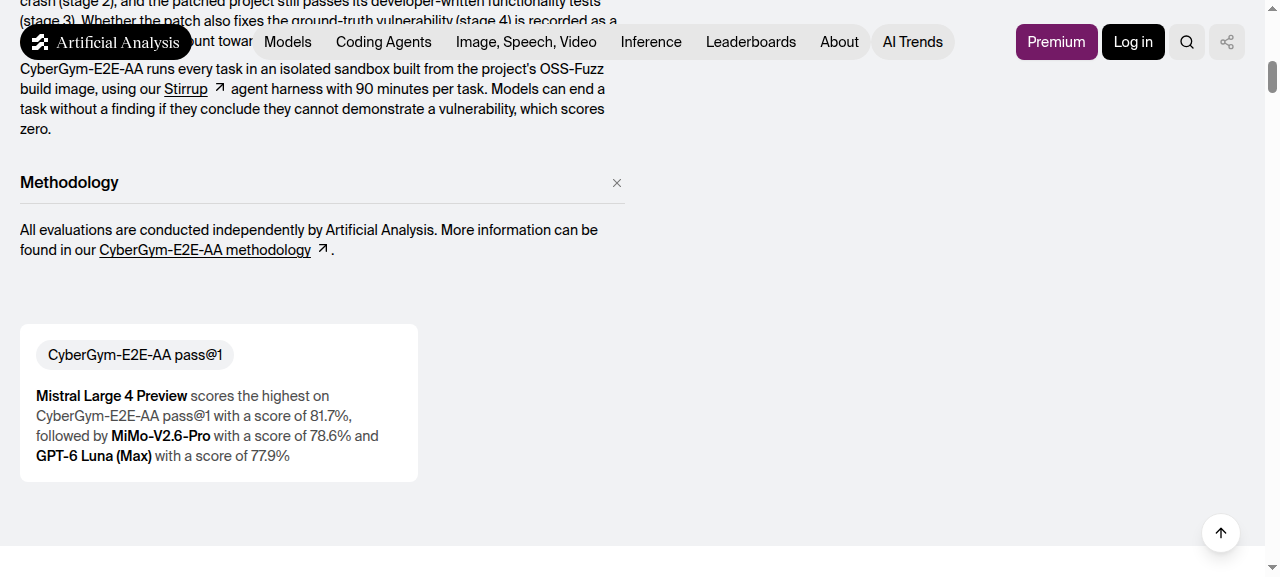
Existe um terreno em que o Mistral Large 4 ganha — e não é por pouco. Na avaliação CyberGym-E2E-AA, o modelo precisa encontrar uma vulnerabilidade real em um projeto de código aberto, reproduzir a falha com uma prova de conceito e depois escrever a correção sem quebrar os testes do projeto. Ele marcou 81,7%, o melhor resultado do quadro, à frente do MiMo-V2.6-Pro (78,6%) e do GPT-6 Luna, da OpenAI, na configuração máxima (77,9%).
O argumento mais interessante do anúncio está aqui. Segundo a Mistral, modelos fechados como o Claude Opus 5.5 e o GPT-6 Astra marcam "perto de zero" nesse mesmo teste — não porque falharam, mas porque recusaram a tarefa. Reproduzir uma falha de segurança é o primeiro passo para corrigi-la, e os filtros de segurança dos modelos fechados podem bloquear exatamente esse trabalho no meio de um incidente. Já escrevemos sobre isso aqui: a IA que entrega uma resposta pior de propósito.
O contraponto, para manter a régua honesta: o primeiro lugar não é um abismo. Um modelo fechado, o GPT-6 Luna, fica a menos de quatro pontos percentuais de distância. No índice de cibersegurança consolidado, o Mistral Large 4 tem 50 pontos — empata com o GLM-5.3-Flash e fica atrás do MiMo-V2.6-Pro, que faz 56.
"Aberto" é uma promessa, não um arquivo
Aqui está o ponto mais importante para quem vai decidir alguma coisa com base nisso: hoje não existe um peso do Mistral Large 4 para baixar. A empresa promete liberar "até o fim do mês" — a data citada a jornalistas foi 27 de outubro —, e o modelo está em prévia pública apenas pela API, com um filtro de segurança. Até a liberação, quem testa são parceiros de cibersegurança e autoridades. E tem duas letras miúdas grandes. A primeira: a licença prometida é uma licença própria da Mistral, não a Apache 2.0 que o Large 3 usava — ou seja, "aberto" não significa automaticamente "use como quiser". A segunda é física: 1,05 trilhão de parâmetros, mesmo em 8 bits, dá cerca de 1 terabyte só de pesos. Um servidor com oito GPUs H200 topo de linha (1,13 TB de memória) fica no limite para caber o modelo. Na prática, isso é infraestrutura de datacenter — não é o modelo que roda na sua máquina.
O que é bom: o custo de computação por token é o de um modelo de 52 bilhões de parâmetros, porque só uma fração é acionada por vez. A medição independente registra 116 tokens por segundo e 1,46 segundo até a primeira palavra — números melhores que a mediana dos concorrentes.
O que isso muda para quem adota IA no Brasil
Três leituras, em ordem de utilidade prática.
Primeira: se o critério é custo por tarefa, o "aberto chinês" ganha hoje. Empresa brasileira montando um pipeline de agente, com volume, não tem motivo para pagar quatro vezes mais por inteligência equivalente — e um modelo que você pode baixar e versionar também não depende de decisão de fornecedor sobre continuar ou não servindo você.
Segunda: se o critério é cibersegurança, aí o cálculo muda. Banco, hospital, seguradora ou órgão público que precisa reproduzir uma falha para corrigi-la não pode depender de um filtro de outro país decidir, no meio do incidente, que aquela tarefa não é permitida. Um modelo que roda dentro do seu datacenter, sob a sua política — e sob a LGPD — tem valor que não aparece no índice de inteligência. É exatamente o argumento de "soberania" que a Mistral está vendendo, e ele é legítimo.
Terceira: se o critério é o que eu posso baixar hoje, o Mistral Large 4 ainda não existe. Existe uma prévia por API, com preço de laboratório e ficha técnica em revisão — o próprio índice de inteligência pode mudar, porque o treino de reforço ainda estava rodando quando a nota foi medida.
A lição de método é a que fica. Benchmark de fornecedor mede o que o fornecedor escolheu medir, contra os concorrentes que ele escolheu colocar no gráfico. Um índice independente submete todo mundo à mesma tarefa. Quando os dois divergem — e aqui divergem —, o número que entra na decisão é o segundo. O primeiro é o que aparece no slide de vendas.
1 trilhão de parâmetros não é liderança. É o preço do ingresso para disputar. Ganhar o jogo depende de quanto custa cada resposta — e de quem fez a medição.
Fontes
- Mistral — "Introducing Mistral Large 4" (06/10/2026)
- Artificial Analysis — Mistral Large 4 Preview: Intelligence, Performance & Price Analysis (out/2026)
- Artificial Analysis — CyberGym-E2E-AA Benchmark Leaderboard (out/2026)
- TechCrunch — Mistral's new 1T model aims to leapfrog closed and open rivals (06/10/2026)
- Tom's Hardware — Independent tests rank Mistral's trillion-parameter Large 4 the best outside the U.S. and China (out/2026)
- Trending Topics — With Large 4, Mistral Tries to Put Europe Back in the A.I. Race (out/2026)
- Fello AI — Mistral Large 4 (Le Chonk): Specs, Benchmarks, Price and When the Weights Land (out/2026)
- AI News Online — Mistral Large 4 explained: 1T open-weight model, benchmarks (out/2026)
- Hacker News — discussão com o primeiro teste de Simon Willison (out/2026)