
Você paga pelo modelo mais inteligente do mundo, faz a pergunta e recebe a resposta de um modelo mais fraco. Sem mensagem de erro, sem travamento, sem desconto na conta. A conversa continua como se nada tivesse acontecido — e, a partir dali, é com o modelo menor que você conversa até o fim.
Isso não é bug nem vazamento. É política oficial, escrita e publicada, de uma das empresas de inteligência artificial mais valiosas do planeta. Em 22 de setembro, a Anthropic lançou o Claude Opus 5.5 e, junto com o anúncio, subiu um artigo de ajuda explicando exatamente em que situações o modelo desce de nível no meio da conversa. A ideia tem nome técnico — fallback, algo como "plano B" — e um propósito que soa razoável: impedir que a IA mais capaz do momento seja usada para planejar um ataque digital, desenhar uma arma biológica ou treinar um concorrente de graça.
O problema é outro. É o que esse mecanismo faz com a confiança de quem depende do modelo para trabalhar.
O que a Anthropic admite em voz alta
O Opus 5.5 é o primeiro modelo da nova família Claude 5.5. Segundo a própria Anthropic, ele performa no nível do Fable 5.1 — o topo anterior da casa — e custa 40% menos para rodar. No papel, é a combinação que todo cliente quer: mais inteligência, menos dinheiro. A empresa também diz que é o modelo com a melhor nota em sua auditoria automática de comportamento, mais resistente a prompt injection (truques escondidos em textos que a IA lê) e menos propenso a tomar decisões difíceis de desfazer.
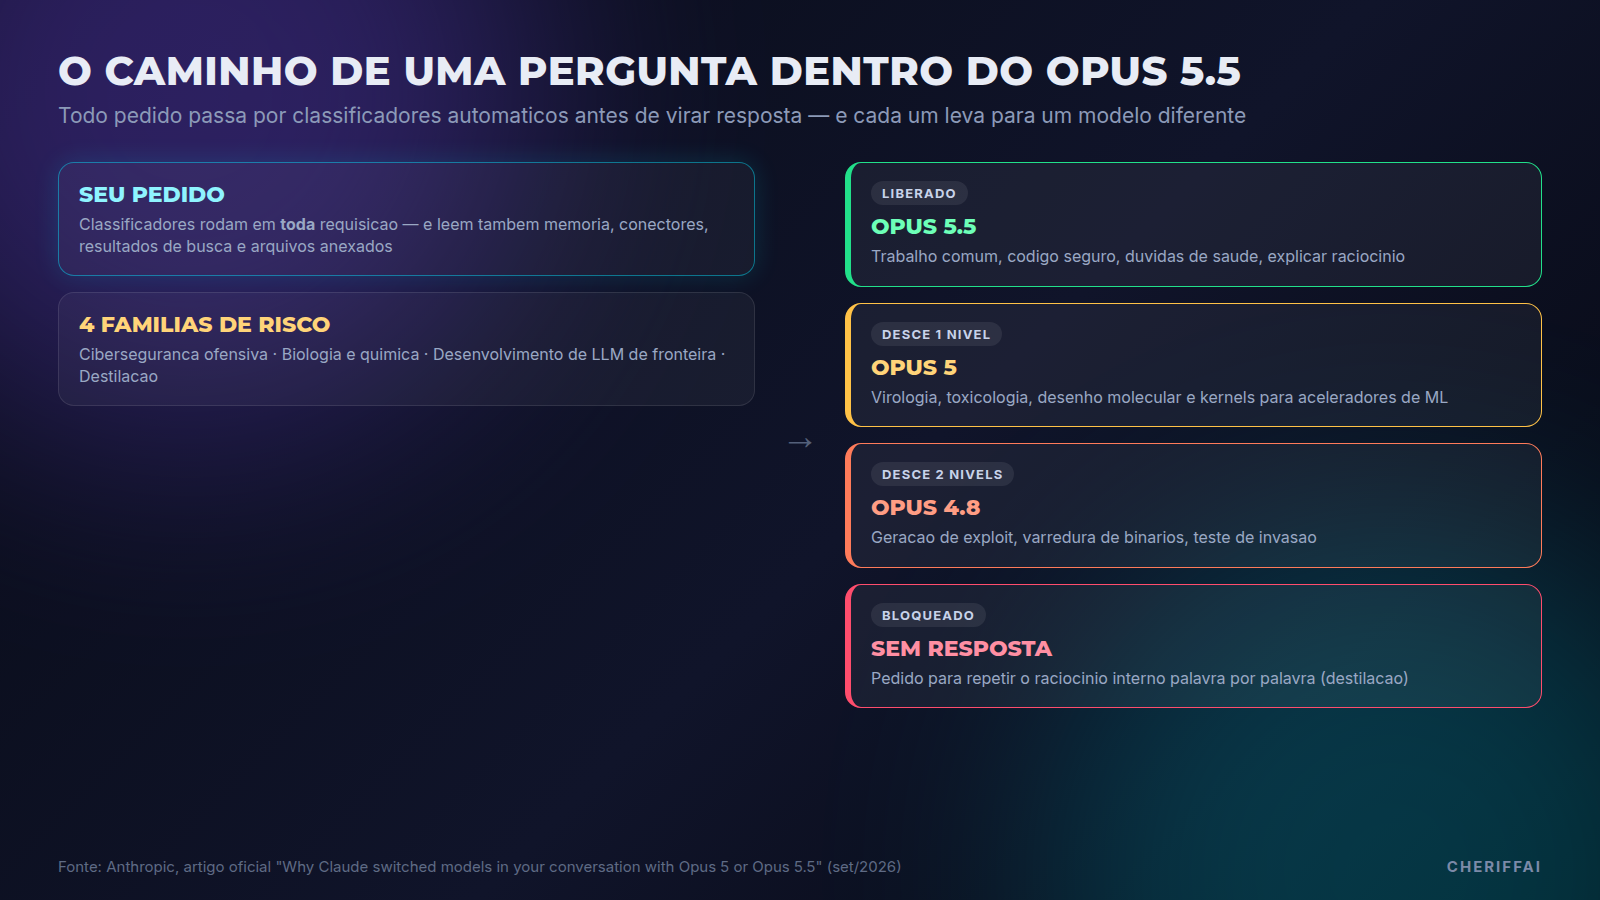
Só que existe uma cláusula no meio do caminho. Como o Opus 5.5 tem capacidade em biologia e cibersegurança comparável à do Mythos 5.1, ele foi lançado com as mesmas travas do Fable 5.1. Na prática, todo pedido enviado ao modelo passa por classificadores automáticos — uma espécie de porteiro de segurança — antes de virar resposta. E cada família de risco leva a um destino diferente:
- Cibersegurança ofensiva — geração de exploit, varredura de vulnerabilidade em programas compilados, teste de invasão: o pedido cai para o Opus 4.8, um modelo duas gerações mais velho. Código seguro continua liberado: dá para revisar código-fonte, triar falhas e construir software protegido.
- Biologia e química — pedidos de uso duplo em virologia, toxicologia e desenho molecular: o pedido cai do Opus 5.5 para o Opus 5. Dúvidas comuns de saúde, resultados de exames e aulas de biologia seguem normais.
- Desenvolvimento de LLM de fronteira — só no Opus 5.5, e numa lista estreita, como programar kernels para certos aceleradores de machine learning: o pedido também cai para o Opus 5.
- Destilação — quando alguém tenta extrair o raciocínio interno do modelo, por exemplo pedindo que ele repita, palavra por palavra, a cadeia de pensamento: aqui não há queda de nível. O pedido é bloqueado de vez.
Lido assim, parece até cuidadoso. A empresa não apagou a resposta nem inventou uma recusa genérica: ela diz que dá para usar o modelo para segurança defensiva, que existe um programa de verificação para laboratórios de ciências da vida e que a partir das próximas semanas profissionais de cibersegurança verificados poderão liberar o acesso pleno.
O detalhe que quase ninguém lê
Há uma frase no artigo oficial que muda o tamanho do problema. Os classificadores não analisam só a sua última mensagem: eles revisam tudo o que o modelo lê. Isso inclui a memória da conversa, o conteúdo de conectores externos, resultados de busca na web e arquivos anexados. Na letra da Anthropic: "uma queda de nível pode ser disparada por conteúdo que você não digitou".
Traduzindo para o dia a dia: um relatório de segurança anexado, um trecho de código de terceiros colado no chat, um artigo sobre virologia puxado de uma busca — qualquer um desses pedaços pode acionar o porteiro e derrubar a sua conversa para um modelo mais fraco, mesmo que o seu pedido fosse inofensivo. Você pediu ajuda para revisar um arquivo; o arquivo é que decidiu qual modelo vai responder.
A troca não acontece só uma vez
Tem um segundo detalhe, ainda mais incômodo para quem usa IA para trabalhar. Depois que a queda acontece, o seletor de modelos fica travado no modelo mais fraco pelo resto da conversa. Não é um turno pior: é o resto do trabalho naquele fio. É possível voltar manualmente para o Opus 5.5, mas, se o pedido original continuar na conversa, as travas podem disparar de novo. A recomendação oficial é editar a mensagem anterior e tentar outra vez.
A Anthropic faz questão de dizer que os fallbacks são transparentes: aparece um aviso explicando a troca e a resposta vem etiquetada com o nome do modelo que respondeu. Isso resolve metade do problema — a invisibilidade — e deixa a outra metade intacta: quem decide se você merece a resposta boa é um classificador que você não pode auditar.
Em junho, a mesma ideia foi escondida — e virou desculpa pública
Para entender por que essa transparência existe justamente agora, é preciso voltar três meses. Em 9 de junho, a Anthropic lançou o Fable 5, o primeiro modelo da classe Mythos disponível ao público, e publicou um cartão de sistema de 319 páginas. Enterrado lá dentro estava um parágrafo revelador: a defesa contra destilação seria deliberadamente invisível. Nas palavras do próprio documento, o modelo "não vai cair para um modelo diferente" — em vez disso, limitaria a própria eficácia por meio de "modificação de prompt, vetores de direcionamento ou ajuste fino eficiente em parâmetros" (PEFT).
Ou seja: quando o modelo desconfiasse que alguém estava tentando copiá-lo, ele responderia pior de propósito e não avisaria. Pesquisadores chamaram a prática de sabotagem secreta. Nathan Lambert, que liderou trabalho no AI2, escreveu que era inaceitável ter o acesso a modelos de ponta "puxado debaixo do tapete".
Em cerca de 24 horas, a Anthropic recuou e pediu desculpas com uma frase que virou clássico involuntário: "Fizemos a troca errada e pedimos desculpas por não ter acertado o equilíbrio." Dali em diante, a destilação passaria a cair para o Opus 4.8 avisando — o mesmo caminho que cibersegurança e biologia já usavam. A estimativa de impacto era pequena: cerca de 0,03% do tráfego, segundo apuração da Fortune.
Só que o episódio revelou uma segunda camada, mais incômoda. Separadamente, o classificador do Fable 5 se mostrou exageradamente sensível: relatos apontaram recusas para pedidos banais, incluindo a palavra "olá", e uma taxa de recusa de aproximadamente 97% em perguntas de biologia. No Claude Code, o sistema do próprio Fable 5 emitia um aviso de troca de modelo logo no primeiro turno de praticamente toda sessão — inclusive numa sessão cujo único conteúdo era uma palavra. Pela contagem da Anthropic, o classificador conservador disparava em menos de 5% das sessões.
Fica a lição que atravessa o setor: o porteiro é útil, mas erra para os dois lados. Bloquear demais quebra trabalho legítimo; bloquear de menos não serve para nada.
O número que ficou difícil de comparar
Existe uma consequência técnica raramente mencionada e que afeta diretamente quem compra IA: se o modelo que responde pode não ser o modelo que você pediu, o benchmark passa a medir o sistema, não o modelo. E foi exatamente isso que aconteceu com o Opus 5.5.
No ranking do Artificial Analysis, o mesmo modelo aparece com duas notas diferentes. Em esforço máximo, ele marca 58 pontos no Índice de Inteligência e chega ao 1º lugar entre 206 modelos. Já a configuração publicada na ficha oficial — com esforço alto e fallback padrão ligado — marca 54 e fica em 3º entre 661 modelos. A etiqueta do avaliador deixa claro: o que está sendo medido é "Claude Opus 5.5 (raciocínio adaptativo, esforço alto, fallback padrão)".
É uma diferença conceitual enorme. A nota de 54 não diz "o Opus 5.5 acertou 54". Ela diz "o sistema que a Anthropic entrega, incluindo as trocas automáticas de modelo, acertou 54". Para comparar, GPT-6 Astra e o Fable 5.1 aparecem com 53.
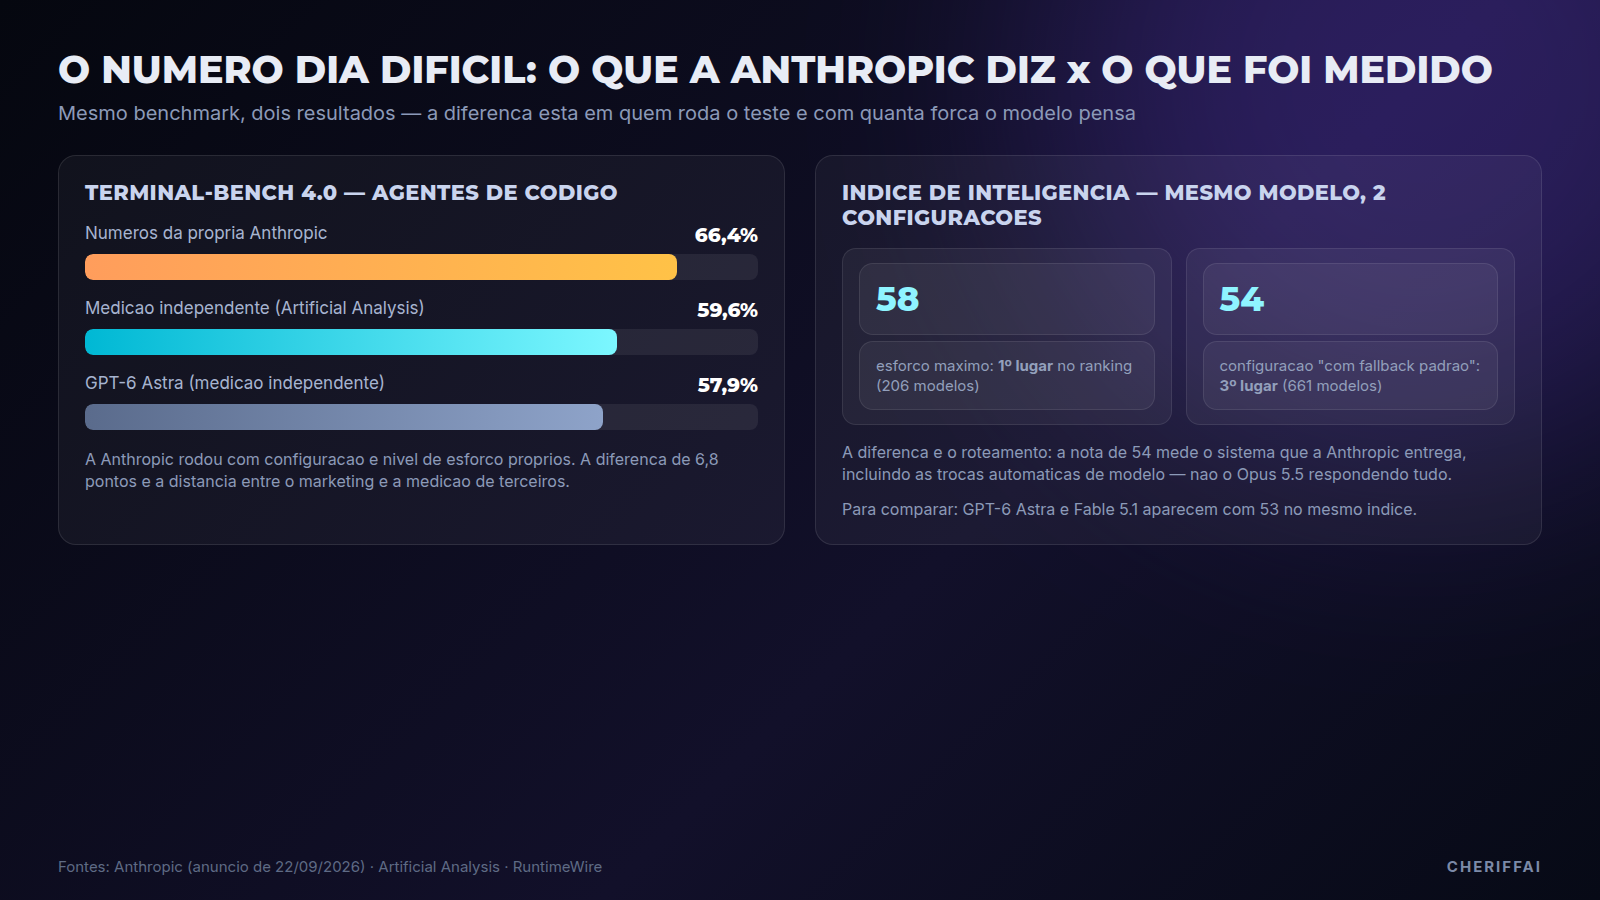
O caso lembra um padrão conhecido no mundo dos benchmarks: números de laboratório são medidos com configuração de laboratório. A Anthropic reporta 66,4% no Terminal-Bench 4.0 com o próprio arranjo; a medição independente encontrou 59,6% — êxito, mas com 6,8 pontos de distância do material de divulgação. No mesmo teste, o GPT-6 Astra fica em 57,9%. Ou seja: a liderança é real, mas a margem anunciada encolhe quando o teste é feito por quem não tem interesse no resultado.
O que muda para quem constrói com IA no Brasil
Para uma empresa brasileira que coloca um agente de IA em produção — atendimento, análise de documentos, revisão de código — o recado prático é direto: não basta contratar o modelo mais caro e assumir que ele responde tudo. Três providências deixam de ser preciosismo e viram necessidade:
- Monitorar qual modelo respondeu. A resposta da API traz o identificador do modelo que gerou o texto. Se a sua aplicação não compara esse campo com o que foi pedido, você não sabe quando houve troca — e pode estar pagando por um produto e recebendo outro, sem registro para discutir o contrato.
- Fazer um teste que flagre quedas inesperadas. Vale criar um conjunto de perguntas legítimas do seu negócio e verificar quantas sofrem troca de modelo. É a diferença entre descobrir o problema no seu laboratório ou na sua linha de produção.
- Ter um plano B sob controle. Se a inteligência cai por causa do conteúdo de uma memória ou de um anexo, um modelo aberto que você hospeda — auditável, previsível e sob sua governança — passa a ter função concreta: ele é o seu hedge contra surpresas que você não pode inspecionar.
Há ainda um debate que interessa a quem cria capacidade local. A Anthropic justifica as travas citando segurança nacional: a ideia é evitar que "adversários estrangeiros" usem o modelo para acelerar o próprio desenvolvimento de IA de fronteira. O argumento é sério, mas cria um efeito colateral comercial: quem desenvolve modelos passaria a precisar de verificação para chegar ao produto completo. No limite, isso empurra a inovação independente para fora do ambiente fechado — e para dentro de projetos abertos, que ninguém pode rebaixar por decisão unilateral.
A pergunta que fica
A Anthropic tem motivos reais para construir esse porteiro. Um modelo capaz de ajudar a planejar um ataque ou a desenhar um patógeno não deveria estar disponível para qualquer pessoa sem freios. O erro de junho não foi a trava existir: foi ela ser invisível. O acerto do Opus 5.5 foi tornar a troca visível e documentada. O que ainda falta é a parte que nenhuma empresa pode dar sozinha: prova de que o rebaixamento não atinge o trabalho legítimo — e evidência de que a IA de ponta está mesmo na potência máxima quando alguém mede a fronteira.
Existe algo quase filosófico nesse arranjo. Passamos anos discutindo quando a IA vai "decidir" sobre nós. O detalhe é que ela já começou — só que a decisão, por enquanto, é menor e mais chata: decidir se você merece a resposta boa. Quem usa IA para trabalhar merece, no mínimo, saber que essa pergunta existe.