
Na sexta-feira, 9 de outubro de 2026, a Microsoft anunciou o Microsoft-Decision-1. O próprio anúncio não esconde o escopo: é um modelo com um trabalho só — tomar decisões estruturadas, rápido. Ele não escreve poema, não redige e-mail, não conversa, não explica. Você entrega um cardápio fechado de respostas possíveis (sim ou não, alternativas de múltipla escolha, uma nota) e ele devolve, para cada opção, uma probabilidade calibrada.
A diferença parece pequena, e é enorme. Um modelo de linguagem responde "acho que este chamado é sobre cobrança" — e alguém precisa escrever código para interpretar essa frase. O Decision-1 responde 0,93 para cobrança, 0,05 para problema técnico, 0,02 para acesso, e a aplicação já sabe o que fazer sem ler nada. É o mesmo desenho que o Jev, da TypeSafe AI, apresentou em setembro e que já rendeu um post aqui no blog (a IA que não escreve nada e por isso não alucina). A novidade é quem entrou nesse jogo.
Os números que a Microsoft está exibindo
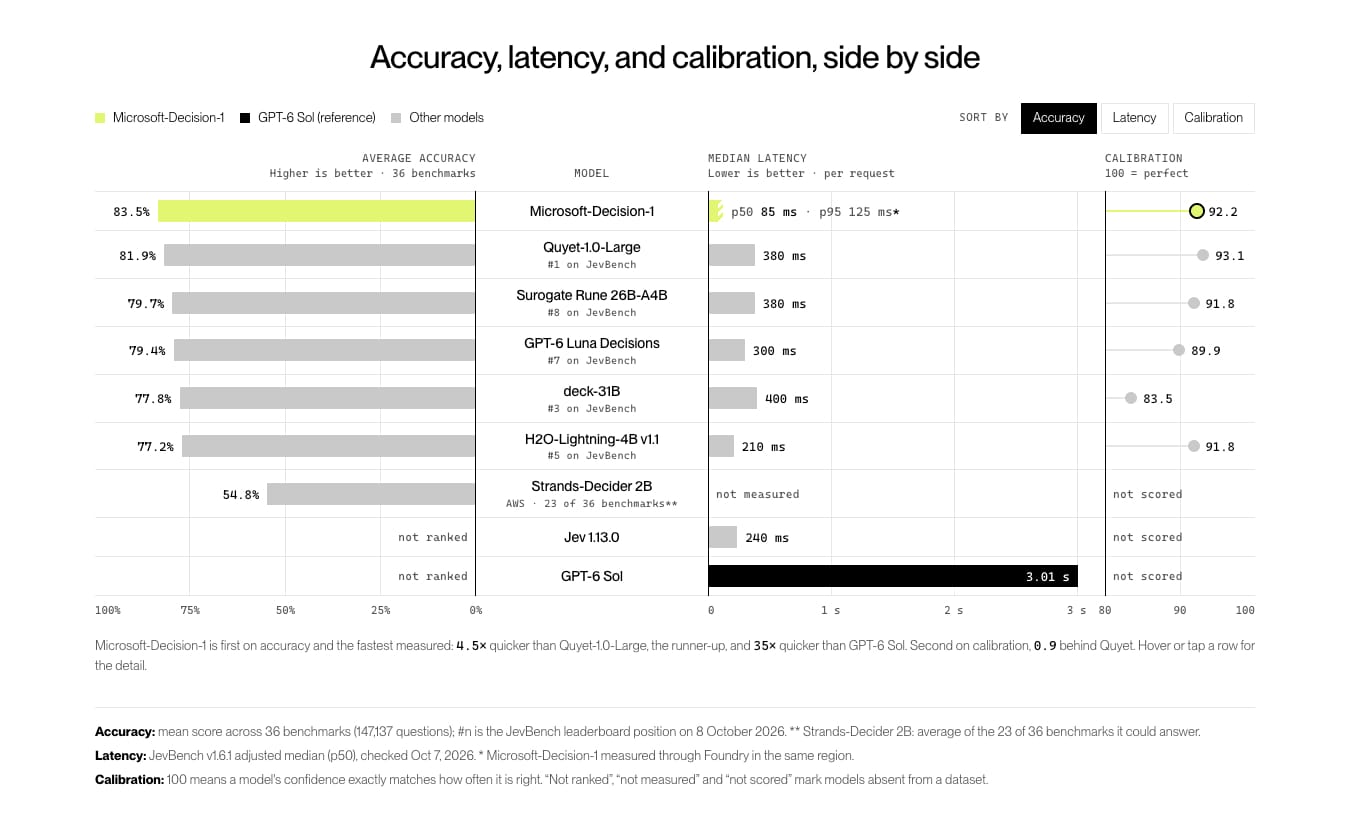
Segundo a própria Microsoft, o Decision-1 teve a maior acurácia em uma comparação de 36 benchmarks, com quase 150 mil perguntas mantidas cegas ao treino — perguntas que o modelo não viu antes, em áreas como roteamento, ranqueamento, contexto longo, multilíngue, raciocínio e segurança.
Em latência, os números são de outro patamar: 4,5 vezes mais rápido que o Quyet-1.0-Large, apontado como vice-campeão, e 35 vezes mais rápido que o GPT-6 Sol. A comparação é feita na latência P50 — a mediana, ou seja, o caso típico, não o melhor caso de uma bateria de testes.
Tem também um número que quase ninguém divulga e que é o mais interessante: a robustez. Numa aplicação real, o mesmo pedido chega escrito de maneiras diferentes — descrições reescritas, opções em outra ordem, chaves trocadas, ruído de formatação. A Microsoft perturbou o mesmo pedido de oito formas e mediu quantas vezes a decisão mudava: 1,3% no geral, e zero mudanças quando as descrições das opções eram parafraseadas ou quando a ordem das alternativas era invertida ou embaralhada. Para quem já tentou extrair uma classificação estável de um modelo de linguagem, esse número vale mais que o placar de acurácia.
Calibração: a parte chata que decide o projeto
Não basta o modelo acertar — ele precisa saber quando não sabe. Aqui está o ponto central do anúncio: a probabilidade não é um enfeite de ranking, é parte da interface. Se o modelo diz 90%, ele deve estar certo em cerca de nove de cada dez casos representativos. É isso que permite desenhar a fronteira entre o que roda automático e o que vai para um humano: acima de um limiar, segue; abaixo, escala para revisão.
E velocidade importa mais do que parece porque decisões se encadeiam. Como o próprio anúncio calcula: se cada decisão custa 100 milissegundos a mais do que deveria, um fluxo com vinte decisões em sequência ganha dois segundos de atraso. Um agente faz milhares de pequenas escolhas — continuar ou parar, qual ferramenta usar, se a resposta passa no critério de qualidade — e algumas poucas tarefas que realmente exigem geração de texto. Rodar todas essas escolhas por um modelo gigante é o desperdício estrutural da arquitetura atual.
O detalhe que quase ninguém comentou: por dentro, é um Qwen
A Microsoft não construiu a base do modelo. Pegou o Qwen3.5-9B, o modelo aberto de 9 bilhões de parâmetros da Alibaba, e fez post-training em cima dele para que fizesse pontuação de decisão em passada única. O anúncio diz ainda que as próximas versões vão trocar a base, migrando para os modelos MAI (Microsoft AI) e para modelos da OpenAI.
Três leituras rápidas. Primeira: o tamanho compacto é a explicação da velocidade e do preço — 9 bilhões de parâmetros cabem em muito menos hardware que um modelo de fronteira. Segunda: o modelo-base virou insumo. Uma gigante com US$ 3 trilhões de valor de mercado usou pesos abertos de um laboratório chinês como fundação de um produto comercial, e tratou isso como decisão de engenharia, não como assunto geopolítico. Terceira, e a mais prática para quem constrói: o gargalo migrou do pré-treino para o pós-treino e para a avaliação — a parte que qualquer equipe pequena pode fazer.
Tem um gosto particular aqui na CheriffAI: rodamos Qwen self-hosted nas nossas rotinas internas, então a notícia tem um parentesco estranho — o tipo de modelo que a Microsoft post-treinou é o mesmo que já está no nosso servidor.
US$ 0,042 por milhão — com a saída de graça
O preço é o argumento mais afiado do anúncio: US$ 0,042 por milhão de tokens de entrada, nas zonas de dados dos Estados Unidos e da União Europeia, e saída gratuita. A saída ser grátis tem explicação técnica, não generosidade: não há texto gerado token a token. O "resultado" é uma lista de probabilidades, e não se cobra por tokens que não existem.
Duas comparações deixam o número legível. A primeira: é exatamente o mesmo preço que o Jev cobrava em setembro — US$ 0,042 por milhão. A segunda: fica cerca de 48 vezes mais barato que os US$ 2 por milhão de entrada que os modelos de fronteira da semana passada vinham cobrando, como mostramos no post sobre a IA que ficou 10 vezes mais barata.
Junte as duas coisas e aparece a tese do produto: a parte barata e volumosa de um agente — decidir — sai do modelo caro e vai para um modelo pequeno e especializado. A parte cara — gerar e raciocinar — continua onde precisa estar.
Os testes internos (a melhor parte do anúncio)
A Microsoft listou usos reais dentro de casa, e é onde o anúncio fica interessante:
- Xbox Research: mais de 10 mil comentários e avaliações abertas de enquetes, Steam e X foram organizados em um conjunto fixo de temas definido pelos pesquisadores. Qualidade comparável ao GPT-6 Sol, rodando mais de 14 vezes mais rápido e custando 200 vezes menos.
- Time do Copilot: mede a qualidade das respostas do chat e dos agentes — competitivo com o GPT-5.6 Luna e 100 vezes mais rápido.
- Resposta a incidentes: os plantonistas usam IA para buscar conhecimento em logs, sistemas de chamados, ligações e mensagens ao vivo. O Decision-1 se saiu melhor e mais rápido que um modelo de linguagem na recuperação de conhecimento.
- Microsoft Discovery: num ciclo de replanejamento adaptativo, a nota de consistência foi 46 vezes maior que a avaliação feita por LLM, a três vezes a velocidade, e o ciclo ficou quase 4 vezes mais rápido.
Onde isso é útil — e onde é armadilha
A lista oficial de casos de uso é longa e concreta: controle de agentes (avaliar o próximo passo e decidir se continua, para, tenta de novo ou passa para um humano), roteamento entre modelos, análise de intenção, rotulagem de dados, avaliação de respostas de IA, triagem de incidentes, validação de entrada, relevância de busca, classificação de conteúdo, varredura de código, triagem de segurança, uso de computador (escolher o próximo clique na tela) e robótica.
A armadilha é a mesma em todos eles, e vale dizer em voz alta: o modelo não explica nada. Quando um LLM erra, você lê a frase e entende o erro. Quando um modelo de decisão erra, você vê "0,91 para a opção errada". A auditoria muda de lugar — sai do texto e passa a ser sobre a distribuição de confiança e sobre o cardápio de opções que alguém escolheu oferecer. Se as alternativas foram mal formuladas, o modelo vai decidir com toda a confiança dentro de um cardápio ruim. E preço baixo convida a automatizar decisões que afetam pessoas: crédito, triagem, atendimento. A nota de confiança é o gatilho; definir o limiar e mandar o resto para humano continua sendo decisão de gente.
Não é só a Microsoft
O anexo do anúncio lista os modelos do comparativo: Quyet-1.0-Large, Surogate Rune 26B-A4B, GPT-6 Luna Decisions, deck-31B, H2O-Lightning-4B e Strands-Decider 2B. A cobertura da Crypto Briefing lembra que Liquid AI e o vLLM Semantic Router lançaram ofertas parecidas na mesma janela. Ou seja, não é um produto isolado: é uma faixa inteira do mercado se formando em semanas. A própria Microsoft diz ter testado os principais modelos públicos abertos no JevBench, o placar que nasceu justamente da classe de modelos que o Jev inaugurou.
O que isso significa para quem constrói no Brasil
Se você opera atendimento, triagem de chamados, moderação de conteúdo ou qualquer fluxo com milhares de classificações por dia, o custo por decisão é provavelmente o seu maior gasto invisível com IA. A conta costuma estar escondida em dois lugares: no token de entrada que você paga para um modelo grande "decidir" escrevendo, e no código que você mantém para interpretar o que ele escreveu.
Um modelo de decisão ataca os dois. A triagem vem estruturada, com nota de confiança, e o que não passa do limiar cai numa fila humana — o que também é a resposta mais barata para as perguntas de LGPD e de auditoria que chegam junto com qualquer automação que decide sobre pessoas. Três cuidados antes de comprar a ideia: teste no seu dado, porque acurácia em benchmark não é acurácia no seu ticket; valide a calibração (o 90% é mesmo 90% no seu caso?); e meça custo por decisão concluída, não por token, porque decisão que erra e precisa de refazer sai caro de qualquer jeito.
Há um ano, a corrida era sobre quem escrevia melhor. Agora existe uma segunda pista, na qual ganha quem decide mais barato — e quem admite a própria dúvida com honestidade. Os dois números que resumem o anúncio são o 4,5x de velocidade e o 1,3% de instabilidade. Um diz que dá para decidir muito mais rápido. O outro diz que, finalmente, alguém está medindo o que importa.
Fontes
- Microsoft Command Line — "Introducing Microsoft-Decision-1, our model for fast decision-making" (09/10/2026) — anúncio oficial: benchmarks, robustez, calibração, testes internos, preço e política de disponibilidade.
- Microsoft Community Hub (Azure AI Foundry Blog) — "Introducing Microsoft-Decision-1 in Microsoft Foundry for decision and classification workloads" (09/10/2026) — base Qwen3.5-9B, casos de uso e preço por zona de dados.
- Microsoft Foundry — catálogo do modelo Microsoft-Decision-1 (09/10/2026) — ficha de disponibilidade em pré-visualização pública.
- Crypto Briefing — "Microsoft launches Decision-1, an AI model built to make fast calls" (09/10/2026) — contexto de mercado e a menção a Liquid AI e vLLM Semantic Router.
- TestingCatalog — "Microsoft launches Decision-1 model in Foundry" (09/10/2026) — detalhamento das perturbações, testes de segurança e dos testes internos da Xbox.
- Hugging Face — model card do Qwen3.5-9B (Alibaba) — o modelo aberto usado como base do Decision-1.
- JevBench (Benchmark Heaven) — placar de modelos de decisão citado no anúncio da Microsoft.