
Um modelo de 5 bilhões que já é o mais baixado da semana
Na sexta-feira, 16 de outubro, o laboratório chinês OpenMOSS publicou os pesos do MOSS Image: um gerador de imagens de 5 bilhões de parâmetros, licença Apache 2.0, que faz uma coisa que quase todo modelo aberto erra — escrever texto legível dentro da imagem. Em quatro dias, o pacote pronto para o ComfyUI acumulou 924.574 downloads no Hugging Face, e o repositório no GitHub chegou a 1.089 estrelas em quatro dias.
Para comparar: o pacote equivalente do FLUX 3 klein, o modelo de 5,6 bilhões que a Black Forest Labs abriu seis dias antes, está com 439.528. O Z-Image, concorrente de 6 bilhões da Tongyi, tem 48.415. São downloads dos últimos 30 dias, medidos na API do Hugging Face em 20 de outubro — a mesma régua para todo mundo.
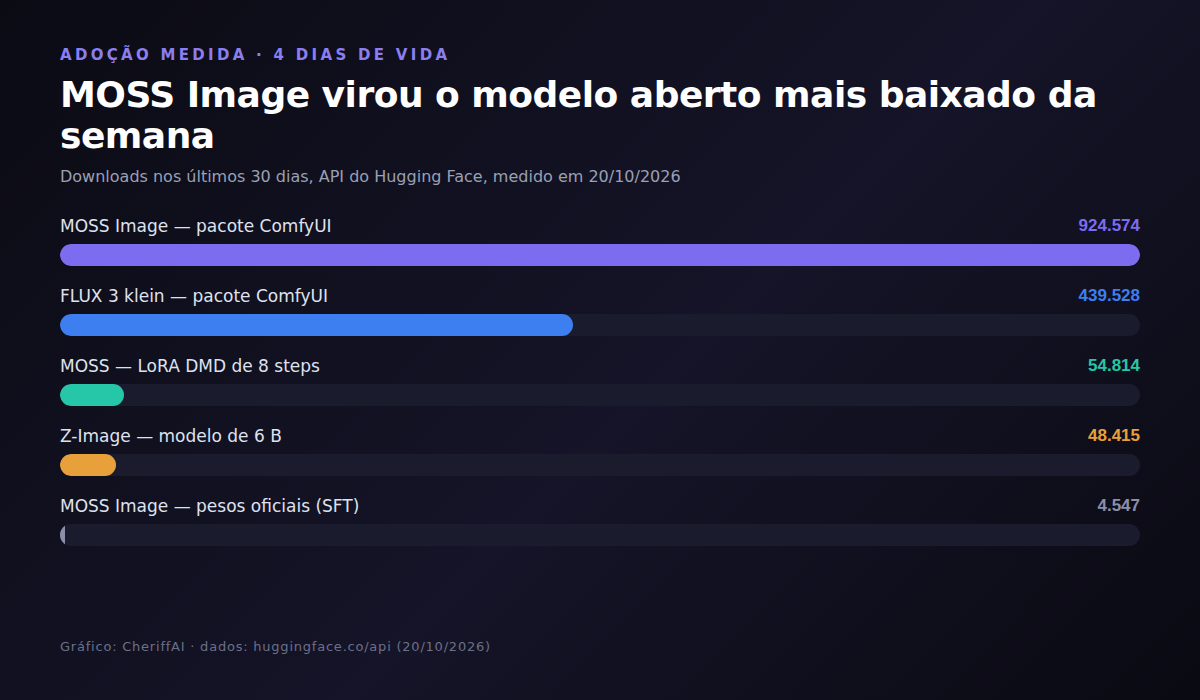
O número de downloads, sozinho, não diz se o modelo é bom. Mas diz uma coisa útil: a comunidade de imagem local estava esperando exatamente isso — um modelo pequeno que não erra as letras.
O que é o MOSS Image, sem jargão
Todo gerador de imagem moderno tem três peças: alguém que lê o seu pedido, alguém que desenha a imagem e alguém que revela o resultado final. No MOSS:
- Quem lê é um codificador de texto baseado no Qwen3.5-9B — o mesmo tipo de modelo que roda um chat.
- Quem desenha é o tal "5 B": um transformador de difusão de 42 camadas, treinado do zero.
- Quem revela é o VAE do FLUX.2, que converte a matemática em pixels.
O relatório técnico, publicado no arXiv no dia 16 e anunciado no GitHub em 19 de outubro, é explícito sobre a motivação: sistemas fechados já produzem "conteúdo de densidade informacional" — cartaz, infográfico, diagrama — enquanto os modelos abertos ainda travavam em texto denso e layout complicado. O MOSS ataca justamente essa lacuna, com duas cartas na manga: aceita prompts de até 4.000 tokens e entende layout por caixas, no formato JSON.
Anúncio vs. medição: os dois benchmarks são da casa
Aqui começa o trabalho de sempre. O paper não usa benchmarks de terceiros para provar que é bom: ele cria dois — o LLTB (LongLongTextBench, para texto longo em inglês e chinês) e o RLA (RealLayoutArena, para geração com muito layout). E os resultados são:
- LLTB: melhor entre os modelos abertos, com 96,3% de cobertura média de texto.
- RLA: segundo lugar na comparação de sistemas completos — e primeiro entre os geradores quando todos recebem o mesmo prompt enriquecido.
É um resultado bom, e é um resultado do fornecedor, no benchmark do fornecedor. A leitura correta é: existe evidência de que o texto sai legível, e existe uma lacuna de verificação independente que ninguém preencheu ainda — nem nós. O que a CheriffAI pode fazer hoje é o que todo mundo pode: olhar os números de adoção, o tamanho real dos arquivos e o que a comunidade construiu em cima.
O detalhe que ninguém põe no título: 19 GB para ler o pedido
"Modelo de 5 bilhões" é uma frase de marketing útil e enganosa ao mesmo tempo. Os 5 bilhões são só a parte que desenha. Quando você vai baixar de verdade o pacote do ComfyUI, o mapa de arquivos é este:
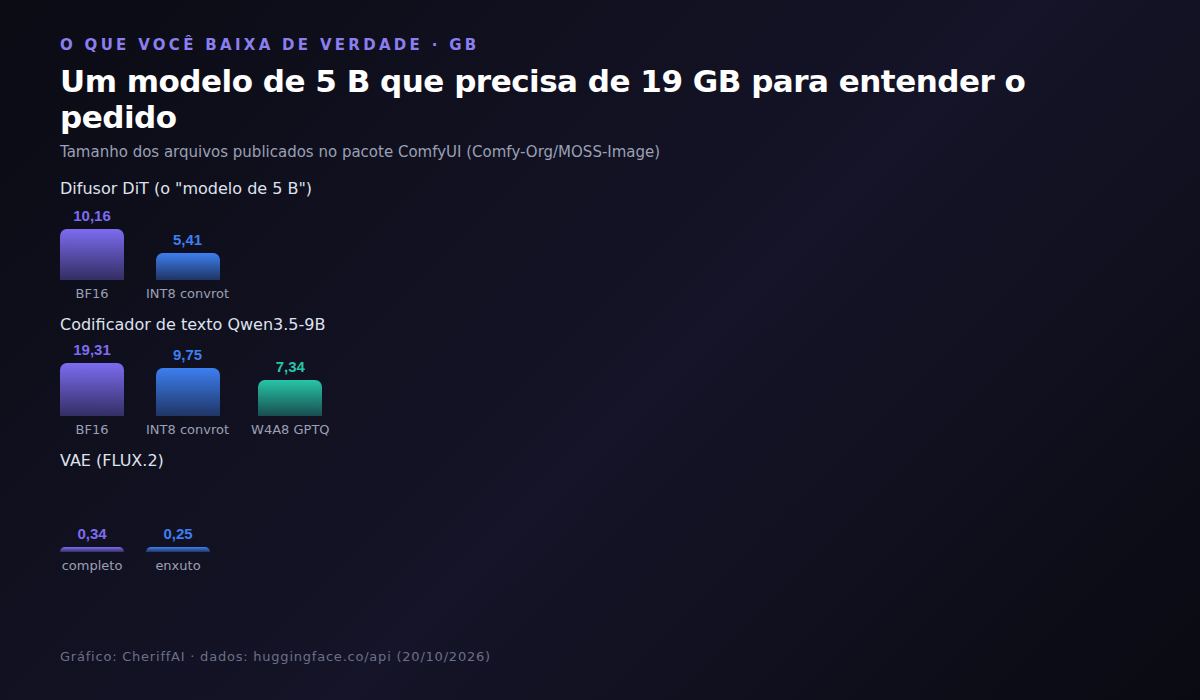
Some: o desenho em precisão cheia tem 10,16 GB, e o codificador de texto tem 19,31 GB — quase o dobro do "modelo de 5 B", porque são 9 bilhões de parâmetros só para interpretar o pedido. Os caminhos econômicos existem e são publicados no mesmo repositório: o difusor em INT8 cai para 5,41 GB, o codificador em W4A8 cai para 7,34 GB e o VAE enxuto tem 250 MB.
Caso prático 1 — a conta de quem tem uma GPU de 8 GB. Se você tentar o caminho de precisão cheia, não cabe: 10,16 + 19,31 já passa de 29 GB antes de qualquer imagem existir. A combinação que cabe é difusor INT8 (5,41) + codificador W4A8 (7,34) + VAE enxuto (0,25) — cerca de 13 GB, o que ainda não entra em 8 GB. Para essas placas, o próprio projeto oferece um modo "Sequential", que troca as peças entre CPU e memória da placa conforme a necessidade: cabe, e fica mais lento. É a diferença entre "roda no seu PC" e "roda no seu PC se você aceitar esperar".
Caso prático 2 — quanta qualidade custa o desconto. O criador do vídeo que apresentou o modelo (canal AI Search, 20/10) rodou a versão de 16 GB de VRAM a 25 passos e teve ~25 segundos por imagem; no fluxo padrão do ComfyUI, ~30 segundos. O padrão recomendado no repositório é mais conservador: 50 passos, CFG 3, salto do shift em 5. Ou seja, o número que você vê nos tutoriais e o número que sai na sua máquina vão diferir — sempre diferem.
A alegação que não conseguimos confirmar é a mais repetida: a de que o modelo quantizado roda com 4 GB de VRAM ou menos. Nenhum arquivo publicado tem esse tamanho, e não medimos. Fica registrada como promessa de canal, não como fato.
O recurso que custava caro virou um campo de JSON
Em 4 de outubro publicamos aqui sobre o FLUX 3 e o controle de imagem por caixas: em vez de descrever tudo em prosa e torcer, você entrega retângulos e o modelo respeita cada um. Naquele momento, era o argumento de venda de uma API paga de topo.
O MOSS faz a mesma coisa — e é aberto. O layout entra como JSON, com um cenário e uma lista de itens, cada item com sua descrição e sua caixa. O relatório técnico chama isso de "composição com consciência de intenção", e o repositório traz o formato e um workflow pronto. No teste do canal, os elementos ficaram onde foram pedidos, inclusive um logo de refrigerante com o texto correto em chinês.
Essa é a notícia de verdade do lançamento, e ela é chata de contar: controle espacial deixou de ser diferencial de fornecedor. Em duas semanas, o recurso que justificava assinatura virou um arquivo de configuração que qualquer pessoa roda na própria máquina.
O asterisco: ele escreve, mas não conversa
O entusiasmo para no ponto em que você quer editar uma foto existente. O MOSS não aceita "tire o vaso da mesa e coloque um gato". O caminho é o antigo: carregar a imagem, pintar a máscara à mão, e descrever só o que entra ali — inpainting tradicional. O próprio vídeo que elogia o modelo resume: "não é ótimo, é inpainting tradicional".
Vale comparar com o Qwen Image 2.1, que em setembro mostramos editando por linguagem natural, com até dez imagens de referência. São dois modelos abertos que rodam na sua máquina e resolvem problemas diferentes: um gera com texto e layout sob controle; o outro edita por conversa. Se o seu caso é trocar o fundo de uma foto de produto, o MOSS é a ferramenta errada — e é melhor descobrir isso antes de baixar 19 GB.
Quatro dias de comunidade dizem mais que o paper
O sinal mais forte não está no relatório técnico: está no que apareceu em quatro dias ao redor de um modelo Apache 2.0.
- Day-0 em três stacks. No mesmo dia dos pesos, 16 de outubro, já havia suporte nativo no ComfyUI, no SGLang e no vLLM-Omni. Modelo aberto só é aberto quando o ecossistema chega junto.
- LoRA que corta o tempo em 3 a 4 vezes. Uma destilação comunitária de 8 passos (MOSS-Image-SFT-8-steps-dmd) já soma 54.814 downloads. Com 8 passos e CFG 1, a geração acelera — e o preço é que, com CFG 1, o prompt negativo deixa de ter efeito. Toda otimização cobra alguma coisa.
- Treinar ficou barato. O KohakuMossTrainer, lançado em 18 de outubro, treina LoRA e fine-tune completo com 6 GB de VRAM — menos do que custa gerar a imagem. É a inversão que define esta geração de modelos pequenos: ajustar ficou mais acessível que usar.
- Correções de defeito viraram pacote. Já existe LoRA para reduzir as faixas de cor verticais do modelo (banding), pesos FP16 consertados para evitar estouro numérico e um acelerador que prevê estados internos. Em quatro dias, o modelo ganhou um mercado de segunda mão.
Mesmo peso, veredito oposto
Ontem este blog publicou o caso do FLUX 3 klein: também 5 bilhões, também aberto no mesmo mês, e a medição no ComfyUI entregou dedos extras e anatomia deformada. Hoje é o contrário: um modelo de peso quase idêntico entrega texto correto e layout obediente.
É o melhor argumento possível contra a métrica mais usada da indústria. Contagem de parâmetros não prevê qualidade — ela prevê quanto de memória você vai gastar. Duas equipes, dois modelos de 5 bilhões, dois resultados opostos, três dias de diferença. Quem escolhe ferramenta de IA olhando "quantos B" está escolhendo pela ficha técnica errada.
O que isso muda para quem constrói no Brasil
Para uma PME brasileira, o ponto não é técnica: é conta e é dado. Gerar imagem com modelo local elimina custo por imagem e resolve a parte chata da LGPD — o material do cliente nunca sai da sua máquina, o que importa quando o insumo é foto de produto, documento ou material interno. Uma loja que precisa de 200 variações de cartaz por mês deixa de pagar por chamada de API e passa a pagar por uma placa de vídeo uma vez.
Mas o gargalo muda de lugar: sai do preço e vira o encanamento. Você precisa montar o fluxo, escolher a quantização, aceitar que o texto em português ainda é o teste mais duro — o paper fala em inglês e chinês, e o português com acento continua sendo a fronteira que ninguém mediu de forma pública. Nenhum número neste post cobre português. Quem for usar em produção deve medir, porque a promessa do fornecedor não inclui a nossa língua.
É por isso que a pergunta certa não é "qual é o melhor modelo de imagem aberto". É "quanto custa, no meu hardware, a imagem que eu realmente preciso — e o que eu perco no caminho". O MOSS Image responde muito bem à primeira parte e devolve a segunda em forma de trabalho. A parte que ninguém vai fazer por você é medir.
Fontes
- arXiv — MOSS-Image Technical Report (16/10/2026)
- GitHub — OpenMOSS/MOSS-Image: pesos, layout em JSON e changelog de day-0 (16–19/10/2026)
- Hugging Face — MOSS-Image-SFT (Apache 2.0, pesos publicados em 16/10/2026)
- Hugging Face — pacote ComfyUI do MOSS Image: mapa de arquivos e tamanhos (medido em 20/10/2026)
- Hugging Face — LoRA DMD de 8 passos (community project citado pelo repositório oficial)
- GitHub — KohakuMossTrainer: fine-tune e LoRA com 6 GB de VRAM (18/10/2026)
- YouTube — AI Search: "New top local AI image generator is here!" (20/10/2026)
- Hugging Face — Z-Image, concorrente de 6 B usado na comparação de downloads (medido em 20/10/2026)
- Hugging Face — FLUX 3 klein, pacote ComfyUI (comparação de downloads, medido em 20/10/2026)