
Até agora, editar uma foto conversando era privilégio de quem pagava
Você fotografa um produto, escreve troca o fundo por uma parede de tijolos e a imagem volta pronta em segundos. Isso já existe há um bom tempo — mas sempre do lado fechado da cerca. O Nano Banana, do Google, e o GPT Image, da OpenAI, fazem isso muito bem: você manda a sua foto para o servidor de outra empresa, paga por imagem e aceita as regras de uso deles.
No dia 20 de setembro, a Alibaba abriu os pesos do Qwen Image 2.1, o primeiro modelo de imagem da família Qwen que gera e edita dentro do mesmo pacote — e que roda no seu computador. Sem nuvem, sem limite de gerações, sem mandar nada para fora. O anúncio veio com uma alfinetada: no benchmark da própria Alibaba, ele fica à frente do Nano Banana 2.0 do Google.
Antes de comprar a briga, vale entender o que o modelo faz de diferente, quanto ele custa em memória e onde o título de número 1 precisa de asterisco.
Um só modelo para gerar e editar
O Qwen Image 2.1 tem 7 bilhões de parâmetros na parte que desenha a imagem, distribuídos em 32 camadas de um diffusion transformer, a arquitetura padrão da geração de imagem atual. A parte que entende o que você escreveu é separada: um encoder Qwen3-VL de 8 bilhões de parâmetros, que transforma texto e imagens de referência em instruções.
Essa divisão importa para quem vai instalar. Dizer que o modelo tem 7B é verdade e é meia verdade: na conta de memória, os dois pedaços entram. Fora isso, os números do lançamento: resolução nativa de 2048 × 2048 (sem gerar pequeno e aumentar depois), 40 passos de revelação por padrão e vários formatos de tela já prontos.
O recurso que quase ninguém entregava: fundo transparente de verdade
Todo gerador de imagem devolve um retângulo. Se você quer só o objeto — um tênis, uma pessoa, um logotipo — precisa de uma segunda ferramenta para recortar o fundo, e o recorte costuma destruir cabelo, vidro e sombra.
O Qwen Image 2.1 gera o PNG já com canal alfa, a informação de transparência que faz o fundo simplesmente não existir. Não é truque de pós-processamento: o decodificador do modelo foi construído com 64 canais, quatro deles carregando o alfa, em vez dos três canais de cor dos modelos comuns. Também dá para editar uma camada transparente já existente ou extrair um objeto de uma foto como camada separada.
Para quem monta capa, anúncio, catálogo ou figurinha, essa é exatamente a peça que faltava: o arquivo pronto para entrar sobre qualquer fundo, sem etapa manual e sem recorte de cabelo feito na mão.
Editar conversando, com até 10 fotos de referência
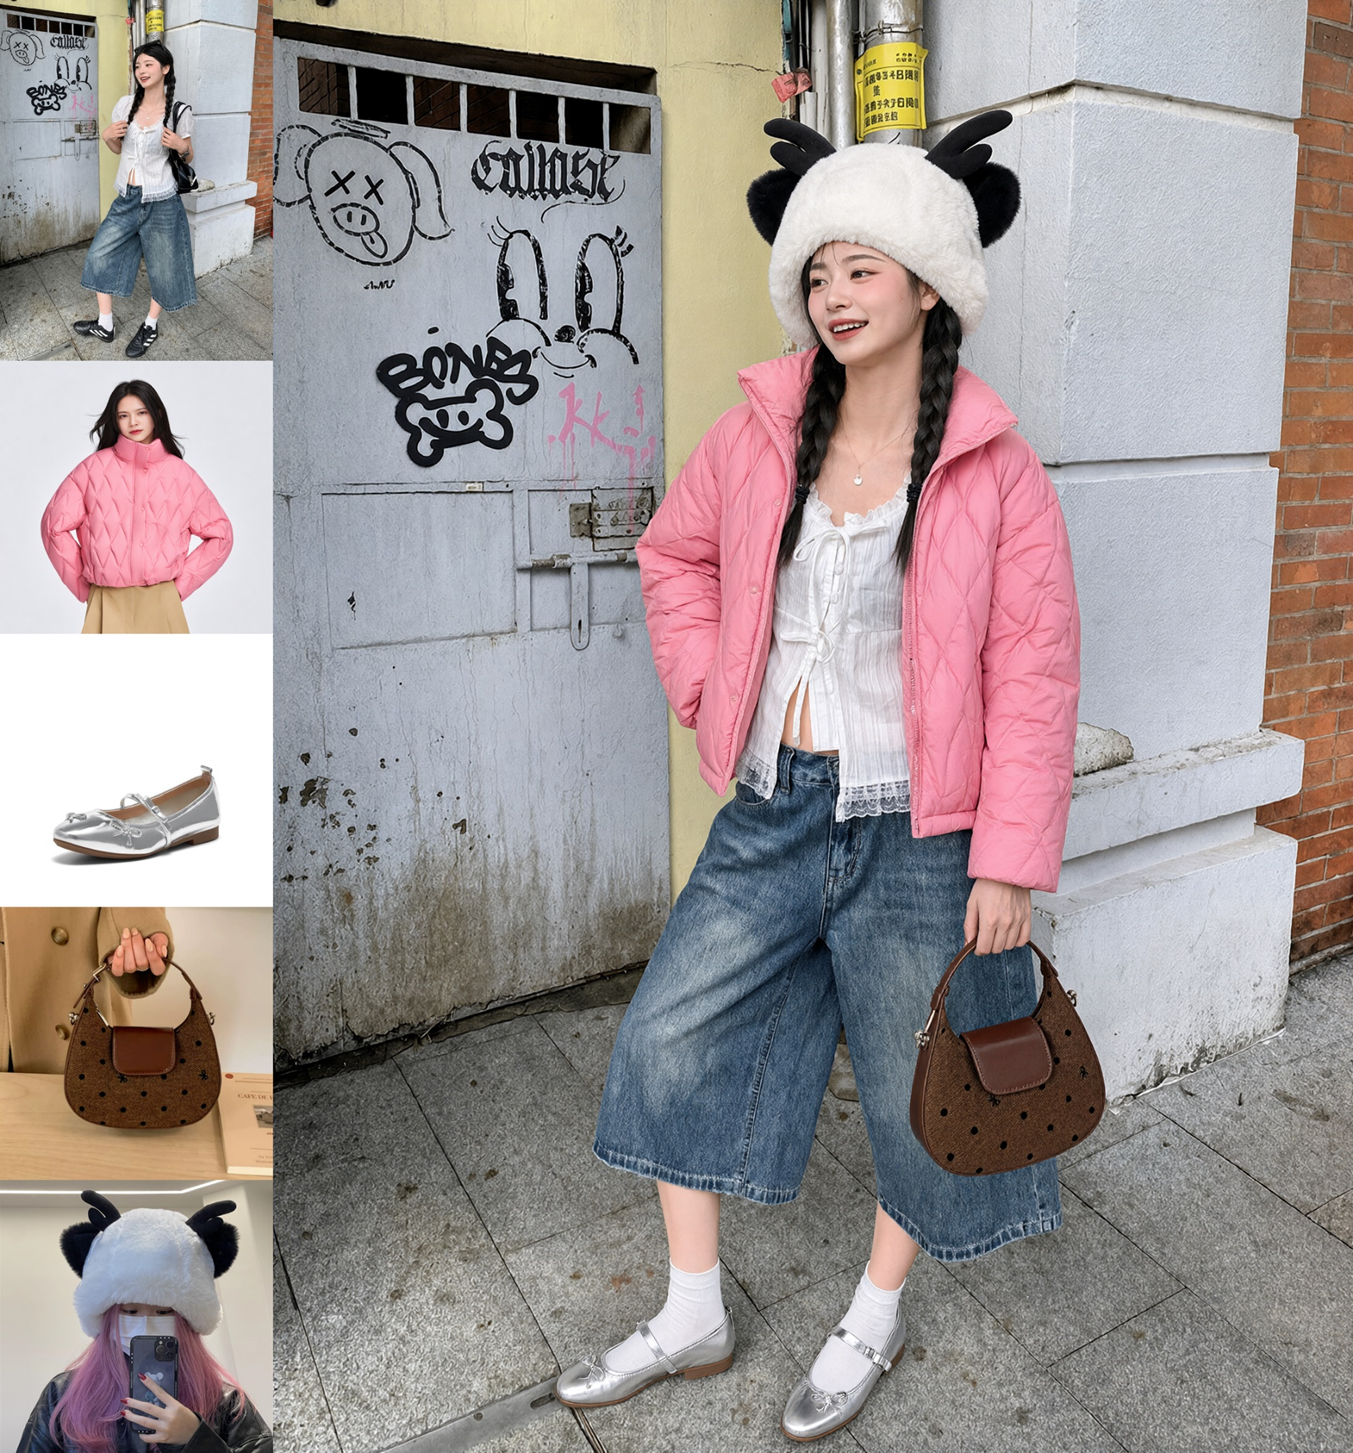
A outra metade do produto é edição por instrução: você descreve a mudança em linguagem natural e o resto da imagem fica intacto. O diferencial é a quantidade de referências — até 10 imagens de uma vez. Dá para montar um retrato de grupo a partir de seis fotos separadas ou vestir uma pessoa com a camisa de uma foto, o sapato de outra e o chapéu de uma terceira, preservando rosto, cabelo e o desenho da roupa.
Também é possível apontar a região em vez de descrever: você circula, pinta por cima ou passa uma máscara sobre a parte que quer mudar. E, se a ideia for trocar apenas o texto de uma imagem, o modelo troca apenas o texto.
Texto legível — o teste que quase toda IA de imagem reprova
O outro ponto em que os modelos abertos vinham perdendo feio é escrever. Letras pequenas, texto denso e layout complicado — infográfico, slide, embalagem, mockup de aplicativo — continuam legíveis no resultado, segundo a documentação oficial. Quem já tentou gerar um cartaz com o nome do produto escrito certo sabe o tamanho do problema que isso resolve.
E ele já sai em resolução profissional: além do quadrado de 2048 × 2048, o modelo tem formatos nativos, sem precisar cortar ou esticar.
| Formato | Resolução nativa | Uso típico |
|---|---|---|
| 1:1 | 2048 × 2048 | Feed de rede social, catálogo |
| 4:3 | 2400 × 1792 | Apresentação, capa de blog |
| 16:9 | 2752 × 1536 | Banner, thumbnail de vídeo |
| 9:16 | 1536 × 2752 | Stories, capa de celular |
Quanto de memória isso custa de verdade
Aqui está o dado mais útil para quem tem notebook gamer e não uma estação de trabalho. O modelo existe em várias versões, do arquivo completo até uma versão comprimida que roda em máquina modesta:
| Peça | Tamanho | Observação |
|---|---|---|
| Modelo completo (BF16) | 14,2 GB | Qualidade máxima |
| Versão INT8 | 7,2 GB | Roda em placa de 8 GB de VRAM |
| Versão GGUF Q3 | 3,19 GB | Roda com menos de 4 GB de VRAM |
| Encoder de texto (menor) | 6,3 GB | A versão completa pesa 17,5 GB |
| Decodificador (VAE) | 676 MB | É o que carrega o canal alfa |
| Dois otimizadores de prompt | 9,5 GB cada | Opcionais — quase ninguém precisa |
Ou seja: com cerca de 10 GB de arquivos e menos de 4 GB de VRAM você tem um editor de imagem que gera e edita sem limite de uso. Os dois arquivos opcionais de reescrita de prompt somam quase 20 GB e servem para transformar uma frase curta em descrição detalhada — quem escreve o prompt à mão pode simplesmente pular.
Quão rápido ele é, sem números inflados
Testes públicos divergem bastante, e isso é normal quando ninguém padroniza a medição. Em um notebook com placa RTX 5000 Ada de 16 GB, o registro foi: 29 segundos para gerar uma imagem do zero, 81 segundos para editar por instrução, 116 segundos para remover fundo e 128 segundos para editar usando um ajuste fino extra (LoRA). A própria Tom's Hardware relatou uma conversão de um megapixel em cerca de 5 segundos numa RTX 4090.
Do outro lado da régua, um teste independente em um Mac de 48 GB de memória unificada mediu 143,5 segundos de mediana em imagens de 1024 × 1024, e 343,5 segundos em 1536 × 1536, ao longo de 20 gerações. A conclusão honesta: não é instantâneo, e em edição ele é mais lento que o Flux Klein, que era o favorito anterior da turma. É o preço de fazer isso na sua máquina, de graça, sem fila e sem limite.
O ecossistema chegou no mesmo dia
Uma coisa que quase sempre atrasa a vida de quem roda modelo aberto é o suporte das ferramentas. Aqui não atrasou: no dia do lançamento, o Qwen Image 2.1 já funcionava no Diffusers (a biblioteca de referência do Hugging Face), no ComfyUI (com três fluxos prontos: texto para imagem, edição e remoção de fundo), no vLLM-Omni, no SGLang e no LightX2V. No dia seguinte, já existiam versões quantizadas em GGUF — e, em 24 horas, a comunidade já tinha publicado a primeira LoRA.
Esse detalhe diz mais sobre maturidade do ecossistema do que qualquer gráfico de benchmark: o modelo abre e, no mesmo dia, dezenas de ferramentas sabem usá-lo.
O número 1 que precisa de asterisco
A Alibaba anunciou o Qwen Image 2.1 como superior ao Nano Banana 2.0 do Google. No Qwen Image Benchmark — feito pela própria Alibaba, com 5 dimensões, 23 sub-capacidades e 56 facetas, julgado por um modelo de IA do Qwen — o placar ficou 60,2 contra 59,82. Menos de um ponto de diferença, medidos por quem criou o modelo e as perguntas.
Olhando o mesmo ranking público, o GPT Image 2 aparece com 64,69, bem à frente dos dois. E num teste de preferência cega, em que pessoas escolhem a melhor imagem sem saber de quem é, o resultado se inverte: 1.228 para o Qwen contra 1.260 para o Nano Banana 2.0. Traduzindo: primeiro no ranking de casa, segundo no teste cego — e primeiro entre os modelos abertos, tanto em edição quanto em geração. Essa parte é uma vitória real, só menor do que o título sugere.
A letra miúda: aberto não é a mesma coisa que livre
Tem um detalhe no lançamento que o open source do título esconde. Os pesos saem sob a Qwen Research License, que permite uso de pesquisa e avaliação — para usar comercialmente, é preciso negociar uma licença separada com a Alibaba. A comunidade reagiu no próprio fórum do modelo pedindo a volta da licença Apache 2.0, a mesma dos modelos anteriores da família.
A Alibaba esclareceu um ponto importante: as imagens geradas não fazem parte do material licenciado, ou seja, os direitos sobre o arquivo que você criou ficam com você. Na prática: o peso do modelo é restrito, mas o resultado que sai dele é seu. Para quem só quer gerar imagem no próprio computador, isso resolve. Para quem quer colocar o modelo dentro de um produto pago, é hora de ler o contrato antes de escrever código.
O que isso muda para quem produz conteúdo no Brasil
A primeira mudança é de custo. Gerar imagem em nuvem é pagar por imagem; gerar localmente é pagar energia elétrica. Para um pequeno negócio que precisa de 200 fotos de produto com fundo limpo, a diferença não é de porcentagem, é de ordem de grandeza — e sem limite de tentativas, o que muda a forma de trabalhar: dá para experimentar até acertar.
A segunda é de privacidade, e essa conversa é séria no Brasil. Enviar a foto de um cliente, de um produto que ainda não foi lançado ou de um documento interno para o servidor de outra empresa é transferência de dados. Rodando na própria máquina, o arquivo não sai de casa — o que conversa bem com as exigências da LGPD e com o bom senso.
A terceira é a nossa: na esteira de conteúdo da CheriffAI, cada capa de carrossel é gerada por uma API paga, justamente porque o fundo transparente e a qualidade de composição fazem diferença. O Qwen Image 2.1 coloca essa mesma capacidade na mesa por menos de 4 GB de VRAM. O que ele não resolve é o resto do trabalho: instalar, atualizar, manter e saber julgar qualidade. Ferramenta barata não substitui olho treinado — ela só tira o pedágio de quem já sabe o que quer.
O recado maior do lançamento é outro: a fronteira da IA de imagem deixou de ser quem tem o melhor modelo e virou quem consegue rodar o melhor modelo. E, pela primeira vez, essa conta fecha em um computador de casa.