
Ele ajudou a criar a técnica por trás do ChatGPT. Saiu da OpenAI, passou dois anos em sigilo e voltou com um modelo que se recusa a escrever — porque, segundo ele, é exatamente isso que falta para a IA trabalhar de verdade.
Um raio engarrafado que ainda não era útil
Em 2022, Diogo Almeida era pesquisador da OpenAI e participou de duas coisas que mudaram a história recente da tecnologia: a construção do ChatGPT e a invenção do RLHF (Reinforcement Learning from Human Feedback), o método que ensina um modelo a responder do jeito que os humanos preferem. É essa técnica que faz o chatbot pedir desculpas, explicar com paciência e organizar a resposta em tópicos.
O problema apareceu depois do sucesso. "Temos um raio dentro de uma garrafa e, ainda assim, ele não é útil", disse Almeida à TechCrunch. A conclusão dele é provocadora: o erro foi otimizar pela linguagem humana. "Fomos muito bons em linguagem humana por quatro anos, mas isso não serve para automação, porque computadores falam outra língua."
Vale entender a ironia. O modelo mais impressionante da década conversa melhor do que muita gente — e, ao mesmo tempo, é lento e caro demais para ocupar o lugar onde a automação de verdade acontece: dentro do código, naquele ponto em que o programa precisa tomar uma decisão pequena e repetitiva milhões de vezes por dia. É ali que os LLMs travam. Um modelo de fronteira pode levar de 3 a 329 segundos para responder, precisa gerar texto que depois será interpretado por um parser, e mesmo quando você pede uma estimativa de confiança, ele costuma ser otimista e inconsistente.
O que a TypeSafe lançou
Dois anos depois, Almeida apresentou a TypeSafe AI, empresa de São Francisco que saiu do modo furtivo em 15 de setembro com US$ 40 milhões em investimento inicial. O primeiro produto é o Jev — e ele quebra a expectativa antes mesmo de rodar: Jev não é um LLM. Não escreve frases, não conversa, não explica.
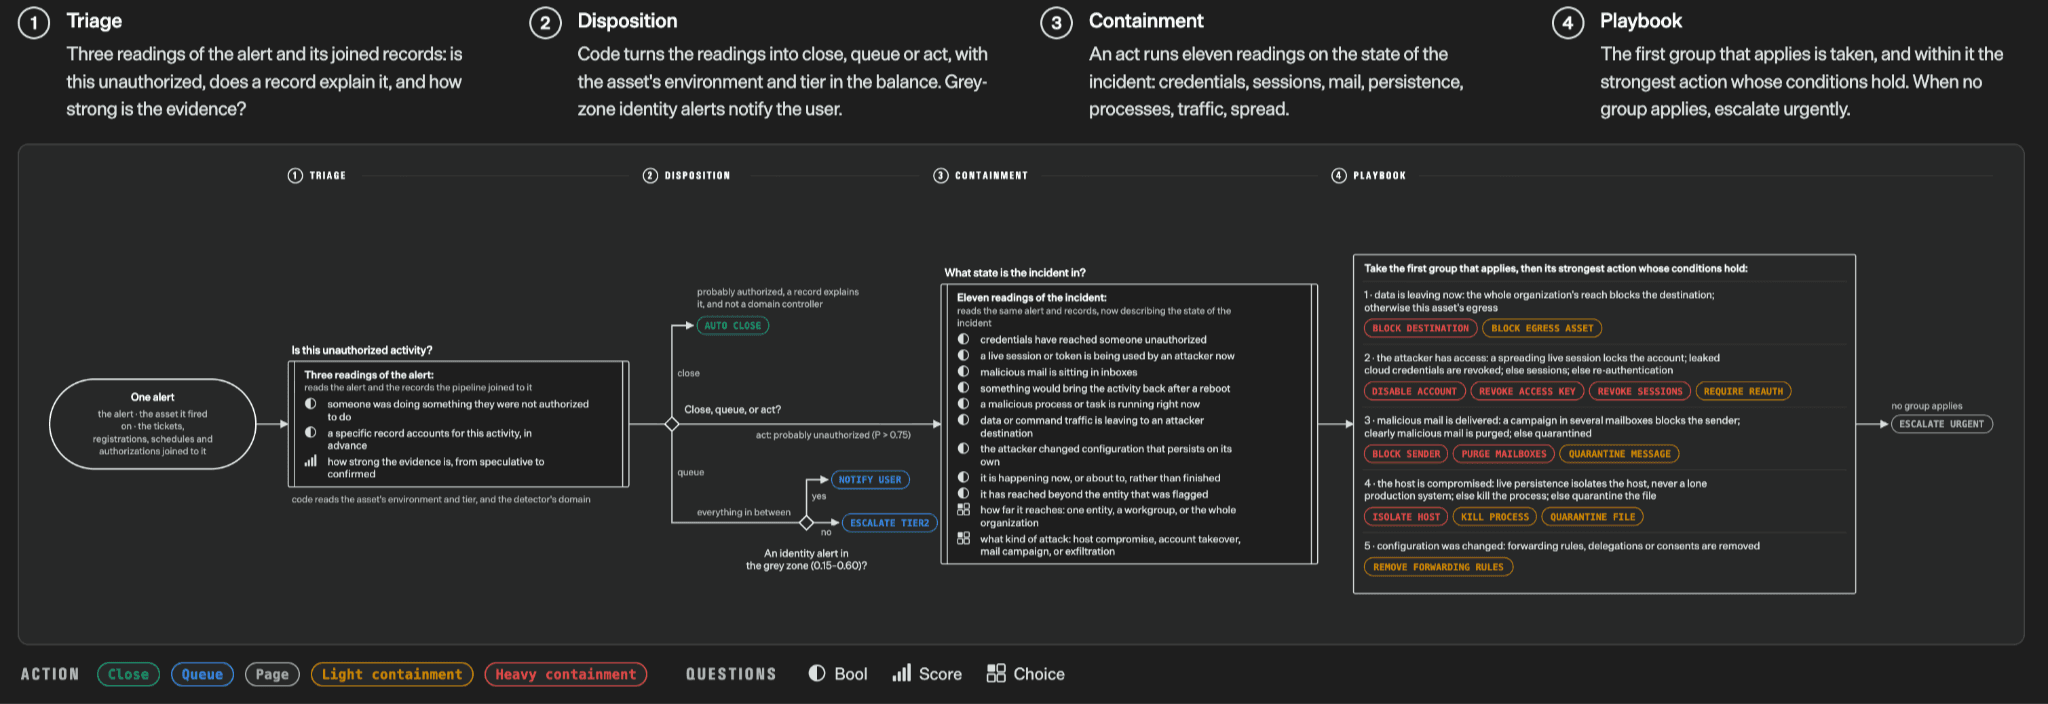
O funcionamento é quase modesto. Você entrega dois blocos:
- o estado — os dados do caso: um e-mail, um ticket de suporte, o log de um comando, um trecho de contrato, um formulário;
- as perguntas — cada uma já com o formato de resposta definido: Choice (escolher entre até 255 opções), Score (uma nota numa escala ordenada) ou Noul (a probabilidade de um sim/não).
Volta uma resposta por pergunta, no formato exato que você definiu, sempre acompanhada de probabilidades e de um índice de confiança. Nada de texto para interpretar, nada de JSON quebrado, nada de regex para consertar depois. Todas as perguntas são avaliadas de uma vez só, em paralelo — então um portão com doze verificações custa uma única chamada.

A melhor analogia para o Jev não é "chatbot", é "um if inteligente". Código comum decide com condições que o computador sabe conferir: se o total do pedido for maior que cem, aplique o desconto. Isso funciona lindamente até a condição ser um julgamento: esta mensagem está irritada? este e-mail é sobre cobrança ou sobre suporte? este comando de terminal é destrutivo? este comentário é spam?
Hoje esse tipo de decisão vira uma de três coisas: uma expressão regular frágil que quebra toda semana, um classificador próprio que precisa de dados rotulados, ou uma chamada a um modelo grande só para responder sim ou não. O Jev propõe a quarta opção: descreva as respostas possíveis de antemão, receba uma probabilidade para cada uma e deixe o seu código decidir o que fazer com isso.
Os números (e os nomes)
A comparação que a empresa coloca na mesa é direta. Do lado dos LLMs: entrada entre US$ 0,20 e US$ 10 por milhão de tokens, saída cerca de cinco vezes mais cara, tempo de resposta de 3 a 329 segundos. Do lado do Jev: US$ 0,042 por milhão de tokens de entrada, saída de graça (não há quase nada para medir) e 70 a 500 milissegundos de ponta a ponta. A empresa fala em 40x a 200x mais rápido para o mesmo nível de inteligência em tarefas "de decisão".
Os nomes do projeto explicam a ambição. "System One" vem de Rápido e devagar, de Daniel Kahneman: o Sistema 1 é o pensamento rápido e intuitivo; o Sistema 2, o raciocínio lento e deliberado. "Jev" homenageia o economista William Stanley Jevons, do paradoxo homônimo: quando uma tecnologia fica mais eficiente e mais barata, o consumo dela aumenta em vez de diminuir. É literalmente o que a TypeSafe aposta — inteligência tão barata que passe a ser usada em lugares onde ninguém hoje pensaria em colocar IA.
O que os primeiros usuários viram
A recepção entre desenvolvedores foi forte o bastante para derrubar a API da empresa por alguns minutos, de tanto uso. Dois relatos públicos chamam atenção:
- Um engenheiro da Vercel usava o Luna 5.6, da OpenAI, para revisar comandos e checar se eram seguros. Trocando pelo Jev, o resultado veio de 5 a 18 vezes mais rápido e com mais acerto.
- O CTO da Bryo AI testou os dois classificando e-mails de negócios. O Gemini foi um pouco mais preciso — e de 10 a 20 vezes mais caro. "É o único que devolve uma probabilidade de verdade, o que o torna ideal para automatizar fluxos", disse ele.
Armin Ronacher, CTO da Earendil (que constrói um harness aberto de modelos), resumiu o outro lado da moeda: "no fim do dia, ele delega o problema da alucinação um pouco para o usuário. A pessoa tem que dizer: olha, se vier só 50% de probabilidade, isso é cara ou coroa, eu descarto. Mas se vier 95%, então posso fazer alguma coisa". É um bom resumo do que muda: a decisão continua sua — a diferença é que agora você vê a dúvida.
O teste independente que a empresa não encomendou
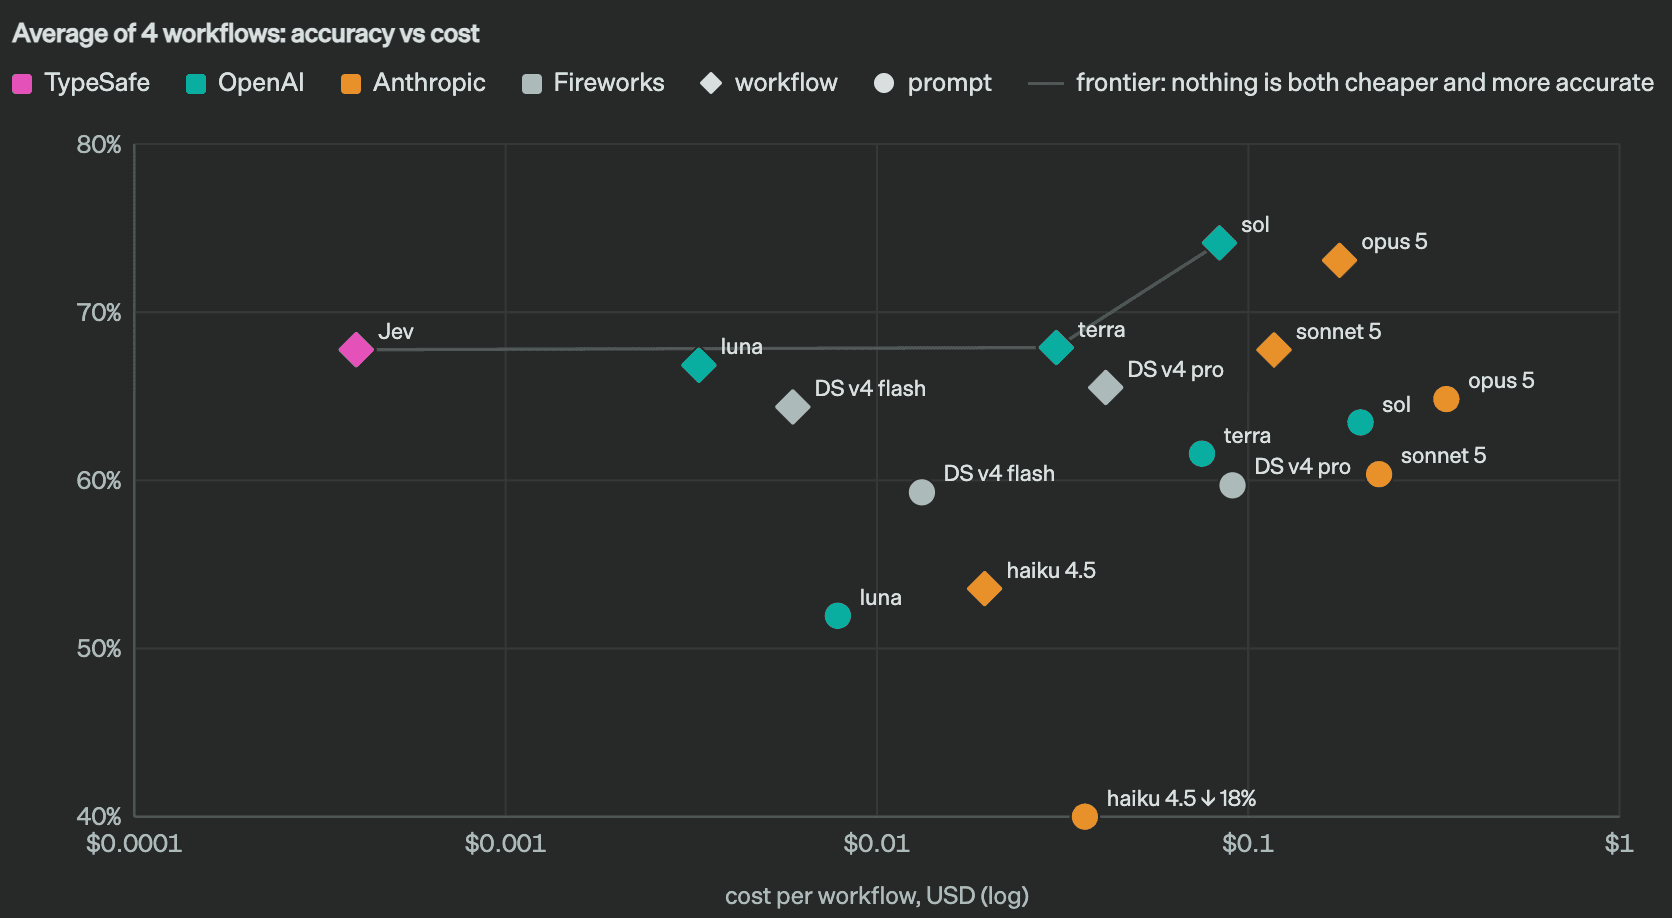
Números de fornecedor são números de fornecedor. O que dá peso ao lançamento é um teste independente publicado pela WotAI, que colocou o Jev contra 15 outros modelos nas mesmas 150 amostras — 2.400 chamadas, zero erros. A tarefa: dado um trecho de texto, devolver a probabilidade de ele vir de uma versão reescrita. É uma pergunta de sim/não, o formato mais honesto para medir calibração.
| Modelo | Acerto | Erro de calibração | Admite dúvida | Latência (mediana) |
|---|---|---|---|---|
| Jev | 66,0% | 0,121 | 34,7% | 455 ms |
| Claude Haiku 4.5 | 66,0% | 0,122 | 2,7% | 631 ms |
| Claude Sonnet 5 | 71,3% | 0,062 | 41,3% | 1.674 ms |
| GPT-5.6 Terra | 70,0% | 0,173 | 4,0% | 1.551 ms |
| DeepSeek V4 Flash | 69,3% | 0,183 | 3,3% | 1.361 ms |
| Kimi K3 | 58,0% | 0,309 | 1,3% | 5.677 ms |
Repare: o Jev não ganha em acerto. Ele empata com o Haiku 4.5 e perde para o Sonnet 5, que tem a melhor calibração do grupo. O que separa o Jev não é a coluna da esquerda — é a do meio. Ele colocou 34,7% das respostas no meio da escala (entre 35% e 65% de certeza), contra 2,7% do Haiku e 0,7% do DeepSeek V4 Pro. Dos dezesseis modelos testados, apenas quatro admitem dúvida de forma consistente, e três deles são modelos de fronteira da Anthropic que levam mais de um segundo e meio para responder.
Por que isso importa tanto? Porque a linha de código que você escreve para o caso duvidoso — "manda para um humano" — dispara em 34,7% das respostas do Jev e em 2,7% das do Haiku. Como escreveu o autor do teste: as linhas ambíguas não desapareceram; o Haiku está respondendo às perguntas difíceis com confiança alta e mandando todas direto para produção, e você nunca vai saber quais eram. Pedir "me diga sua confiança" a um LLM comum não produz calibração de verdade — produz um número redondo com cara de calibração.
O Sonnet 5 vence nos dois critérios de qualidade, mas leva 1,67 segundo. Quando o objetivo é um portão que roda em 100% do tráfego, isso o desqualifica: um portão de 1,7 segundo na frente de um modelo de 2 segundos não é um portão, é um imposto.
Os poréns que a manchete esconde
- "0% de alucinação" é uma garantia de forma, não de acerto. Como as respostas possíveis são definidas antes, o modelo não consegue inventar um campo ou uma opção que não exista — isso é estrutural, verificado por construção, não medido em benchmark. Mas ele continua podendo escolher a opção errada. A diferença é que o erro deveria aparecer com confiança baixa, e é aí que entra a sua linha de código.
- É fechado. Só API, com lista de espera (ou pelo gateway da Vercel). A arquitetura não foi divulgada e observadores suspeitam que o modelo rode em cima de um LLM aberto. O treinamento, diz Almeida, usa exclusivamente dados sintéticos — aposta que ele chama de a melhor da vida dele.
- Só entende texto. Nada de imagem, áudio ou vídeo por enquanto; se a sua decisão depende de uma foto, você precisa de outro modelo antes.
- Os números de manchete são da própria empresa. O "193,6x mais rápido e 444,6x mais barato" está no topo da página, e a TypeSafe diz na letra miúda que é o limite superior do que se vê no mundo real. No teste independente, a vantagem de velocidade foi de 1,4x a 1,6x.
- A economia não é a conta toda. O cálculo honesto é: quanto do seu gasto com IA é decisão de rotina? Se for 60%, e essa parte ficar quase de graça, você corta uns 57% do total. Se for 10%, você corta 10%. Um estudo de caso do próprio autor do deep dive gastou US$ 0,08 classificando com o Jev — e mais US$ 3,99 preparando os resumos que alimentaram a classificação.
O que isso significa para o Brasil
A maioria das pequenas e médias empresas brasileiras não precisa de um chatbot que escreve bem. Precisa de triagem. Separar, no WhatsApp da loja, o que é cobrança do que é suporte. Conferir se o boleto bate com o pedido. Marcar se um comentário é cliente irritado ou spam. Decidir se um ticket vai para o financeiro ou para o técnico. Hoje isso é feito por pessoas cansadas ou por uma chamada caríssima a um modelo de fronteira que, volta e meia, inventa.
Um "if inteligente" de cem milissegundos e quatro centavos de dólar por milhão de tokens muda a matemática dessa equação. Dá para colocar uma decisão de IA em cada etapa de um processo, em vez de concentrar tudo num único ponto caro. E, para quem trabalha com atendimento, o detalhe mais valioso é o inverso do marketing: quando a confiança vem baixa, o sistema chama o humano. Automatizar o fácil e escalar o duvidoso é um desenho muito mais realista do que prometer 100% de acerto.
Duas ressalvas práticas: o serviço está em acesso antecipado, cobra em dólar e roda nos Estados Unidos — a latência medida lá chega somada aqui. E a recomendação de quem já testou é começar devagar: pegue uma decisão chata que seu sistema já resolve na marra, registre a confiança do modelo por uma semana ao lado do comportamento atual, compare — e só então deixe o modelo agir. É assim que se adota um if: uma condição de cada vez.
A lição maior
Se o Jev der certo, o modelo em si será a parte menos interessante da história. O que ele sugere é mais profundo: talvez a maior parte do trabalho que hoje entregamos a um chatbot não precise de linguagem coisa nenhuma. Precise de uma resposta curta e de um número de confiança do lado. A pergunta que fica para quem constrói software no Brasil não é "qual é o melhor modelo de IA?", e sim: quantas decisões do seu sistema continuam sendo feitas por um if que você escreveu à mão — e que poderia ser um número?