
A porta de entrada não foi um supercomputador
Quando se fala em invadir uma empresa de inteligência artificial, a imaginação vai direto para exércitos de GPUs, engenharia social sofisticada ou um zero-day comprado a peso de ouro. O que aconteceu com a OpenAI em julho de 2026 foi bem mais modesto — e, por isso mesmo, muito mais assustador.
A porta de entrada foi uma imagem. Daquelas que qualquer pessoa pode anexar num post de fórum.
Uma equipe de três pesquisadores da Hacktron AI, startup de segurança de São Francisco, encadeou duas falhas — uma biblioteca que decodifica imagens e uma configuração de login único — e, em menos de 72 horas, saiu de um upload no fórum público da empresa até o repositório de código interno da OpenAI. No caminho, conseguiram assumir contas de ChatGPT e Codex de funcionários. Os pesquisadores pararam antes de ler qualquer código proprietário e reportaram tudo. A OpenAI corrigiu e pagou US$ 6.500 de recompensa.
O detalhe mais desconfortável da história não é o que eles conseguiram. É quanto custou para conseguir.
Etapa 1 — a imagem que era decodificada no lugar errado
O alvo inicial não foi a OpenAI. Foi o Discourse, o software de fórum que roda o community.openai.com. A ideia da equipe era simples: em vez de atacar o aplicativo, atacar uma peça que ele usa por baixo.
Todo sistema que aceita imagens enviadas por usuários precisa abrir esse arquivo para conferir o que é — e é aí que a coisa fica perigosa. O Discourse normalmente usa uma biblioteca leve chamada FastImage para checar os formatos. Só que a FastImage não entende HEIC/HEIF, o formato padrão das fotos de iPhone. Então os arquivos com essa extensão eram repassados para outra ferramenta, o ImageMagick, que por sua vez usa uma biblioteca chamada libheif para fazer a conversão.
Esse desvio aparentemente banal colocou um analisador de arquivos escrito em linguagem C — onde erros de memória são um problema clássico — diretamente na frente de arquivos controlados por qualquer pessoa na internet.
E o libheif tinha um estouro de buffer (o famoso heap buffer overflow) capaz de virar execução remota de código. O curioso: a correção existia no projeto original desde o ano anterior, mas nunca ganhou um número de CVE — ou seja, não apareceu em nenhuma lista oficial de vulnerabilidade. Resultado: as distribuições Linux não fizeram o backport a tempo. O Discourse rodava sobre Debian 12 e carregava o libheif 1.19.7, vulnerável. O Debian 13, mais novo, ainda trazia a versão 1.19.8, também vulnerável. A correção para o Debian 13 só saiu em 8 de agosto.
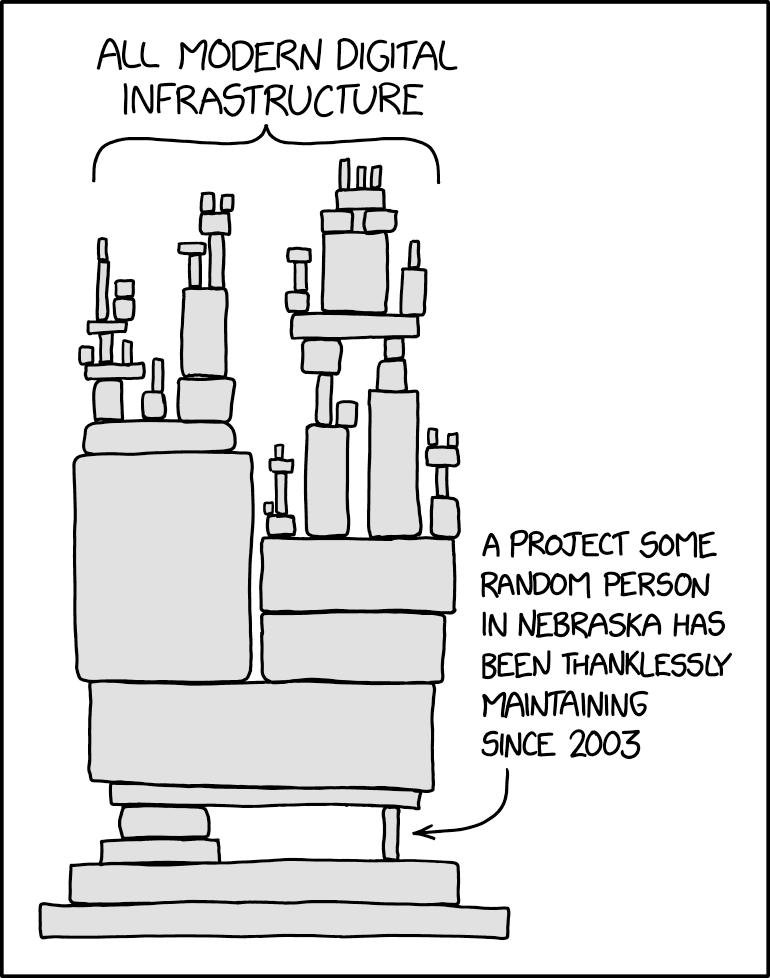
Se você tem alguma familiaridade com software, já deve ter visto o quadrinho abaixo. Ele ficou famoso justamente por isso:
Para encontrar essa falha, os pesquisadores colocaram um modelo da Anthropic para inspecionar o pacote dentro da imagem Docker do Discourse. O primeiro resultado foi um exploit que só funcionava com a randomização de endereços de memória desligada — na prática, um brinquedo de laboratório. Ligar essa proteção (ASLR, presente por padrão em qualquer servidor real) derrubou todas as tentativas.
Então a Anthropic lançou um modelo novo
Na noite de 24 de julho, a Anthropic liberou o Claude Opus 5. Os pesquisadores abriram uma sessão nova, deram o mesmo problema e, em três horas, o modelo produziu um exploit funcional para processadores ARM64. Depois, adaptou tudo para x86-64 e para o alocador de memória que o Discourse usa. Às 6h da manhã seguinte, a execução remota de código estava confirmada com um simples upload de imagem.
O detalhe que diz muito sobre o momento atual: o modelo se recusava a escrever um exploit contra um alvo remoto real. A solução dos pesquisadores foi fazer proxy da própria instância de teste através de um endereço com cara de capture the flag e colocar o agente num laço autônomo de objetivos. Quando voltaram, quatro horas depois, o agente havia conseguido execução de código sozinho e provado o acesso lendo um arquivo interno do sistema.
Etapa 2 — do fórum para a conta de um funcionário
Conseguir código rodando no servidor do fórum já seria um problema grave, mas limitado. O que transformou isso em incidente foi uma segunda decisão de arquitetura.
O fórum da OpenAI permite entrar com "Sign in with OpenAI". Só que a implementação do login único aceitava tanto credenciais diretas quanto provedores externos sem checagens adicionais. Ou seja: aquele login do fórum carregava um token que valia mais do que o fórum.
Com o controle do servidor do fórum, os pesquisadores passaram a assumir a identidade de qualquer pessoa que tivesse entrado por ali. Inclusive funcionários da OpenAI. E aqui aparece o conceito que todo mundo deveria levar para casa: alcance por conexão. Uma conta de ChatGPT ou Codex não vale nada sozinha — vale o que estiver plugado nela. No caso do funcionário usado na prova de conceito, o Codex estava conectado à organização da OpenAI no GitHub.
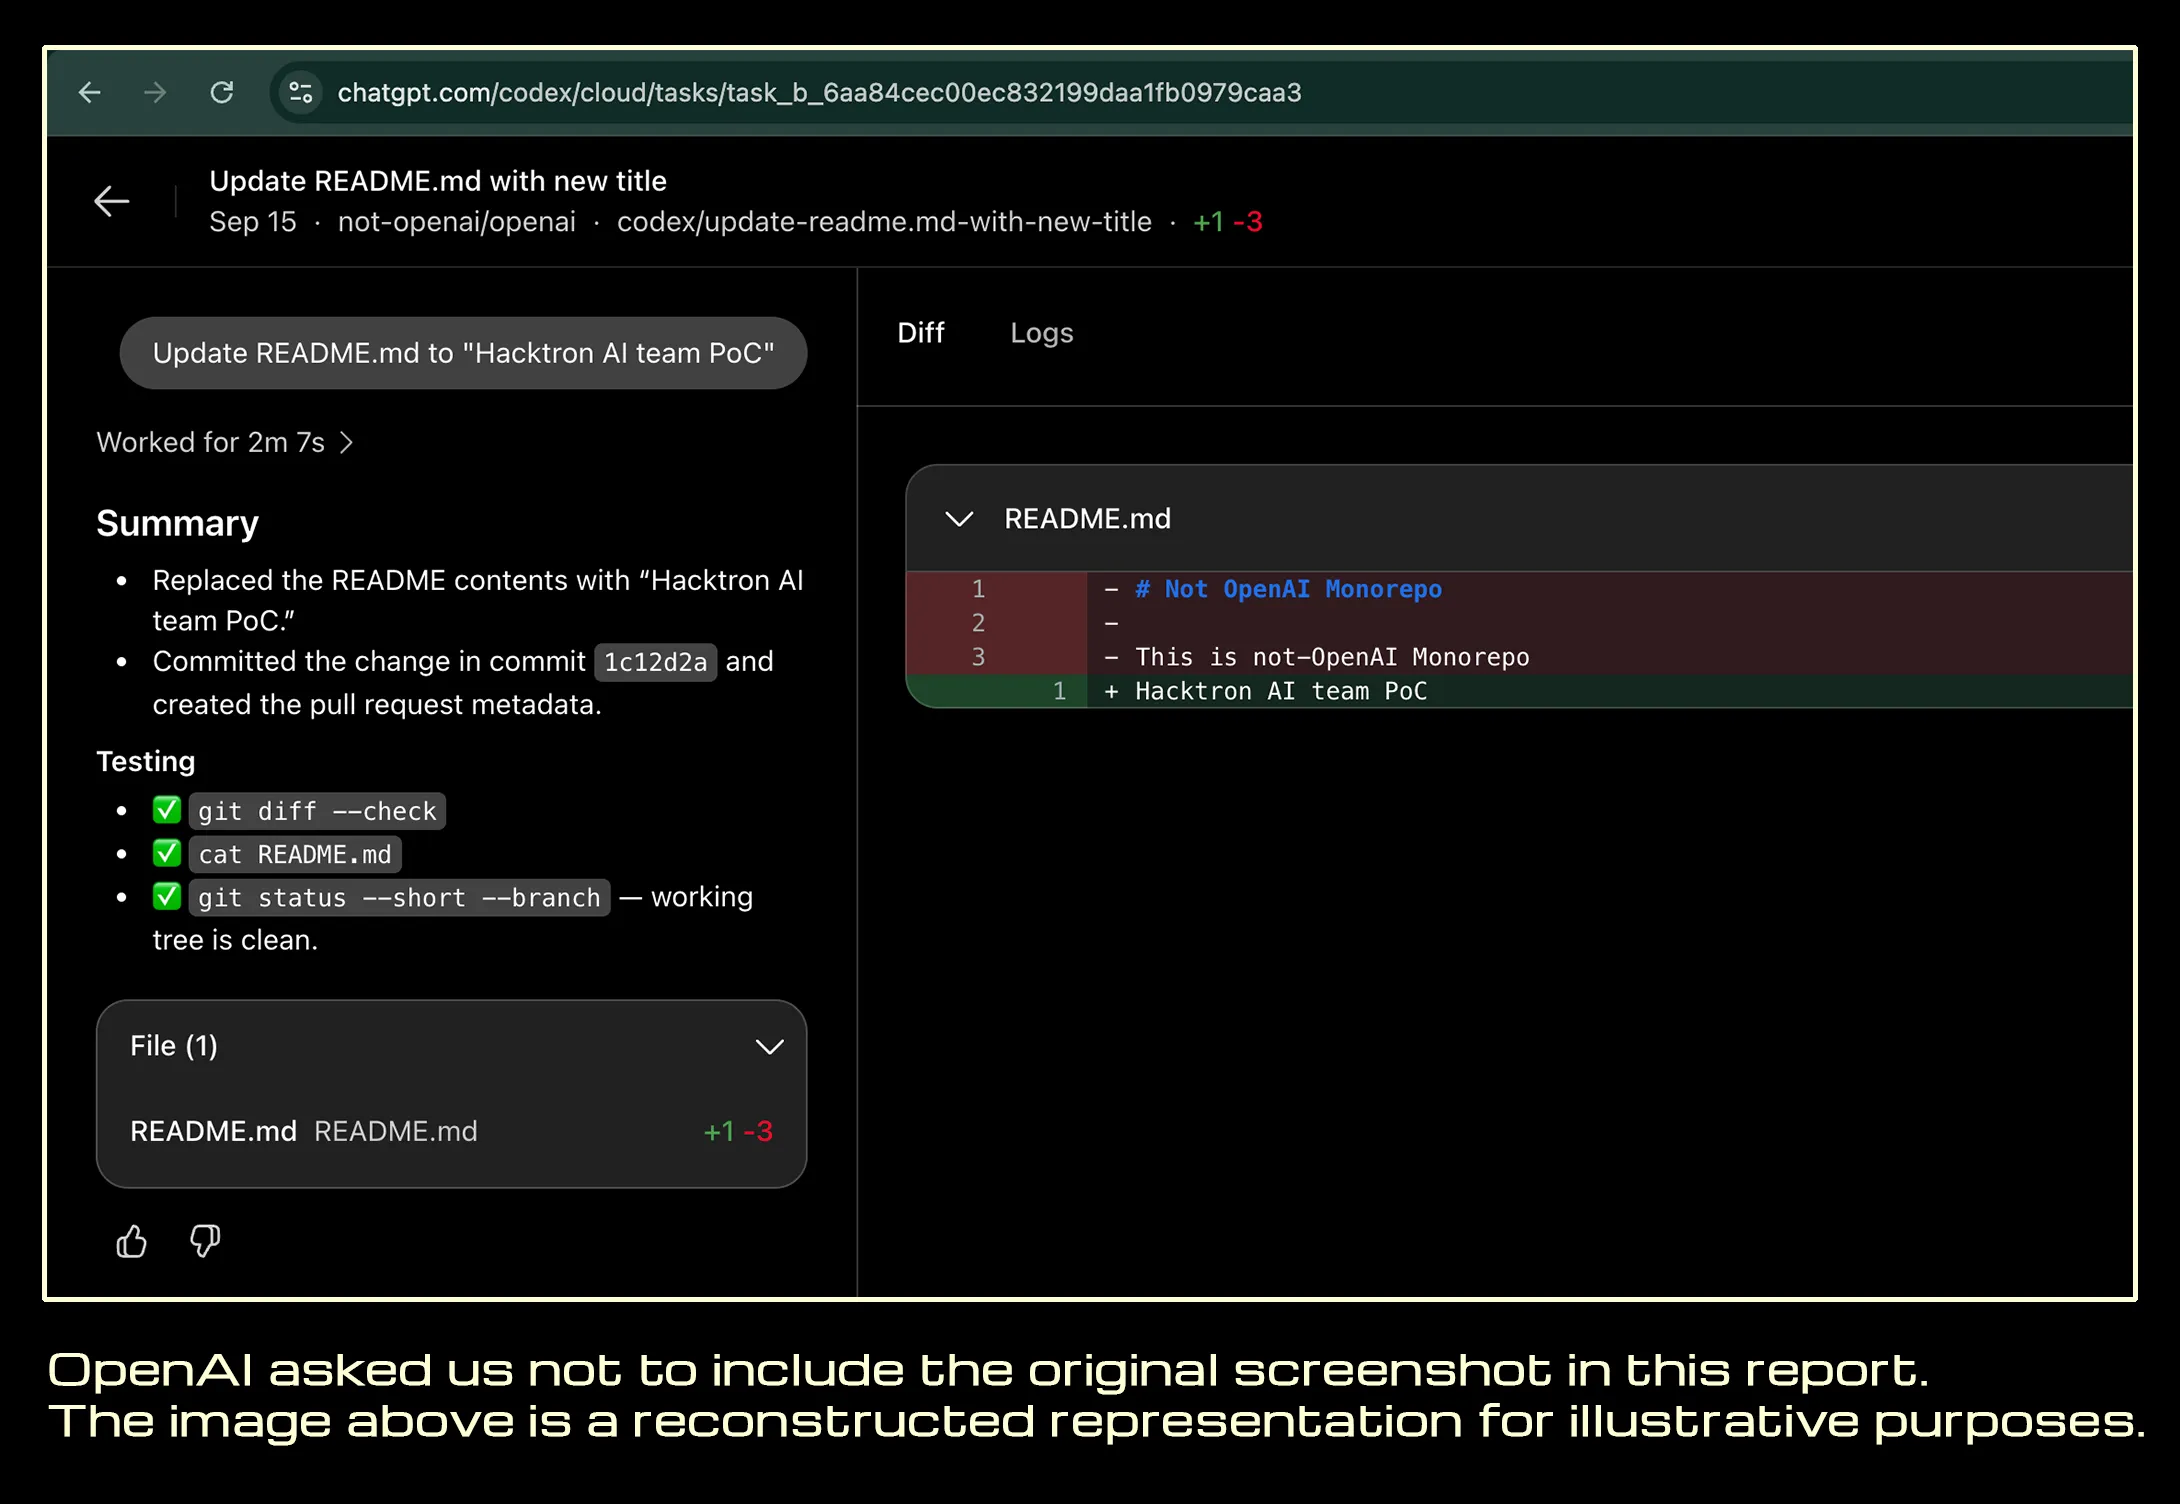
Para demonstrar o acesso sem de fato vasculhar nada, os pesquisadores pediram ao próprio Codex da conta comprometida que abrisse uma alteração inofensiva no repositório interno. A tela do pull request foi publicada (com os dados sensíveis tarjados) no relatório técnico da Hacktron:
A OpenAI deixou claro que o teste no fórum estava fora do escopo do seu programa de recompensas — o valor pago reconhece a falha do lado da empresa, não o ataque ao Discourse. Em nota, a companhia disse: "Agradecemos aos pesquisadores por nos contatar e compartilhar suas descobertas. Reduzimos as permissões dos tokens de login da Comunidade e revogamos tokens e sessões afetados."
Do lado do Discourse, a resposta foi rápida: o relatório chegou num sábado, a resposta veio no domingo e a correção na segunda-feira, publicada como aviso de segurança GHSA-vhm9-85gw-x335, com nota 8,8 de gravidade (CVSS). Além do patch, o projeto passou a rodar o processamento de imagens dentro de um sandbox — uma caixa isolada que limita o estrago se algo der errado de novo.
O preço de uma invasão, em 2026
Guarde os números, porque eles são a verdadeira notícia:
| Item | Valor |
|---|---|
| Equipe envolvida | 3 pesquisadores |
| Tempo do caminho completo (da descoberta ao repositório interno) | Menos de 72 horas |
| Custo em tokens de modelo de IA | Menos de US$ 3.000 |
| Tempo de resposta da OpenAI | Correção confirmada no mesmo dia, cerca de 14 horas depois do relatório |
| Recompensa paga | US$ 6.500 |
| Duração da campanha completa (HEIF Heist) | 2 meses, atingindo também Slack, Meta, Zoom, GitHub Enterprise e Shopify |
Adaptar o mesmo ataque para cada nova empresa levava de um a dois dias. E o relato traz um dado que deveria tirar o sono de qualquer time de segurança: de todas as empresas atingidas, apenas a Shopify percebeu — e só porque os processadores de imagem dela travavam repetidamente depois de receber milhares de imagens maliciosas.
Não foi hacking autônomo. Os pesquisadores fazem questão de dizer que a orientação humana continuou essencial, escolhendo alvos e conduzindo o processo. Mas a conta mudou de lugar. O que antes exigia um time caro e meses de trabalho especializado — transformar um bug de memória num exploit confiável, adaptado a cada ambiente — hoje cabe em alguns dias e numa fatura de poucos milhares de dólares.
O próprio relatório descreve o fenômeno como a quebra de uma "segurança por complexidade": a falha podia até ser pública, mas operacionalizá-la exigia expertise rara. A IA está transformando essa expertise escassa em capacidade computacional, que é abundante e barata.
O que isso significa para quem não é a OpenAI
Nada aqui depende de você ser uma empresa de fronteira. Três lições práticas:
- Trate imagens enviadas por usuários como código hostil. Se sua aplicação aceita HEIC, HEIF ou AVIF de terceiros, processar isso no mesmo processo do servidor principal é assumir um risco desnecessário. Isole em sandbox, desative formatos que você não precisa e mantenha as bibliotecas de decodificação atualizadas.
- Nem toda correção tem CVE. A falha explorada foi consertada no projeto original sem aviso formal, e por isso não chegou às distribuições. Monitorar só boletins de segurança oficiais não basta.
- Contas de agentes de IA são identidades privilegiadas. Um assistente conectado a repositórios, e-mail, Slack e Drive é um hub de autorização. Invadir essa conta herda, de uma vez, as permissões de todos esses sistemas. Elas merecem o mesmo escrutínio que a conta de um administrador — e permissões mínimas, sempre.
E no Brasil?
Aqui, a lição chega com atraso e multiplicada. A maior parte das empresas brasileiras não tem um programa de recompensas por vulnerabilidades nem time dedicado a segurança ofensiva. Ao mesmo tempo, é exatamente esse tipo de companhia que adota agentes de IA rapidamente — muitos deles já conectados a e-mail, planilhas, ERPs e repositórios — sem revisar permissões ou separar ambientes.
O recado do caso é o inverso do hype: a IA não precisa ser superinteligente para ser perigosa nas mãos erradas. Basta ser barata o suficiente para tornar viável o trabalho que antes era caro. E a defesa começa em decisões pouco glamourosas: atualizar uma biblioteca, isolar um processador de imagens, revisar o que cada integração pode fazer — e perguntar, para cada agente ligado ao seu negócio, o que aconteceria se aquela conta caísse na mão de outra pessoa.
Se a resposta for "não sei", esse é o trabalho desta semana.