
Imagine um modelo de inteligência artificial que cabe em um único arquivo de 8 megabytes — menos que uma foto do celular — roda numa plaquinha de automação que custa o preço de um lanche e, ainda assim, acerta comandos de celular melhor do que modelos mil vezes maiores. Parece exagero de marketing? É exatamente o que a Cactus Compute está colocando no ar esta semana com o Needle 3.
O anúncio apareceu no Hacker News como um caso de "Show HN" (quando o próprio criador expõe o projeto para a comunidade criticar) e passou de 200 pontos e 89 comentários em menos de um dia. O repositório já tem mais de 11 mil estrelas no GitHub e licença Apache 2.0 — ou seja, é aberto de verdade. A proposta é radical: em vez de tentar ser um "chatbot sabichão", o Needle desiste de conversar e se especializa em executar: chamar funções, extrair dados e transformar linguagem solta em JSON.
Um modelo que troca conversa por ação
A ideia central é simples de entender. Quando você diz "ligue a luz do quarto e deixe o brilho em 30%", não existe conhecimento de mundo difícil ali — existe um mapeamento entre uma frase bagunçada e uma função com parâmetros tipados. Fazer isso bem não exige bilhões de parâmetros: exige arquitetura enxuta e treino focado.
O Needle 3 é exatamente essa aposta. Ele tem três tarefas declaradas:
- Chamada de ferramentas — a partir das funções que o seu aplicativo expõe, ele escolhe a certa e preenche cada argumento. Pede duas coisas, recebe duas chamadas na ordem. Pede algo que nenhuma ferramenta cobre, recebe uma lista vazia — não um chute.
- Extração estruturada — você declara o formato (uma nota fiscal, um agendamento, uma notificação) e entrega texto sujo; ele devolve campos tipados. Uma gramática byte a byte compilada do seu esquema obriga a saída a ser sempre válida.
- Embeddings — o mesmo modelo transforma frases em vetores, permitindo busca semântica e roteamento 100% no aparelho, sem mandar nada para a nuvem.
Os números que fazem a comunidade parar
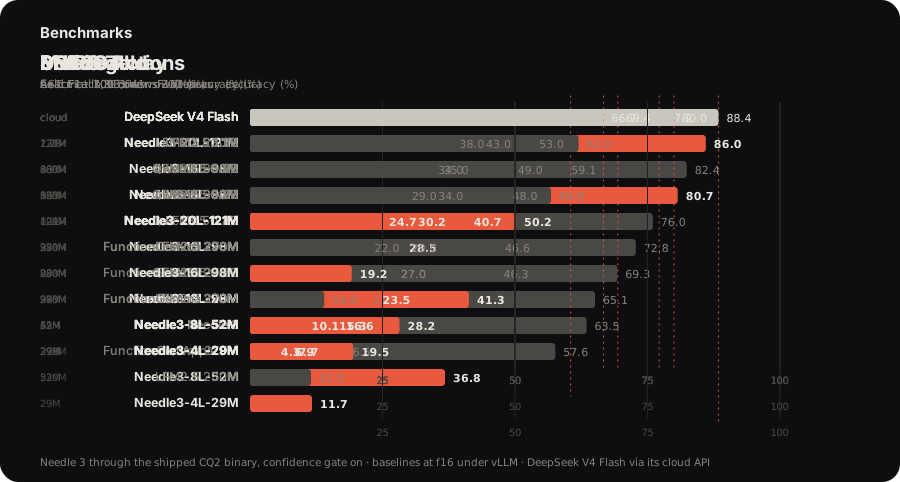
Na prova Mobile Actions (961 comandos de celular pontuados pela chamada exata), o Needle 3 de 20 camadas chega a 86,0 rodando no próprio binário de 2 bits. No mesmo teste, o LFM2.5 de 1,2 bilhão de parâmetros fica em 82,4, o Qwen3.5 de 0,8 bilhão em 76,0 e o modelo nativo da Apple, no aparelho, em 57,6 — todos em precisão total (f16). Traduzindo: um modelo até 10 vezes menor, comprimido a 2 bits, vence quem roda em 16 bits.
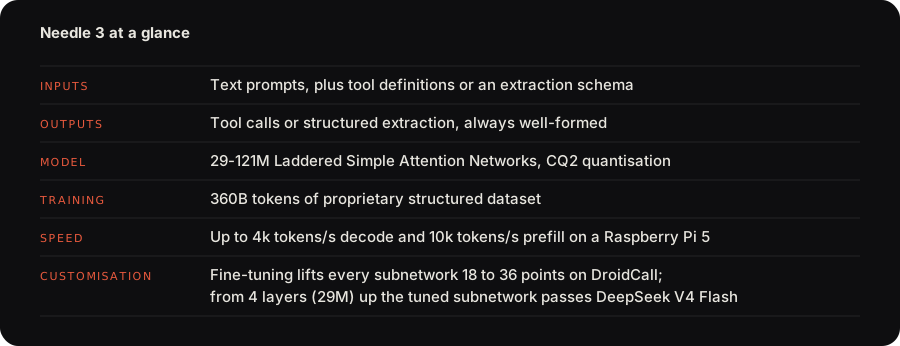
A velocidade também impressiona, porque velocidade é o que separa "demo bonita" de "produto usável". Num Raspberry Pi 5 — um computador de placa única de US$ 60, sem GPU e sem NPU — o Needle 3 gera entre 400 e 4.000 tokens por segundo e processa a entrada a até 10.000 tokens por segundo. O consumo de memória de uma sessão inteira fica em torno de 28 MB, o que faz o modelo caber em microcontroladores como o ESP32-S3, a plaquinha que está dentro de lâmpada inteligente, sensor de umidade e fechadura eletrônica.
A escada de inteligência (e por que ela é a parte mais interessante)
O truque de engenharia que faz esse modelo funcionar tem nome: intelligence laddering, algo como "escada de inteligência". Em vez de treinar nove modelos diferentes, a equipe treinou um único conjunto de pesos em que cada profundidade, de 2 a 20 camadas, é um modelo completo e utilizável. O desenvolvedor escolhe o degrau: uma fechadura que só liga e desliga usa 2 camadas; um assistente de carro usa 20.
Isso é possível porque a arquitetura é enxuta por construção. O FFN denso — a parte que costuma engordar os modelos — foi substituído por um MLP Monarch Hadamard, que faz a mistura não linear com custo muito menor. A memória de n-gramas ("engram") guarda 70,8 milhões dos 121 milhões de parâmetros e é lida por coleta direta, não por multiplicação de matrizes. Resultado: o modelo grande faz a aritmética de um modelo de 50 milhões. A própria página do projeto afirma que essa arquitetura gasta mais que o dobro menos MFLOPs por token que um transformer de configuração equivalente.
"Iguala o DeepSeek V4 Flash"? Com asterisco — e o asterisco importa
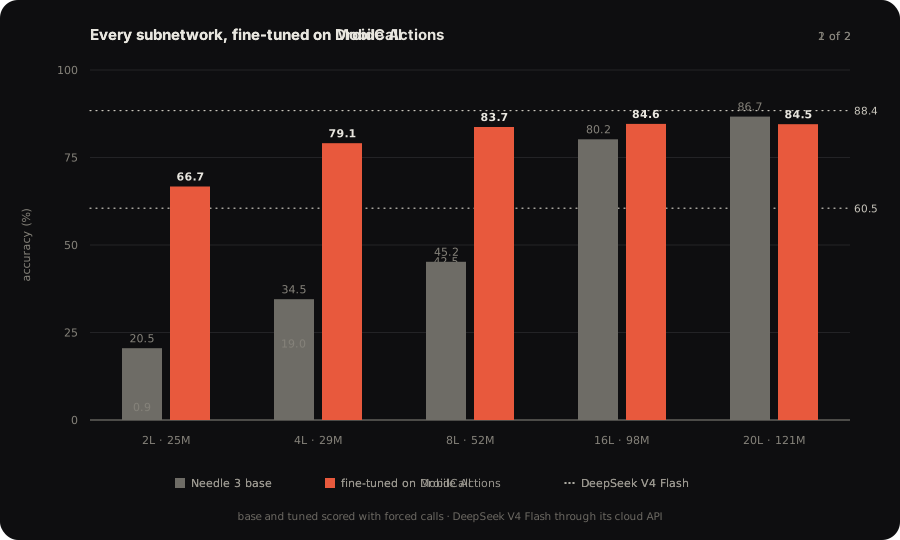
Aqui é onde a manchete precisa de honestidade. O Needle 3 não é melhor que o DeepSeek V4 Flash de forma geral. Ele não conversa, não escreve texto, não raciocina sobre assuntos abertos. O que os dados mostram é outra coisa, bem mais específica: quando você afina o modelo numa tarefa estreita — o exemplo é o DroidCall, 200 pedidos de celular, com apenas uma época de treino — a partir de 4 camadas o submodelo afinado ultrapassa o DeepSeek V4 Flash, começando em 29 milhões de parâmetros. O ganho médio do ajuste fino é de 18 a 36 pontos em cada degrau da escada.
Ou seja, a mensagem real não é "modelo minúsculo vence modelo gigante". É mais parecida com o que já acontece na indústria de software: especializar é mais barato que generalizar. Se o seu problema cabe numa lista de funções bem definidas, gastar bilhões de parâmetros nele é desperdício de energia, dinheiro e privacidade.
A comunidade testou — e cobrou
E é aí que os 89 comentários do Hacker News ficam valiosos. Vários usuários elogiaram o salto em relação à versão anterior e relataram casos reais funcionando: um pedido em linguagem natural devolvendo um JSON perfeito com duas ações simultâneas (diminuir a luz e aumentar a temperatura), e a combinação com modelos de voz pequenos para atendimento em contextos de baixíssima energia, como carro, barco e automação industrial.
Outros foram duros. Um usuário relatou que, ao testar automação de casa, "está frio" foi interpretado como diminuir a luz — e "preciso de um xixi" virou tocar música, porque "wee" também é um gênero musical. Outro comparou com o FunctionGemma e disse que o modelo "ainda não é capaz o suficiente" para o caso dele. Um terceiro fez a crítica mais útil de todas: que a enxurrada de alegações de "modelo minúsculo vence LLM" acaba escondendo inovações legítimas, e que o mais importante é declarar para que o modelo não serve.
Vale notar a transparência dos próprios autores: no texto de anúncio, eles admitem "não ganhamos em tudo". O Needle traz dois mecanismos que ajudam a lidar com esses erros: uma pontuação de confiança calibrada em cada resposta — se está baixa, a chamada é retida em vez de executada — e gatilhos por expressão regular, para garantir que um pedido crítico sempre chegue à ferramenta certa. Também é justo avisar: a telemetria vem ligada por padrão no binário (desligável com uma variável de ambiente).
Onde isso entra na vida real — e no Brasil
A tese de mercado da Cactus é que a "borda" (edge) de verdade não são Macs e PCs caros. São os mais de 21 bilhões de dispositivos conectados contra cerca de 1,5 bilhão de computadores pessoais. Quatro em cada cinco desses dispositivos custam menos de US$ 200, e é para eles que o Needle aponta.
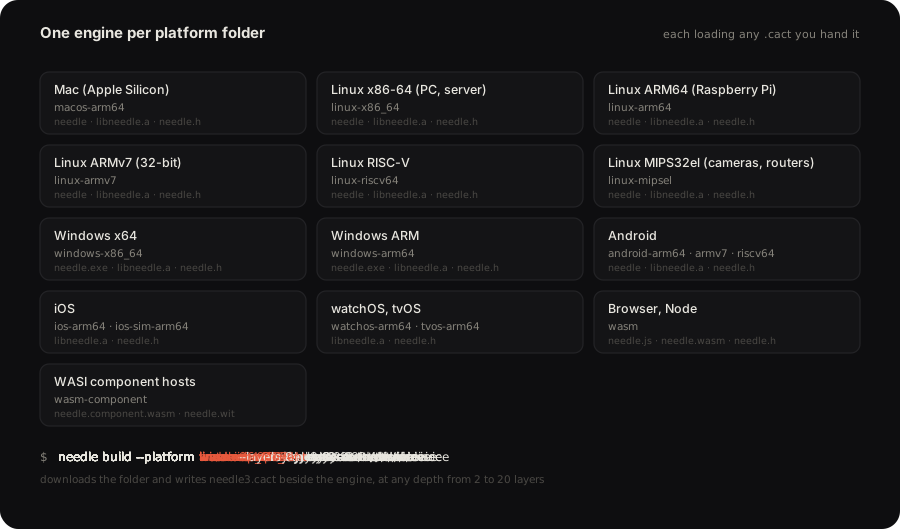
Os alvos incluem: assistentes de casa que executam comandos offline, sem passar por um hub; robôs aspiradores que entendem "limpe a cozinha mas deixe o quarto"; acessórios de AR que resolvem navegação sem celular no meio; centrais de carro que aguentam uma viagem longa inteira de conversa; e a extração de dados na hora: uma notificação do banco virando "comerciante, valor e data". Há também 20 alvos de implantação, de macOS e Windows a Android, iOS, watchOS, tvOS, Linux em RISC-V e MIPS, navegador via WebAssembly e até um componente WASI. Cada alvo leva um motor de menos de 1 MB.
Para o Brasil, há dois pontos que ninguém está discutindo direito. O primeiro é idioma: o Needle 3 fala inglês, francês, espanhol, alemão, holandês, italiano e polonês — português ainda não está na lista. Isso não é um problema pequeno num país onde a maior parte da automação industrial, do agro e do pequeno comércio funciona em português. Mas é justamente por isso que é uma oportunidade: como o modelo é aberto e foi desenhado para ser afinado localmente com LoRA em poucos epochs, criar uma camada em português para funções específicas é um trabalho perfeitamente factível.
O segundo ponto é privacidade e custo: um modelo que roda no aparelho resolve de uma vez o receio de mandar áudio e dados de clientes para servidores estrangeiros (um assunto cada vez mais quente com a LGPD) e o custo recorrente de API por requisição. Para uma pequena oficina, uma clínica ou uma propriedade rural com internet ruim, "IA que funciona sem internet" deixa de ser charme e passa a ser requisito.
O que isso ensina
A grande lição do Needle 3 não é o tamanho do arquivo — é a escolha de abrir mão de capacidade geral em troca de precisão estreita. Durante dois anos, a corrida da IA foi medida em parâmetros e bilhões de dólares de computação. Apostas como essa apontam para um segundo eixo, menos glamouroso e provavelmente mais lucrativo: quem consegue fazer um modelo pequeno o bastante para caber no dispositivo mais barato da mesa, sem perder acerto na tarefa que importa.
Para quem constrói produtos no Brasil, o recado é direto: talvez o seu caso de uso não precise de um modelo de fronteira, e sim de um modelo de 29 MB ajustado nas suas próprias funções, rodando no aparelho do cliente, em português, sem custo por chamada. A parte difícil continua sendo a mesma de sempre — organizar os dados e desenhar bem as ferramentas. Como escreveu um dos comentaristas mais lúcidos do tópico, o dataset é tão importante quanto o modelo, e montar um bom dataset não tem nada de chamativo.
O código e os pesos estão abertos. O degrau mais baixo da escada tem 2 camadas. O convite, para quem quiser aceitar, é começar pequeno.