
Você tem a resposta dentro do seu computador — e não consegue encontrá-la.
Fotos, vídeos, notas de voz de reunião, áudios de cliente, PDFs, slides, prints de tela, trechos de código. A memória digital de qualquer pessoa ou empresa em 2026 virou um arquivo morto gigantesco. E a busca por nome de arquivo só funciona quando você lembra o nome — a busca dentro do texto só funciona quando o conteúdo é texto. Nenhuma das duas responde à pergunta mais natural: onde está aquele áudio em que o cliente explica o problema dele?
Em 6 de outubro de 2026, o Google DeepMind publicou uma peça que ataca exatamente esse buraco: o EmbeddingGemma 2, um modelo aberto de 740 milhões de parâmetros que coloca texto, código, imagem, vídeo e áudio no mesmo espaço de coordenadas — e roda em um celular. O anúncio está no blog do Google, e a leitura técnica ficou num guia para desenvolvedores.
O que é um "embedding", sem jargão
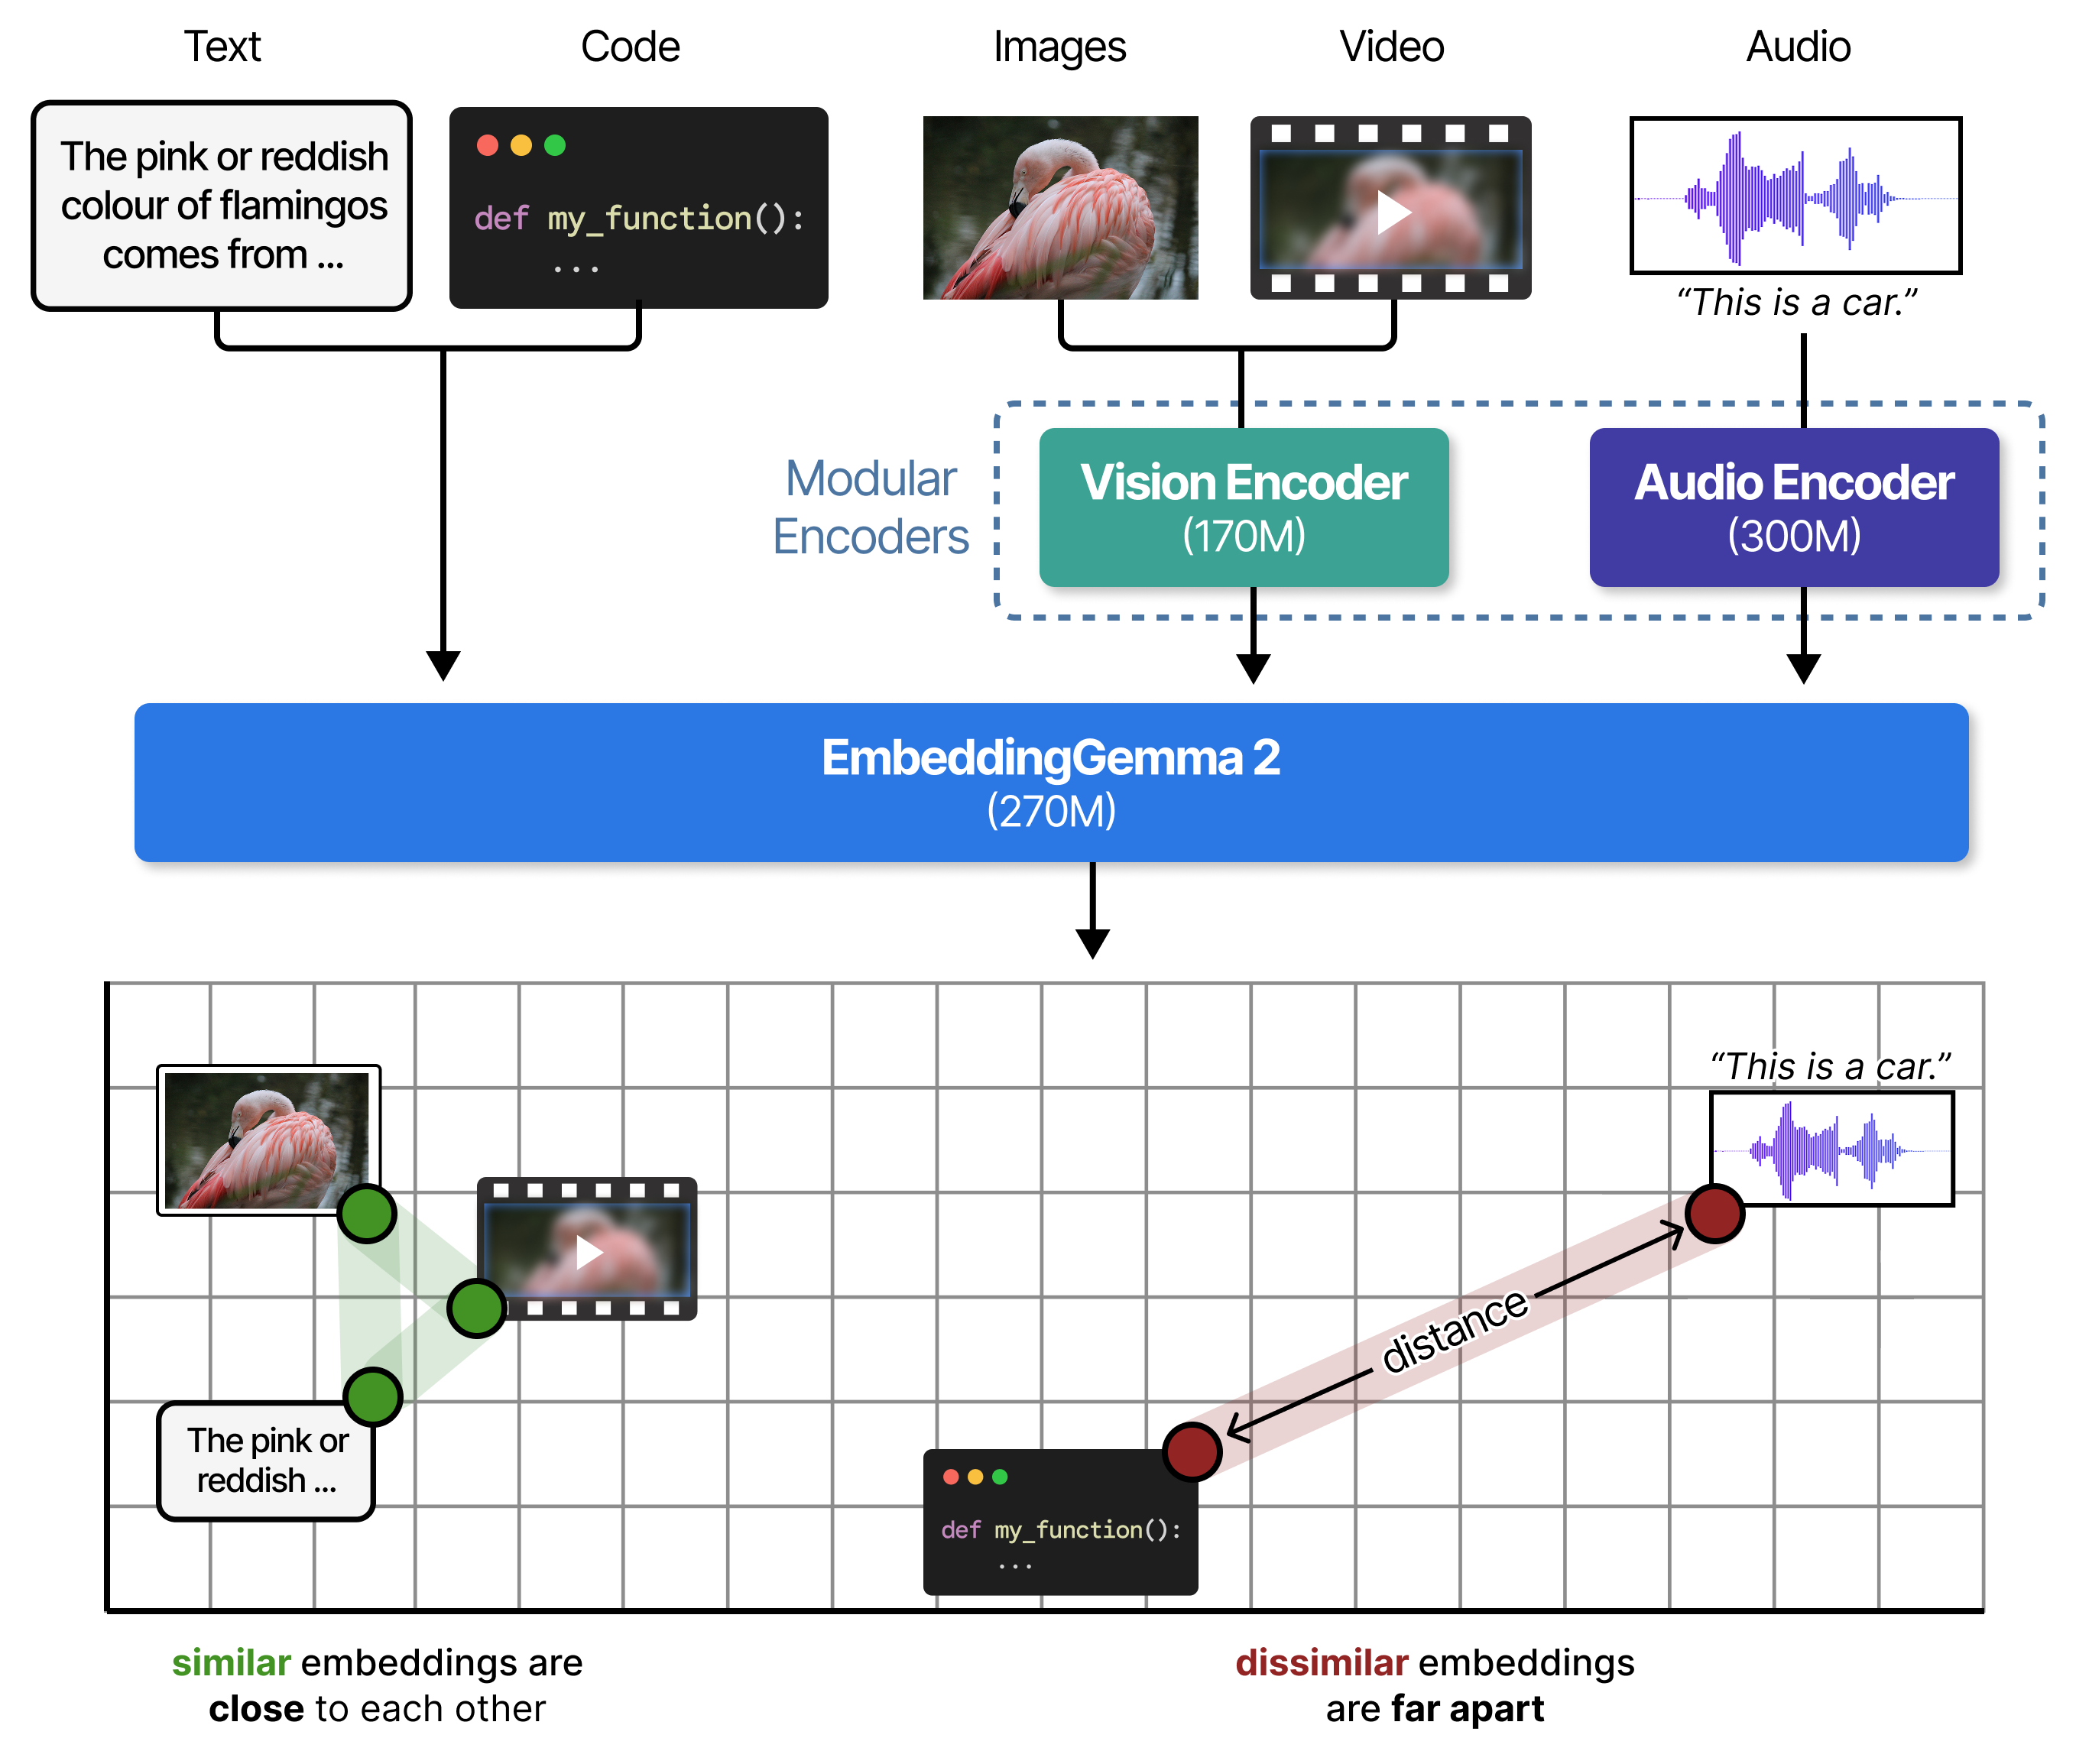
Esqueça a palavra. Pense num GPS do significado. Todo pedaço de informação — uma frase, uma foto, um trecho de áudio — vira uma lista de números que funciona como um endereço num mapa. Conteúdos com significado parecido ficam com endereços vizinhos. É por isso que uma busca semântica acha "carro" quando você digita "automóvel": as duas palavras moram quase no mesmo ponto do mapa.
Até agora, cada tipo de arquivo tinha o seu próprio mapa. Para achar coisas em fotos, você encadeava três modelos diferentes: um que descrevia a imagem em texto, outro que transcrevia o áudio, e um terceiro que transformava texto em coordenadas. Três modelos, três pipelines, três chances de perder informação no caminho — e um gasto de memória que não cabia num celular.
O EmbeddingGemma 2 elimina o encadeamento. Ele mapeia texto, código, imagens, frames de vídeo e áudio cru — e combinações deles — para um único espaço vetorial de 768 dimensões. Na prática, isso é o que o Google descreve no anúncio: dá para "achar um clipe de vídeo específico a partir de uma nota de voz" ou "buscar em horas de gravações de áudio com um pedido escrito", tudo num só modelo rodando local.
Um espaço, quatro modalidades — e uma conta de memória que encaixa
O truque do desenho modular é simples de entender e poderoso na prática. O modelo tem três partes:
- Núcleo de texto e código — 270M (130M de transformer + 140M de "embedder");
- Codificador de visão — 170M, opcional, para imagens, documentos visuais (PDFs, slides, gráficos) e frames de vídeo;
- Codificador de áudio — 300M, opcional, que engole áudio cru, fala e som.
Você carrega só o que precisa: 270M para texto, 440M para texto + imagem, 570M para texto + áudio ou 740M para tudo. E o detalhe que faz o projeto funcionar: como todas as configurações saem do mesmo checkpoint, elas compartilham o mesmo espaço vetorial. Uma consulta feita com a versão só-texto pode ser comparada diretamente com documentos indexados pela versão completa.
Os números de memória são o argumento de venda. Com quantização, num Pixel 11 Pro, o Google mediu cerca de 191 MB de RAM ativa para os pesos só-texto e cerca de 567 MB para o modelo multimodal completo. O contexto é de 8.192 tokens — quatro vezes o da versão anterior — o que cabe em 29 imagens (280 tokens cada), 58 frames de vídeo (140 cada) ou 5,5 minutos de áudio (25 tokens por segundo) numa única passada. Todos esses números estão no model card oficial.
O truque da Matryoshka: o vetor que encolhe
Nome esquisito, ideia elegante. "Matryoshka" é a boneca russa que guarda bonecas menores dentro. Aqui, o vetor de 768 números é treinado de forma que os primeiros números carreguem a informação mais importante — então você pode simplesmente cortar o final e usar 512, 256 ou 128 dimensões, sem retreinar nada. É até 6x menos armazenamento para um banco de vetores local.
O que isso custa em qualidade aparece na própria tabela do model card: no MTEB multilíngue, 61,36 (768d) → 60,41 (256d) → 57,89 (128d). No código, 78,68 → 76,18 → 71,41. No placar multimodal global (MMEB v2), 59,01 → 56,24 → 45,65. Traduzindo: o guia do desenvolvedor diz que em 256 dimensões "a maior parte da qualidade original" se mantém no texto e no código e cerca de 95% na busca por imagem, vídeo e fala. Já em 128 dimensões o multimodal desaba — o model card é explícito: 128d serve para cargas só de texto.
Os números — e o que eles não dizem
O ganho mais forte é no código: 9,92 pontos a mais no MTEB Code v1 (de 68,76 para 78,68, cerca de 14%), o que faz sentido para indexar uma base de código inteira e deixar um agente de programação achar a função certa por significado, não por nome. No texto multilíngue, o desempenho praticamente não mudou (61,36 contra 61,15) — quem já usava a versão 1 não troca por texto melhor, troca por quatro vezes mais contexto e por multimodalidade.
| Modalidade | Benchmark | EmbeddingGemma 2 | EmbeddingGemma 1 |
|---|---|---|---|
| Texto | MTEB multilíngue v2 | 61,36 | 61,15 |
| Código | MTEB Code v1 | 78,68 | 68,76 |
| Imagem | MIEB lite | 64,64 | — |
| Imagem | MMEB v2 (Hit@1) | 57,28 | — |
| Documentos visuais | MMEB v2 VisDoc | 67,84 | — |
| Vídeo | MMEB v2 (Hit@1) | 50,67 | — |
| Som | MSEB retrieval | 69,54 | — |
| Áudio | MAEB | 49,39 | — |
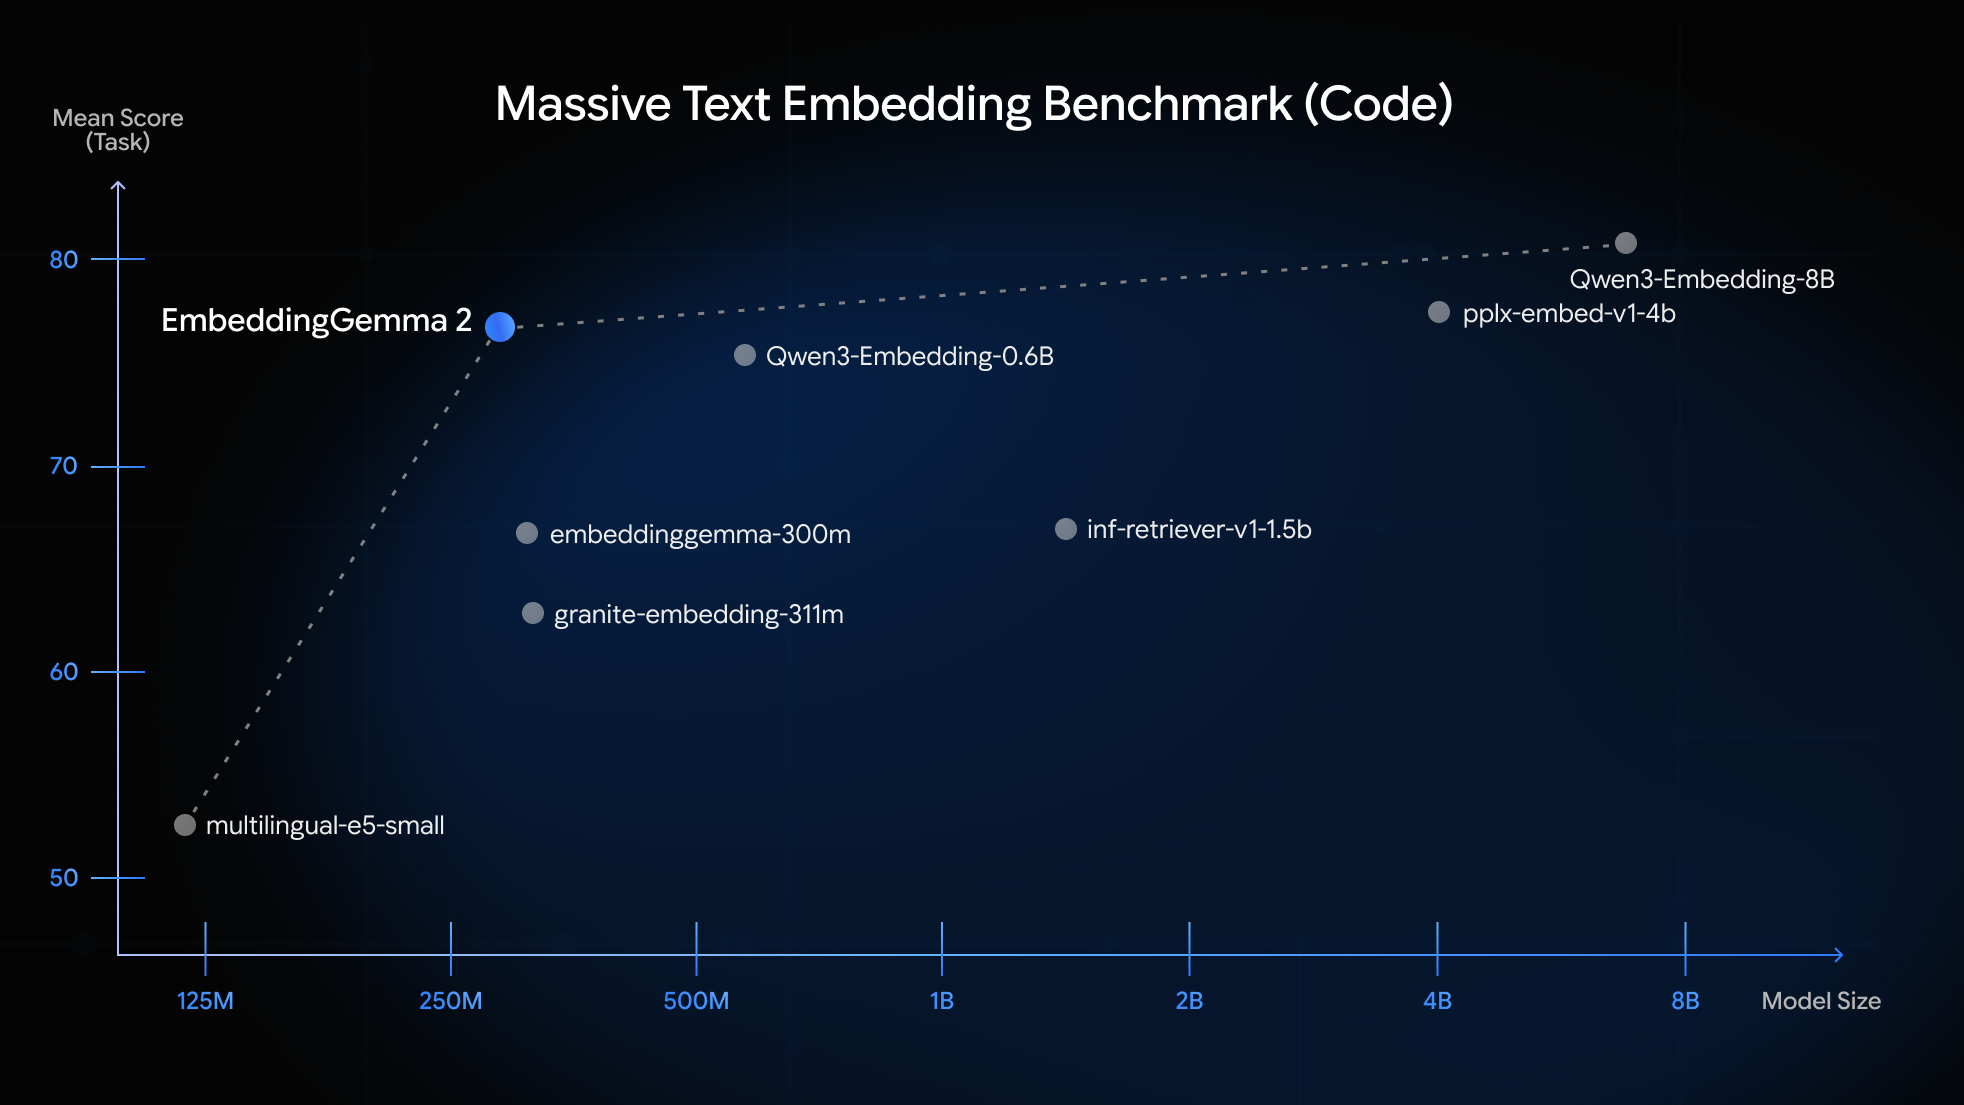
Agora a parte que muita notícia não conta. Todos esses números são do próprio Google, e comparam o EmbeddingGemma 2 basicamente com o seu antecessor. Nem o anúncio nem o model card nomeiam os modelos contra os quais mediram — a alegação é "melhores resultados entre modelos multimodais abaixo de 1 bilhão de parâmetros", não "melhor do mundo". Onde há comparação externa, ela relativiza: o Qwen3-VL-Embedding-2B reporta 73,2 no próprio MMEB v2, com cerca de 2,7x mais parâmetros — e sem áudio. Ou seja: modelos maiores continuam liderando algumas tabelas, e avaliação independente na sua tarefa continua sendo o que decide.
O "if" de milissegundos que ninguém estava vendendo
Tem um uso secundário no anúncio que vale mais do que parece. Como o modelo só produz coordenadas, dá para comparar a entrada do usuário com uma lista de rótulos de classe sem nenhum dado de treino e sem fine-tuning. Resultado: roteamento de intenção instantâneo — o pedido do usuário cai na categoria certa em questão de milissegundos. O time do Google AI Edge mediu 37,3 ms por imagem numa GPU de MacBook M5 Pro (26,9 imagens por segundo) e montou uma busca "enquanto você digita" no app AI Edge Gallery.
Por que isso importa mais no Brasil do que parece
A frase-chave do anúncio é discreta, mas é o coração do post: "gerar embeddings localmente ajuda a garantir a privacidade dos dados, reduz a latência do pipeline". Em português claro: nada sai da sua máquina.
Isso muda a conversa para quem tem acervo sensível. Uma clínica que precisa achar um exame por descrição, um escritório de advocacia com milhares de PDFs digitalizados, uma contabilidade com notas fiscais e áudios de cliente — hoje, mandar isso para a nuvem de terceiros levanta uma discussão de LGPD que trava o projeto antes de começar. Um modelo de 191 MB a 567 MB que roda offline permite indexar tudo localmente e nunca transferir o conteúdo. E, como o modelo entende mais de 100 idiomas, uma busca em português encontra um documento em inglês no mesmo espaço — o que é exatamente o problema de quem guarda material técnico internacional.
Como começar hoje
O modelo é Apache 2.0 — licença permissiva, uso comercial liberado — com pesos no Hugging Face e no Kaggle. O suporte no dia do lançamento é amplo: Ollama (tags de 270m, 378 MB, até 740m, 1,3 GB), GGUF para llama.cpp, MLX, vLLM, SGLang, sentence-transformers, transformers.js/WebGPU no navegador e MediaPipe/LiteRT no dispositivo. Para guardar os vetores, o Google aponta o Qdrant; para ver funcionando sem instalar nada, existe a AI Edge Gallery.
O contexto que dá peso ao lançamento: a primeira geração, só de texto, lançada no ano anterior, passou de 20 milhões de downloads. Ou seja, não é um experimento de laboratório — é uma base instalada que acabou de ganhar olhos, ouvidos e vídeo.
O que fica
A busca que a gente usa hoje foi construída para o mundo do texto. Nosso acervo real, porém, é som, imagem e vídeo — e é justamente aí que a busca tradicional falha em silêncio: o arquivo existe, está no disco, e é como se não existisse.
Um modelo de 740 MB com licença comercial, que cabe num celular e não manda seus dados para fora, muda o custo dessa arrumação de um projeto de infraestrutura para um item de tarde de trabalho. A pergunta que fica para o leitor brasileiro não é técnica: quantas decisões boas você já perdeu porque a informação estava salva, mas era impossível de achar?
Fontes
- Google — EmbeddingGemma 2: an open, lightweight multimodal embedding model (06/10/2026)
- Google — EmbeddingGemma 2 model card (06/10/2026)
- Google for Developers — EmbeddingGemma 2: The Developer Guide (06/10/2026)
- Google AI Edge — Bring multimodal semantic search to the edge with EmbeddingGemma 2 (06/10/2026)
- Hugging Face — google/embeddinggemma-2 (pesos, Apache 2.0)
- Ollama — biblioteca embeddinggemma-2 (tags 270m a 740m)
- Hugging Face — Qwen3-VL-Embedding-2B (comparação de porte, MMEB v2 73,2)
- Google for Developers — Introducing EmbeddingGemma (versão 1, base de 20 milhões de downloads)