
No dia 5 de outubro, uma empresa americana chamada Reflection AI apresentou o seu primeiro modelo aberto. O nome é Beam. Ele tem 501 bilhões de parâmetros no total — mas acorda só 23 bilhões deles para cada palavra que escreve. O resto fica dormindo, guardado, esperando a vez.
A proposta é ambiciosa: ser o modelo aberto do Ocidente capaz de brigar de igual para igual com os melhores modelos abertos chineses, gastando muito menos computador na hora de responder. A empresa, com sede no Brooklyn, em Nova York, foi fundada em 2024 por dois ex-pesquisadores do Google DeepMind e tem a Nvidia entre os seus apoiadores. Em abril, o CEO confirmou uma rodada que avaliou a companhia em 25 bilhões de dólares.
Só que, quando você olha os números que a própria Reflection publicou, aparece um detalhe incômodo: nas tarefas que mais importam para quem usa IA no trabalho, o Beam fica atrás de modelos chineses que já estão no ar — e que, em alguns casos, nem aparecem no gráfico principal do anúncio.
O que é o Beam, sem jargão
Beam é um modelo de texto, do tipo Mixture of Experts (mistura de especialistas). A analogia mais simples é a de um hospital: são 501 médicos no prédio, mas cada consulta chama apenas 23 deles. O hospital inteiro custa caro para manter de pé, mas cada atendimento individual é barato porque pouca gente trabalha de verdade por vez.
Na prática: o modelo ocupa muito espaço em disco, mas é relativamente leve para rodar. Ele chega com 1 milhão de tokens de contexto (dá para colocar um livro grande ou uma base de código inteira numa única conversa) e é especializado em programação, raciocínio e agentes — programas que executam tarefas sozinhos.
Um detalhe importante: os pesos ainda não estão disponíveis. A Reflection promete soltar tudo — pesos, relatório técnico, card do modelo — sob a licença Apache 2.0 ainda neste mês. Hoje só existe uma lista de espera, e o modelo está passando por testes finais de segurança.
O treino: quatro semanas e 10.500 GPUs
O número mais impressionante do anúncio não é o tamanho do modelo, é o tamanho da conta de luz. A Reflection diz que pré-treinou o Beam em menos de quatro semanas num cluster de 6.144 GPUs NVIDIA GB300 NVL72, depois de engolir 23,8 trilhões de tokens de texto.
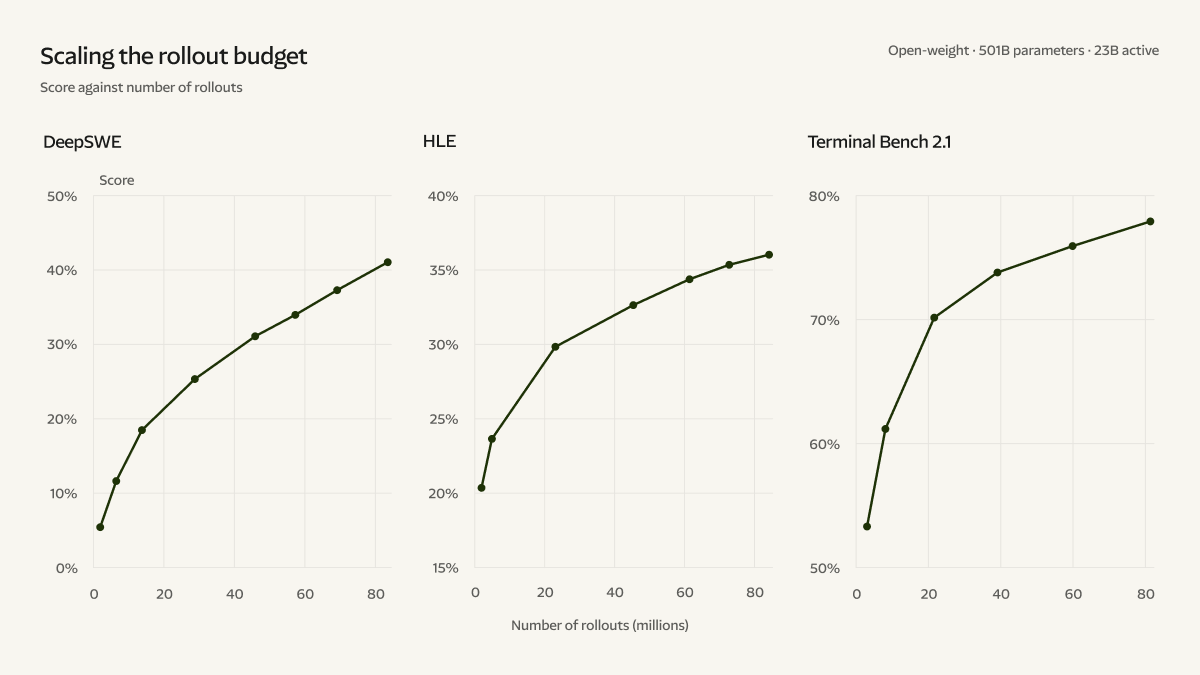
Depois veio a fase de aprendizado por reforço, aquela em que o modelo é treinado com tentativa e erro. Foram mais de 100 milhões de tentativas em 10.500 GPUs GB300, ao longo de quatro semanas, passando por cerca de um milhão de ambientes diferentes e 1,3 bilhão de caixas de areia (ambientes isolados, onde o modelo pode errar sem quebrar nada). A empresa afirma que a capacidade continuou subindo do começo ao fim, sem achatamento.
Isso importa por um motivo simples: até agora, a vantagem chinesa em modelos abertos vinha da capacidade de treinar mais barato. Um laboratório americano com dinheiro de sobra de Vale do Silício anunciando eficiência como diferencial é uma mudança de discurso — e vale checar se o discurso se sustenta nos números.
A conta que não fecha
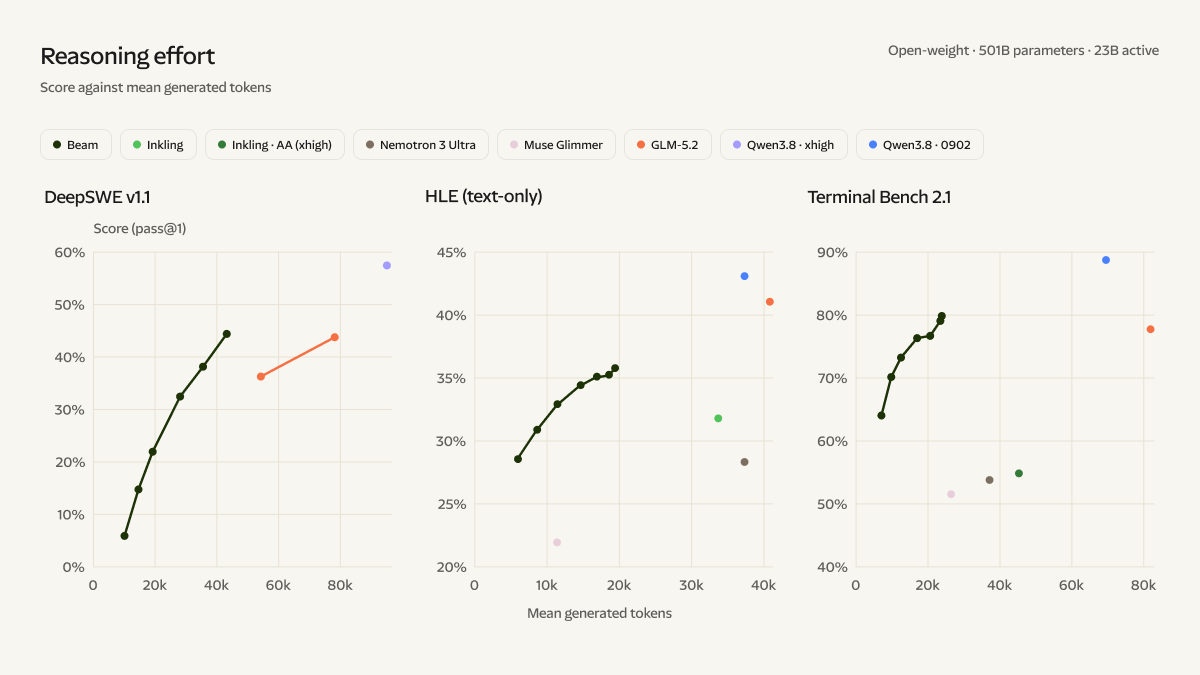
Vamos ao que interessa. A Reflection diz que o Beam é "competitivo com modelos abertos maiores como o GLM 5.2" e "se aproxima do Qwen 3.8-Max" em tarefas de código e agentes. A tabela abaixo reúne os números do próprio anúncio, colocando o Beam lado a lado com os rivais:
| Teste | Beam | GLM 5.2 | Qwen 3.8 Max | Kimi K3 | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 80,1 | 81,0 | 86,6 | 88,3 | 90,6 |
| DeepSWE v1.1 | 44,4 | 44,0 | 51,0 | 68,0 | 74,2 |
| Humanity's Last Exam (sem ferramentas) | 36,2 | 40,5 | 43,6 | 46,9 | 39,1 |
| AIME 2026 (matemática) | 97,8 | 99,2 | — | — | — |
| SWE-Bench Verified | 80,9 | — | — | — | — |
O "—" significa que o número não foi divulgado. E aí está o ponto: como observou o daily.dev, o DeepSeek V4.1 Flash e o Kimi K3 simplesmente não aparecem no gráfico principal do anúncio — apesar de liderarem justamente as duas provas que a Reflection escolheu para se apresentar como referência.
No Terminal Bench, onde o modelo aberto americano marca 80,1, o DeepSeek V4.1 Flash marca 90,6 e o Kimi K3, 88,3. No DeepSWE, a distância é maior ainda: 44,4 contra 74,2. Ou seja, "competitivo com o GLM 5.2" é verdade — mas o GLM 5.2 não é mais o teto da categoria aberta desde setembro.
A eficiência: o argumento e o furo dele
O principal cartão de visitas do Beam não é a nota, é o preço da nota. A Reflection afirma que ele alcança desempenho parecido com o do GLM 5.2 usando de 3 a 4 vezes menos computação de inferência.
Esse número merece uma ressalva técnica, e ela é relevante. A conta se baseia nos FLOPs estimados de uma passada adiante (duas vezes os parâmetros ativos, vezes os tokens gerados). Ficam de fora o pré-processamento da pergunta, os mecanismos de atenção e todo o custo de servir o modelo. É uma estimativa, não uma medição.
Tem uma ironia aí. Se o argumento é eficiência, o DeepSeek V4 Pro — o modelo contra o qual a própria empresa se compara — é mais esparso: ele acorda 49 bilhões de 1,6 trilhão de parâmetros, uma taxa de 3,1% contra os 4,6% do Beam. O Beam é um modelo esparso menos esparso que o rival chinês, vendido como o mais eficiente da praça.
E o furo maior: o Beam não tem preço publicado. O DeepSeek V4 Pro aparece no catálogo por 0,66 dólar por milhão de tokens de entrada e 1,98 dólar por milhão de saída. O Beam, hoje, só existe numa lista de espera.
O teste que o próprio anúncio errou
Nas demonstrações, a Reflection publicou um teste de generalização para mostrar que o Beam resolve coisas que não estavam no treino. O texto do anúncio diz que o modelo foi desafiado a montar o mapa de terra e água do planeta numa grade de 16.200 pontos — o "enigma viral" que circulou nas redes — e justifica a escolha assim: "esse quebra-cabeça tem poucos dias de vida, então não poderia estar nos dados de treino".
O argumento ruiu no primeiro comentário. Um leitor apontou no Hacker News que esse mesmo desafio existe desde agosto de 2025, quando foi publicado no LessWrong — mais de um ano antes do treino. A conversa seguinte foi ainda mais dura: se o modelo tinha acesso a busca na web durante o teste, o resultado não diz nada sobre generalização.
Isso não desqualifica o Beam. Mas mostra que, num lançamento de modelo, até a premissa de um teste de generalização precisa ser lida com desconfiança.
Como saber se um modelo existe de verdade
Beam é um caso perfeito para treinar o olho. Ao ler o anúncio de qualquer modelo novo, vale fazer quatro perguntas:
- Dá para baixar os pesos? Não "vai dar", "dá". Sem pesos, não existe modelo aberto — existe promessa.
- Existe card do modelo e relatório técnico? É onde ficam os detalhes que o marketing não mostra: dados de treino, limitações, testes que falharam.
- Qual é o preço? Modelo sem preço publicado não pode ser colocado numa planilha — e é na planilha que a decisão de uma empresa acontece.
- Alguém independente mediu? Nota publicada pelo próprio fabricante é ponto de partida, nunca ponto final.
O Beam, hoje, responde "não" às três primeiras. A promessa é que, até o fim de outubro, mude para "sim" — com pesos em Apache 2.0, versões em FP8 e NVFP4 e a pilha completa para rodar, avaliar e ajustar o modelo.
Por que isso importa no Brasil
Modelos abertos não são assunto de entusiasta. Para uma empresa brasileira, a diferença entre um modelo de API fechada e um modelo que você roda na sua própria máquina é a diferença entre mandar os dados dos seus clientes para fora e mantê-los dentro de casa — algo bem mais confortável diante da LGPD.
Por isso o argumento de eficiência do Beam seria relevante se comprovasse: menos computação por resposta significa menos GPU alugada e um custo por token que finalmente caberia no orçamento de uma média empresa. Mas a conta ainda não é pública, e o modelo que lidera essa corrida hoje é o mesmo que já roda em produção: o DeepSeek V4.1 Flash, com 200 tokens por segundo e um preço por milhão de tokens que a concorrência ainda não igualou.
A leitura honesta do anúncio é esta: a Reflection entrou no jogo aberto com um time de peso, uma conta de treino de fazer inveja e um discurso novo — eficiência, não tamanho. Só que o placar do primeiro tempo é dos chineses, e o Beam ainda está no vestiário esperando a liberação para entrar em campo. Quando os pesos saírem, em algumas semanas, aí sim haverá o que medir.
Fontes
- Reflection AI — Introducing Beam: Reflection's 501B open-weight model (05/10/2026)
- Hacker News — Beam: Reflection's 501B open-weight model, 344 pontos e 102 comentários (05/10/2026)
- daily.dev — Reflection launches Beam, an open model with 501B parameters (05/10/2026)
- OrcaRouter — Reflection Beam vs DeepSeek V4 Pro: sparsity, price, context (06/10/2026)
- Unite.AI — Reflection AI Unveils Beam, a 501B-Parameter Open-Weight Model (05/10/2026)
- ai0.news — AI News digest: Reflection's Beam lands with questions attached (06/10/2026)
- Wikipedia — Reflection AI (empresa, fundadores e histórico)
- Reflection AI — News (rodadas, data centers e parcerias)