
O que apareceu no Hacker News
No domingo (8), um repositório chamado llama-modchip chegou à primeira página do Hacker News com uma etiqueta difícil de ignorar: "284B DeepSeek em 64 GB de RAM, sem GPU". O post fez 432 pontos e 193 comentários. O repositório, criado em 29 de outubro, está com 641 estrelas e 35 forks — números que eu puxei da API do GitHub, não do texto de divulgação.
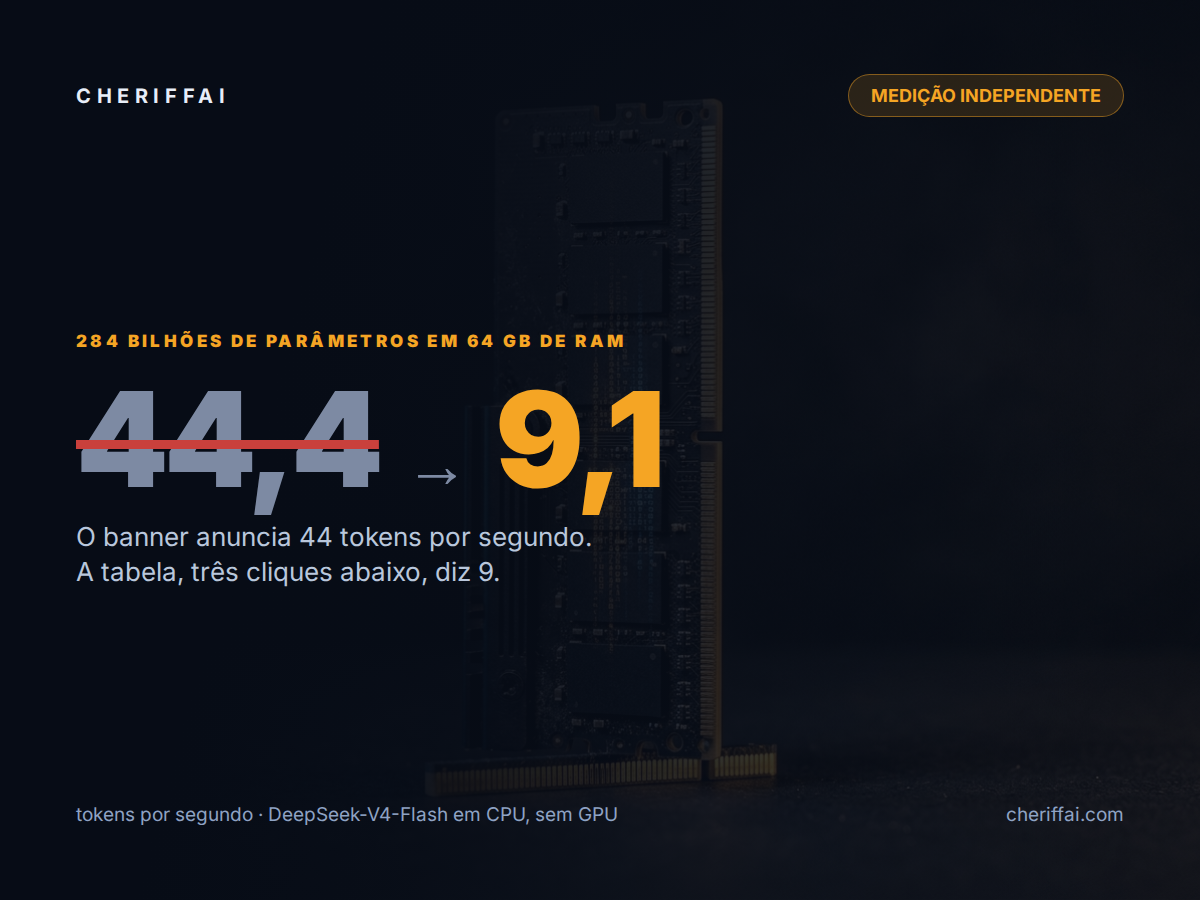
A pergunta que interessa não é se dá. Dá: o arquivo do modelo publicado no Hugging Face tem 60.772.069.110 bytes, ou 56,6 GiB, e o binário pré-compilado roda. A pergunta é a que velocidade — porque o banner fala em 44 tokens por segundo e a resposta honesta é 9.
Este post é sobre essa diferença. Não é sobre desmascarar um projeto: é sobre separar, num anúncio técnico, o que foi medido, o que foi medido em condição especial e o que é só uma frase de efeito.
44 tokens por segundo é ler, não é escrever
Modelos de linguagem têm duas velocidades, e quase todo anúncio mistura as duas.
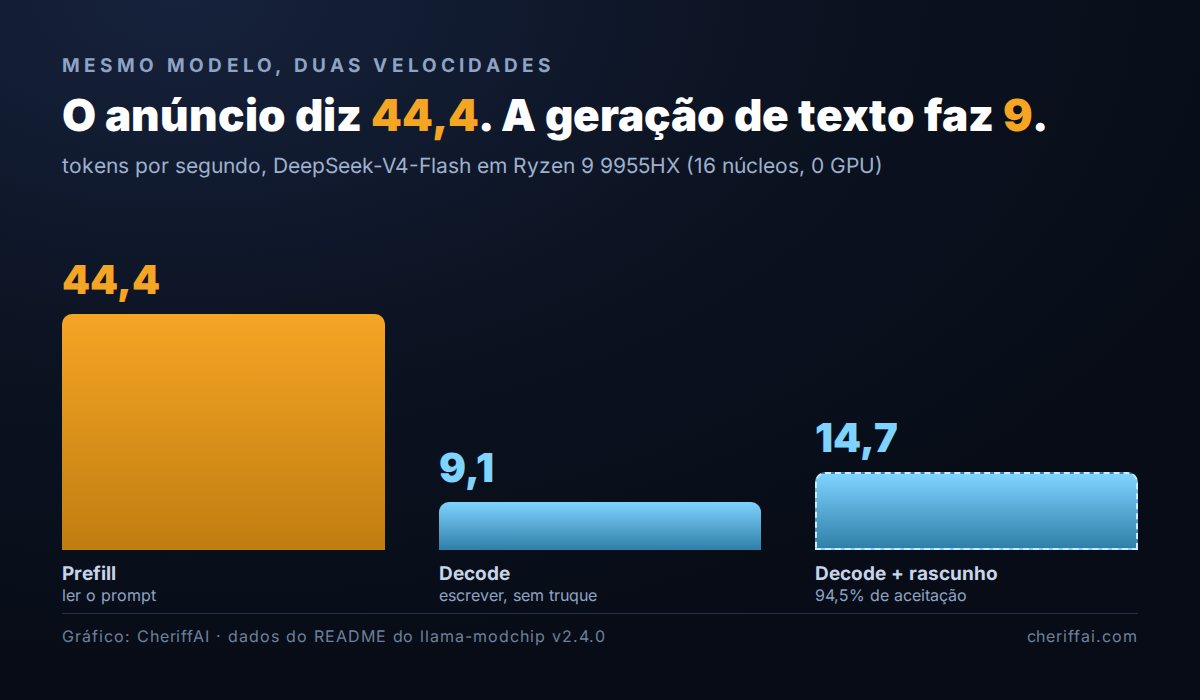
- Prefill — a máquina lê o seu prompt e monta o estado interno. É processamento em lote, paralelo, rápido. No llama-modchip: 44,36 tokens/s num Ryzen 9 9955HX de 16 núcleos.
- Decode — a máquina escreve, um token por vez, cada um dependendo do anterior. É aqui que o usuário sente o tempo. No llama-modchip: 9,06 a 9,95 tokens/s na configuração que o autor chama de "lossless".
Os 44,4 do título são prefill. A própria tabela do README mostra os dois separados: "44,4 tok/s pp · 9,1–14,7 tok/s tg" — pp de prompt processing, tg de text generation. O limite superior de 14,7 só aparece com decodificação especulativa ligada: um rascunhador de 1,64 MB (que o autor chama de Stockfish-PVS) aposta os próximos tokens e o modelo grande só confere. A taxa de acerto declarada é 94,5%. Sem esse truque, 9.
Nove tokens por segundo dá mais ou menos 450 palavras por minuto — acima da velocidade média de leitura adulta. Ou seja: é lento para um chat com muita interação, mas perfeitamente utilizável para gerar um arquivo, rodar um agente em lote ou revisar código de madrugada. A diferença entre "inútil" e "útil" aqui não é técnica, é de expectativa.
Como 284 bilhões de parâmetros cabem em 56,6 GiB
O DeepSeek-V4-Flash é um modelo Mixture-of-Experts: tem 284,33 bilhões de parâmetros no total, mas só 13,17 bilhões são acionados por token. A maior parte do peso é um arquivo morto consultado raramente — e é justamente essa gordura que permite comprimir tanto.
O truque do llama-modchip não é mágica de compressão nova: é onde cada parte é comprimida. Os 256 experts roteados (a maior parte dos parâmetros) vão para IQ1_S, cerca de 1,56 bit por peso. Atenção, embeddings e os experts compartilhados ficam em Q4_K, Q5_K e F32. A média ponderada dá 1,71 bit por peso — e a conta fecha: 284,33 bilhões × 1,71 bit ÷ 8 ÷ 2³⁰ = 56,6 GiB.
Conferi o lado que dá para conferir: somando os três shards do GGUF publicado, dá exatamente 60,77 GB, os 56,6 GiB anunciados. O lado que não dá para conferir é a comparação que o README usa para se vender: que a build padrão do Unsloth ocuparia 76,87 GiB. A API do Hugging Face devolveu 401 para leitura anônima desse repositório — a auditoria independente publicada hoje também esbarrou nisso. A economia de 20,3 GiB é plausível pela aritmética, mas é número do fornecedor, não medido por terceiro.
A conta que ninguém faz: 2,8 GB por token
Aqui está o que eu acho mais útil neste lançamento, e que não está no banner. Em inferência em CPU, o gargalo é largura de banda de memória, não capacidade de cálculo. Cada token gerado precisa ler da RAM todos os pesos ativos.
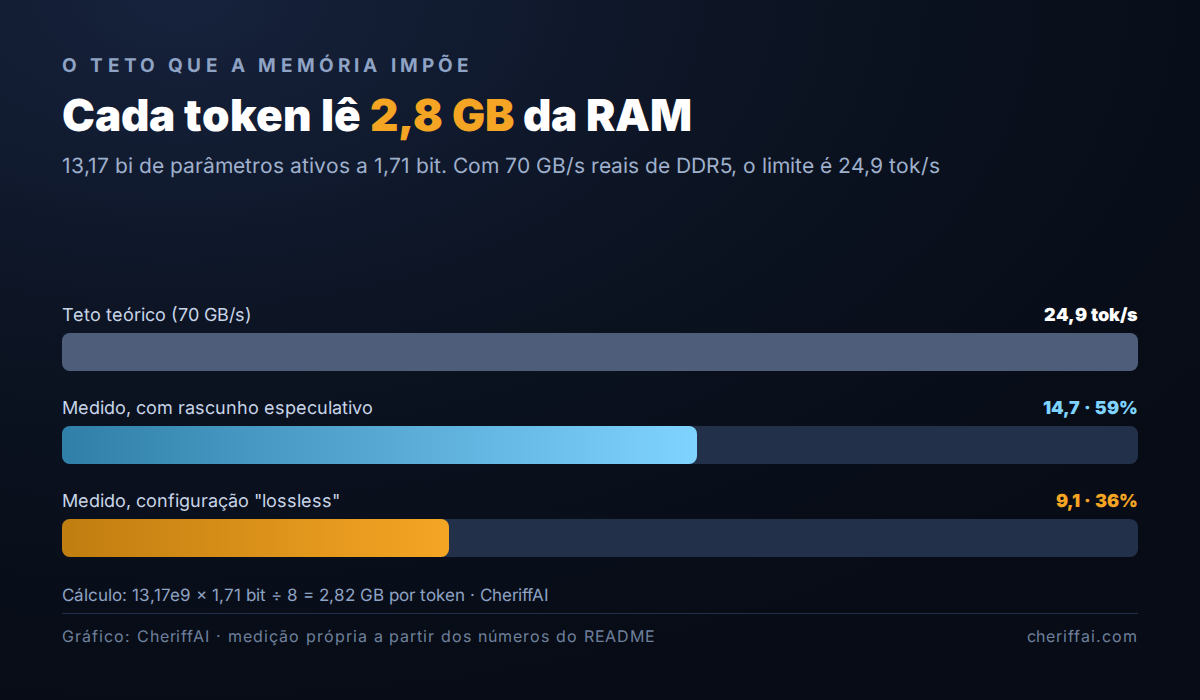
Faça a conta comigo: 13,17 bilhões de parâmetros ativos, a 1,71 bit, dão 2,82 GB lidos por token. Um DDR5-5600 em dois canais entrega 89,6 GB/s teóricos — na prática, uns 70 GB/s. Teto teórico: 24,9 tokens/s. O medido é 9,06. Ou seja, o projeto está usando 36% do limite físico da máquina; com o rascunhador especulativo, 59%.
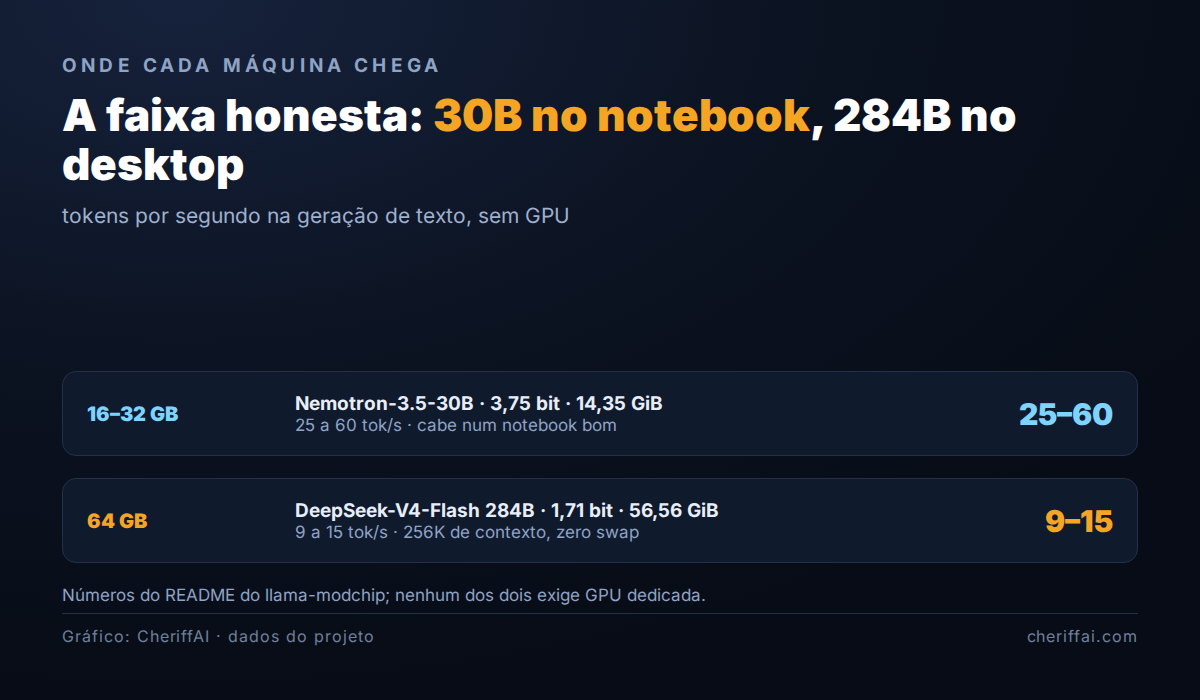
Isso também explica por que o mesmo repositório anuncia 60,4 tokens/s no Nemotron-30B em CPU. Ali são 3,0 bilhões de ativos a 3,75 bit, ou 1,41 GB por token, teto de ~50 tokens/s — e o número medido passa do teto porque a decodificação especulativa gera mais de um token por passada de memória. É o mesmo truque, e é legítimo. Só não é o que o título sugere.
Uma explicação que circulou hoje diz que cada token "ainda precisa varrer 57 GB de pesos". Não precisa: só os experts ativos são lidos. Se fosse 57 GB por token, a 70 GB/s, o modelo faria 1,2 token por segundo — e não faz 9. A conta certa é 2,8 GB.
"Sem perda" é uma frase que precisa de contexto
O README chama a configuração padrão de "lossless", e tecnicamente está correto dentro do que ele mede: comparando com o mesmo checkpoint de 1,71 bit rodando no llama.cpp sem os patches, a similaridade de logits é 1,00000. É bit-exato.
Mas "sem perda" em relação a um arquivo que já perdeu, digamos, 90% da informação original não é a mesma promessa que "sem perda em relação ao DeepSeek-V4-Flash de verdade". O checkpoint é a fonte da comparação, não o modelo original em BF16. A compressão de 1,56 bit nos experts é o corte — e ela vem antes.
O mesmo vale para a nota de qualidade: o repositório publica um teste próprio de 100 pontos em que o modelo marca 100/100. Só que o baseline também marca 100/100, como a auditoria de hoje apontou. Uma prova em que todo mundo tira nota máxima não separa ninguém — serve como sanidade, não como evidência.
O que sobrevive à auditoria
Depois de separar anúncio de medição, o saldo é bom — e isso vale registrar, porque o ceticismo fácil também erra:
- O modelo cabe mesmo: 56,6 GiB medidos no arquivo, e o pico de memória declarado é 57,61 GiB com 256K de contexto, sem swap.
- O binário existe e roda. São 15,8 MB no release v2.4.0 (4 de novembro), e ele recusa os GGUF customizados se você tentar abrir no Ollama ou LM Studio — o tipo de tensor 40 é proprietário do patch.
- Os patches são código de verdade: 18 arquivos e 5.814 linhas adicionadas no patch do DeepSeek, incluindo reescrita do rascunhador de n-gramas.
- O modelo-base existe e é aberto: DeepSeek-V4-Flash-0731, licença MIT, 2,7 milhões de downloads.
Ou seja: não é vapor. É um projeto de autor solo (Paolo Colombo), Apache 2.0, com números reais — e um banner que escolheu o número mais bonito.
O que isso muda para quem programa no Brasil
O ponto prático não é rodar 284B no seu desktop. É que a linha de "o que cabe numa máquina comum" se moveu de novo. Um kit de 64 GB de DDR5 custa uma fração de uma GPU de 80 GB, e o repositório argumenta justamente que isso elimina a necessidade de um servidor multi-GPU — um número que ele mesmo estima em mais de US$ 30 mil. Para quem tem dados que não podem sair da empresa, ou para quem paga em dólar cada chamada de API, isso é uma alternativa concreta.
Mas a alternativa honesta tem faixa: o Nemotron-30B roda em 16 a 32 GB a 25 tokens/s e é o caso de uso realista hoje — cabe num notebook bom, responde rápido, qualidade testada. O 284B em 64 GB é para trabalho em lote e agente rodando sozinho, onde 9 tokens/s não incomoda ninguém porque não tem gente esperando na tela.
A lição que eu tiro é a de sempre: leia a tabela, não o banner. Anúncio técnico quase nunca mente no número — mente na legenda do número. Prefill vira "velocidade do modelo", pico especulativo vira "velocidade", e o que o usuário sente fica três cliques abaixo, na configuração "lossless".
Se você tem 64 GB de RAM e um fim de semana, o download é real e o binário abre. Só entre sabendo que vai ver 9, não 44.
Fontes
- GitHub — synchopate/llama-modchip (README v2.4.0, tabelas de benchmark)
- GitHub — release v2.4.0 com binários e patches (04/11/2026)
- Hugging Face — DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF (arquivo medido: 60.772.069.110 bytes)
- Hugging Face — NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64-CPU-GGUF
- Hugging Face — DeepSeek-V4-Flash-0731 (modelo-base, licença MIT)
- Hacker News — "Llama-modchip: 284B DeepSeek on 64GB RAM, no GPU" (08/11/2026)
- DEV Community — auditoria independente das alegações do README (09/11/2026)