
Um trilhão de parâmetros que chegam por download
Na quinta-feira, 29 de outubro, a francesa Mistral liberou os pesos do Mistral Large 4 — apelidado de Le Chonk, "o gordo" em francês. É o maior modelo aberto já publicado por um laboratório ocidental: 1 trilhão de parâmetros, entrada multimodal (texto e imagem), 1 milhão de tokens de contexto e 160 idiomas.
Só tem um detalhe que o anúncio deixa no rodapé: o download não é pequeno. A gente somou os arquivos do repositório oficial e deu 1.061 GB — 54 arquivos de 20 GB cada, contados hoje (30/10) direto na página do modelo no Hugging Face. Existe uma versão comprimida em NVFP4, de 610 GB, feita para GPUs Blackwell. Ainda assim, é o tipo de "aberto" que não cabe no seu notebook — e esse é o fio do post.
O que a Mistral construiu de fato
O cartão do modelo e o arquivo params.json — que é a configuração crua dos pesos, não o material de marketing — descrevem uma arquitetura de mistura de especialistas (MoE) com 128 especialistas roteados e 4 ativos por token, mais 1 especialista compartilhado. São 49 bilhões de parâmetros ativos por token (52 bilhões se você contar embeddings e a camada de saída), em 72 camadas, com vocabulário de 204.800 tokens.
A janela de contexto declarada é de 1.048.576 tokens — 1M, como o anúncio diz. Atenção esparsa com índice de top-2048, cache de KV em FP8, um codificador de visão de 1,6 bilhão de parâmetros no estilo Pixtral e uma cabeça de decodificação especulativa (DSpark) embutida no checkpoint para acelerar a geração. Tudo treinado do zero em 3.800 GPUs NVIDIA Grace Blackwell, nos data centers da própria Mistral na Europa, segundo o anúncio oficial.
É engenharia séria, e o detalhe de fabricação importa: o modelo não é um ajuste fino de um aberto chinês, é linhagem europeia do começo ao fim — o argumento que a Mistral chama de "IA soberana".
O que a Mistral mediu
Os números do anúncio, todos auto-reportados pela Mistral (nenhum foi verificado por terceiros até hoje):
| Teste | Resultado | O que mede |
|---|---|---|
| FrontierCode 2.0 (Cognition, privado) | 19,7% | Se um mantenedor de repositório aceitaria o patch do agente |
| Terminal-Bench 4.0 | 41% | Trabalho de agente no terminal (+13 pontos sobre a prévia) |
| AA Coding Agent Index | 48% | Empatado com o GLM-5.3, usando 47% menos tokens por tarefa |
| AA Cyber Index | 51% | Achar, reproduzir e corrigir vulnerabilidade sem quebrar o resto |
| BrowseComp | 84,5% | Navegação web com informação difícil de achar |
| B3 Agent Security | 97,1% | Ataques a agente resistidos (era 93,3% na prévia) |
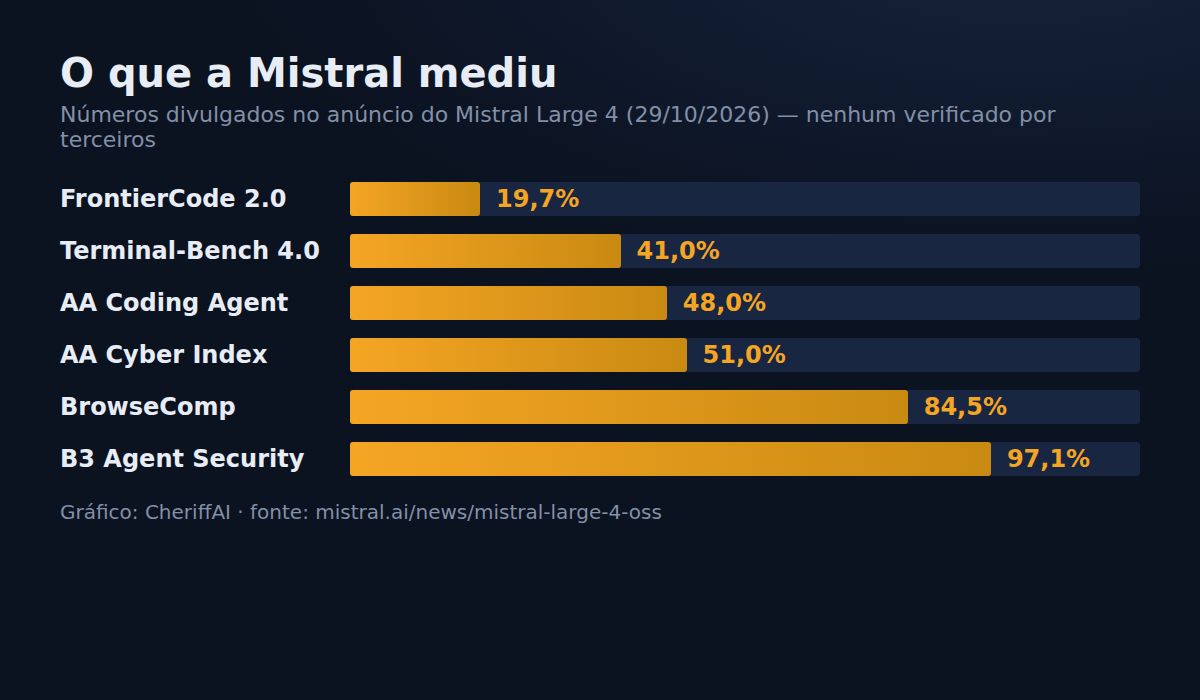
O ponto mais honesto do material é o que a Mistral chama de eficiência: no índice de agentes de código do Artificial Analysis ela empata com o melhor aberto chinês gastando 47% menos tokens por tarefa. Em custo por tarefa, empatar gastando metade é ganhar — porque token é a conta que chega no fim do mês.
A linha que a própria Mistral escreveu no model card
Aqui o post fica interessante, porque o contraponto não vem de fora: está no cartão do modelo, em inglês, sem holofote. No Artificial Analysis Intelligence Index v5, o Le Chonk marca 26 — e a Mistral descreve esse número como "o mais alto entre os modelos abertos ocidentais".
A frase seguinte, no mesmo parágrafo, é a que o release não repete: "os principais modelos abertos da China pontuam mais neste índice agregado".
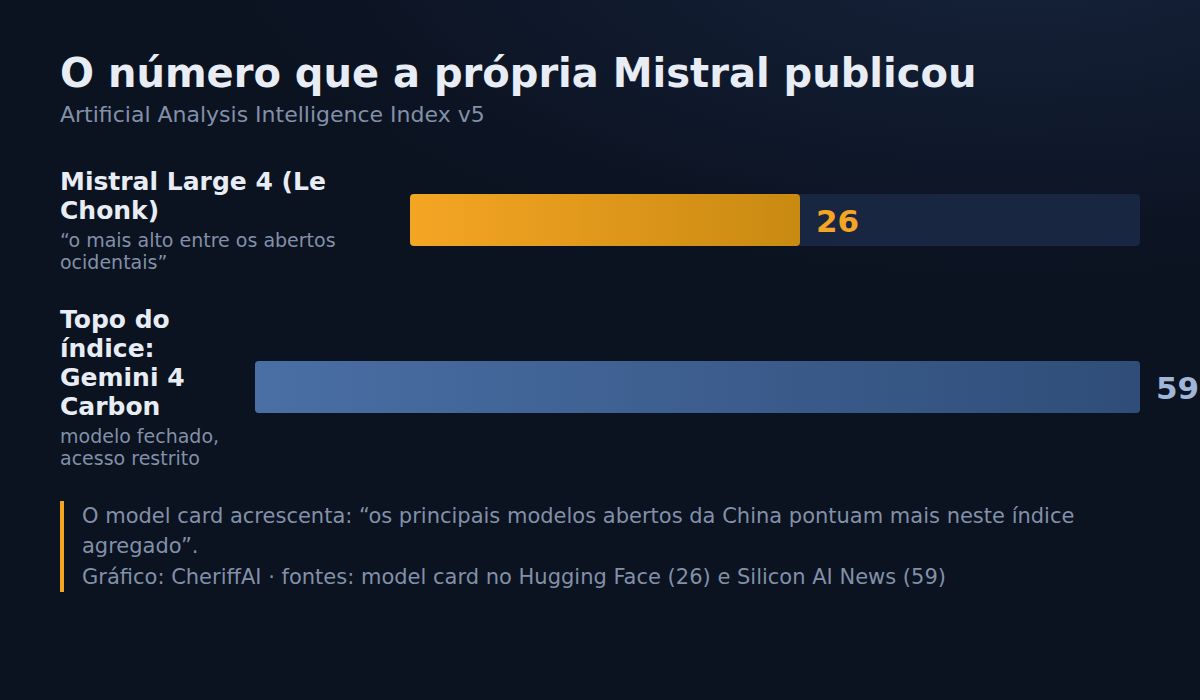
Ou seja: o melhor aberto do Ocidente fica em 26 num índice cujo topo marca 59 — e o topo é um modelo fechado, com acesso restrito a defensores cibernéticos aprovados pelo Google. Não é fracasso da Mistral; é o retrato de 2026. A fronteira fechada segue na frente, os abertos chineses vêm logo atrás, e os abertos ocidentais correm numa pista própria, mais lenta e mais auditável. Ler leaderboard sem esse contexto é escolher fornecedor por slide de conferência.
"Aberto" com uma cláusula
O nome da licença é pomposo — Mistral Ecosystem Open-Weight License — mas o texto é curto e vale ler inteiro (são 2,6 mil caracteres no arquivo LICENSE). É a licença MIT com uma condição a mais:
"Se o Licenciado ou qualquer de suas afiliadas opera um negócio de Modelo como Serviço, o Licenciado deve celebrar uma licença comercial separada com a Mistral antes de usar o Modelo ou seus derivados para qualquer fim comercial."
O texto define "Modelo como Serviço" como dar a um terceiro acesso ao modelo para inferência ou pós-treino "de forma que esse terceiro possa exercer controle significativo sobre as entradas, parâmetros ou dados de treino". E abre três exceções: uso interno não paga nada, produto final com a capacidade embutida em uma funcionalidade não paga nada, e revender acesso ao modelo da própria Mistral também não.
Traduzindo para o dia a dia de quem constrói: você pode baixar, rodar no seu servidor, ajustar com os seus dados e vender o produto que usa o modelo. O que você não pode é virar um provedor de inferência com ele sem negociar licença. Não há teto de receita, não há pedido de nome de usuário nem contagem de funcionários — é uma cláusula só, e ela mira exatamente o negócio de quem ganha dinheiro revendendo token.
Vale o vocabulário: isso é open weight (peso disponível), não open source (licença aprovada pela OSI). A diferença é prática: um modelo "open source" pode ser republicado e revendido; este, não. Não é pegadinha — está escrito, e a Mistral não esconde. Mas o título "pesos abertos" e a expectativa de "open source" viajam juntos na cabeça do público, e o post tem obrigação de separar as duas.
Quanto custa, de verdade, ser "aberto"
Tem dois preços, e eles não se parecem.
O primeiro é o da API: US$ 0,70 por milhão de tokens de entrada, US$ 0,07 em cache e US$ 2,10 por milhão de saída, segundo a página de modelos da Mistral. Para um modelo de 1 trilhão de parâmetros, é barato — mais barato por token que boa parte do tier premium fechado.
O segundo é o de rodar em casa: 610 GB no checkpoint NVFP4, que é a versão feita para Blackwell. Só os pesos ocupam mais do que três GPUs de 192 GB; com cache de KV para contexto longo e espaço para o índice esparso, quatro aceleradores da geração atual é o piso realista — e isso é um servidor, não um desktop. A conta não é impossível, mas é de quem já tem infraestrutura.
É por isso que o anúncio cita ABN AMRO, Belfius, Cisco, Cloudflare, ESA, Microsoft Foundry e a agência europeia ENISA testando o modelo para auditar código e analisar logs. Ninguém ali está economizando em conta de nuvem: estão comprando o direito de auditar o que roda dentro da própria rede. Soberania, no fim, é uma palavra para "eu consigo abrir o capô".
O que isso significa para quem está no Brasil
Para a maioria das empresas brasileiras, a decisão prática é chata e clara: usar via API. A US$ 0,70 por milhão de tokens de entrada, baixar 610 GB e manter quatro aceleradores ligados não fecha a conta — e o time que faria o fine-tuning custa mais que a fatura anual de inferência.
Mas há um grupo crescente para quem a resposta muda: bancos, seguradoras, saúde, setor público e qualquer operação que precise demonstrar onde o dado do cliente foi processado. A LGPD não proíbe nuvem estrangeira, mas exige saber o caminho do dado e poder provar controle. Um modelo com pesos baixáveis e auditáveis — mesmo com 1 TB de tamanho — é a diferença entre contratar um fornecedor e controlar o sistema. É a mesma lógica que fez o setor financeiro europeu abraçar o modelo em três semanas.
E fica o recado que o release não dá: em 2026, "aberto" virou sinônimo de duas coisas diferentes — peso disponível para quem tem data center, e marketing para todo mundo. Saber qual das duas está na sua mesa é o que separa uma escolha técnica de uma compra por influência de anúncio. O número de 26 no índice agregado e o de 1.061 GB no download dizem mais sobre o Le Chonk do que qualquer adjetivo do release.
Fontes
- Mistral — "Built for Coders, Trusted by Defenders": anúncio do Le Chonk com pesos abertos (29/10/2026)
- Hugging Face — model card de mistralai/Mistral-Large-4-1T-A52B, com arquitetura, benchmarks e a ressalva sobre o Intelligence Index (consultado 30/10/2026)
- Hugging Face — texto da Mistral Ecosystem Open-Weight License (MIT modificada, cláusula de Model-as-a-Service)
- Hugging Face — checkpoint quantizado NVFP4 (610 GB)
- Mistral Docs — ficha do mistral-large-4: contexto de 1M e preços por token (consultado 30/10/2026)
- Silicon AI News — "AI Models", incluindo a nota de 59 no Intelligence Index v5 para o Gemini 4 Carbon (29/10/2026)
- Artificial Analysis — modelos e índices citados (Intelligence Index v5, Coding Agent Index, Cyber Index)
- Medições próprias (30/10/2026): soma dos tamanhos dos arquivos dos dois repositórios via API do Hugging Face — 1.060,6 GB (FP8, 54 shards) e 610,1 GB (NVFP4); 1.239 downloads e 1.281 likes no repositório principal no momento da consulta.