
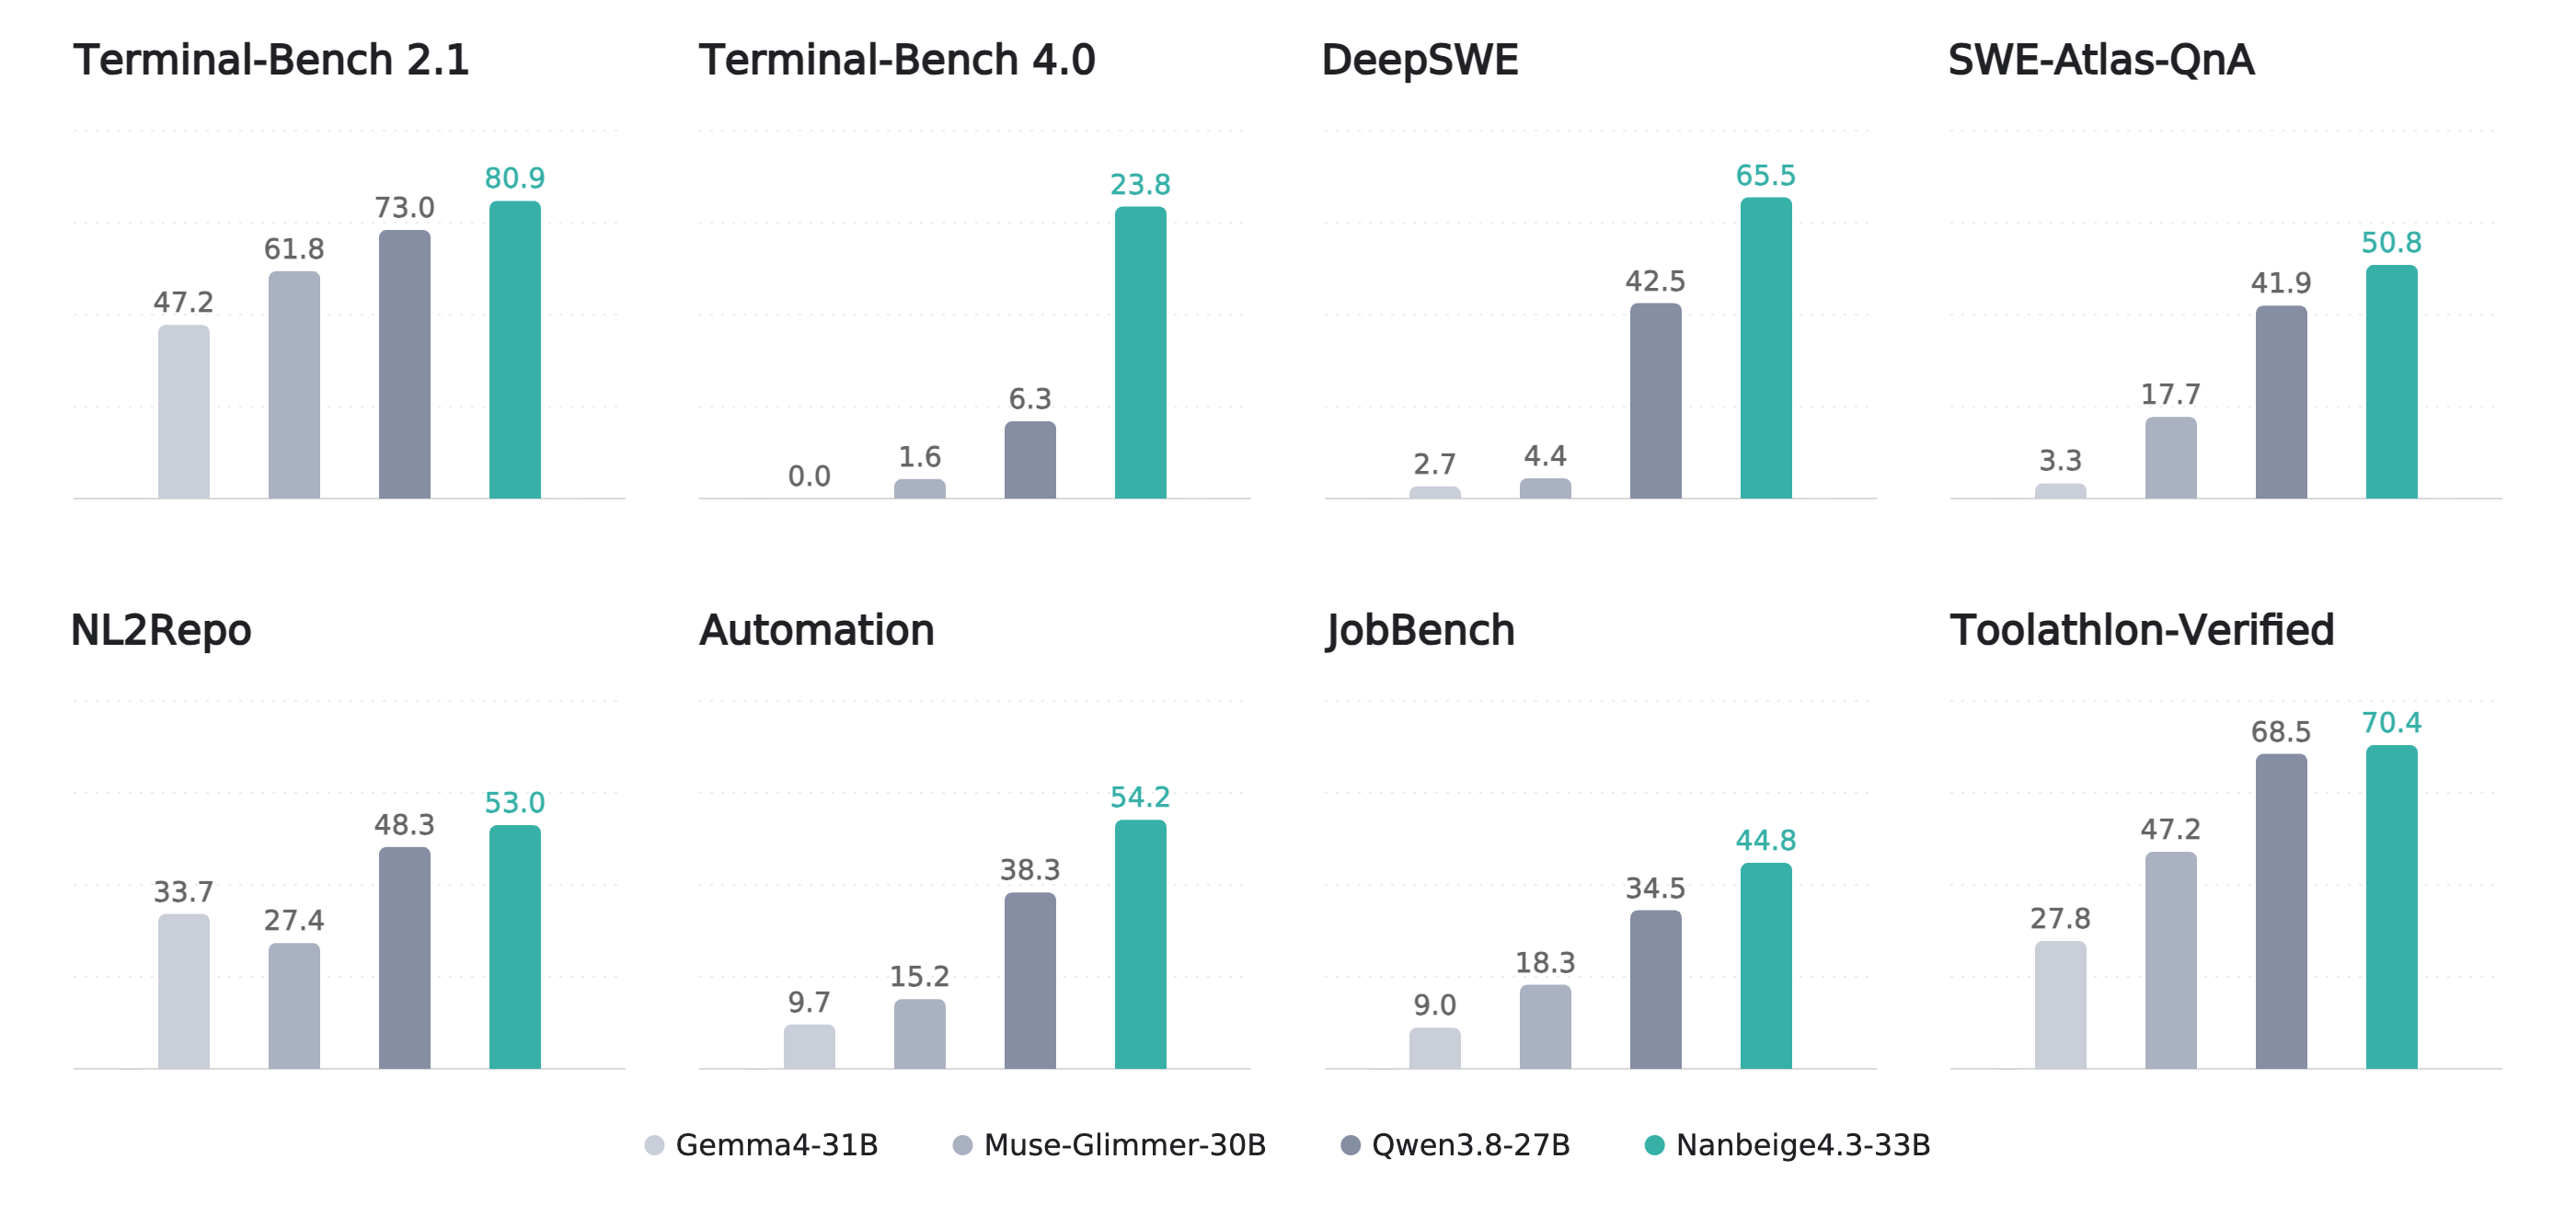
No dia 24 de outubro, às 2h49 no horário de Brasília, apareceu no Hugging Face um repositório chamado Nanbeige4.3-33B. Três minutos antes, tinha aparecido o checkpoint base dele. Não veio junto nenhum post no blog, nenhum fio no X, nenhuma nota à imprensa. A publicação inteira era um cartão de modelo — e uma tabela de 20 benchmarks em que ele ganha de praticamente todo mundo da sua faixa de tamanho.
Isso é o tipo de lançamento que a internet ama: um modelo chinês de 33 bilhões de parâmetros, licença Apache 2.0 (uso comercial livre), janela de 512 mil tokens e números que colocariam o Qwen3.8-27B atrás. A imprensa técnica repetiu a tabela em menos de 24 horas. O que quase ninguém repetiu foram os doze rodapés embaixo dela — e são eles que mudam a leitura.
Este post faz o que a gente sempre faz aqui: mostra o anúncio de um lado, a medição do outro, cada um com número e link.
O que o card realmente entrega
O que dá para conferir abrindo os arquivos é bastante coisa, e é tudo bom:
- 33,12 bilhões de parâmetros, densos (não é mixture-of-experts), arquitetura Llama: 52 camadas, 7.168 de dimensão escondida, 56 cabeças de atenção contra 8 de chave-valor.
- 66,3 GB de pesos em bf16, distribuídos em 14 arquivos safetensors.
- Contexto nativo de 524.288 tokens (512K), sem truque de extensão.
- Texto apenas, em inglês e chinês.
- Licença Apache 2.0 declarada nos metadados do repositório.
É um pacote sério. Um modelo denso de 33B com essa janela de contexto e essa licença é justamente o que falta para quem quer rodar agente de código sem mandar código de cliente para API de terceiro. Até aqui, só elogio.
"Venceu 18 de 20" — e as duas linhas em que perde
A manchete que circulou é que o Nanbeige4.3-33B bate o Qwen3.8-27B em 18 dos 20 benchmarks do próprio card. O número é exato. Só que ele convive com outro, do mesmo card: o modelo lidera 17 das 20 linhas. A diferença de um não é erro de conta — é que ele perde duas linhas para o Qwen e uma para o Gemma4-31B, e a maioria das matérias pegou só um dos dois números.
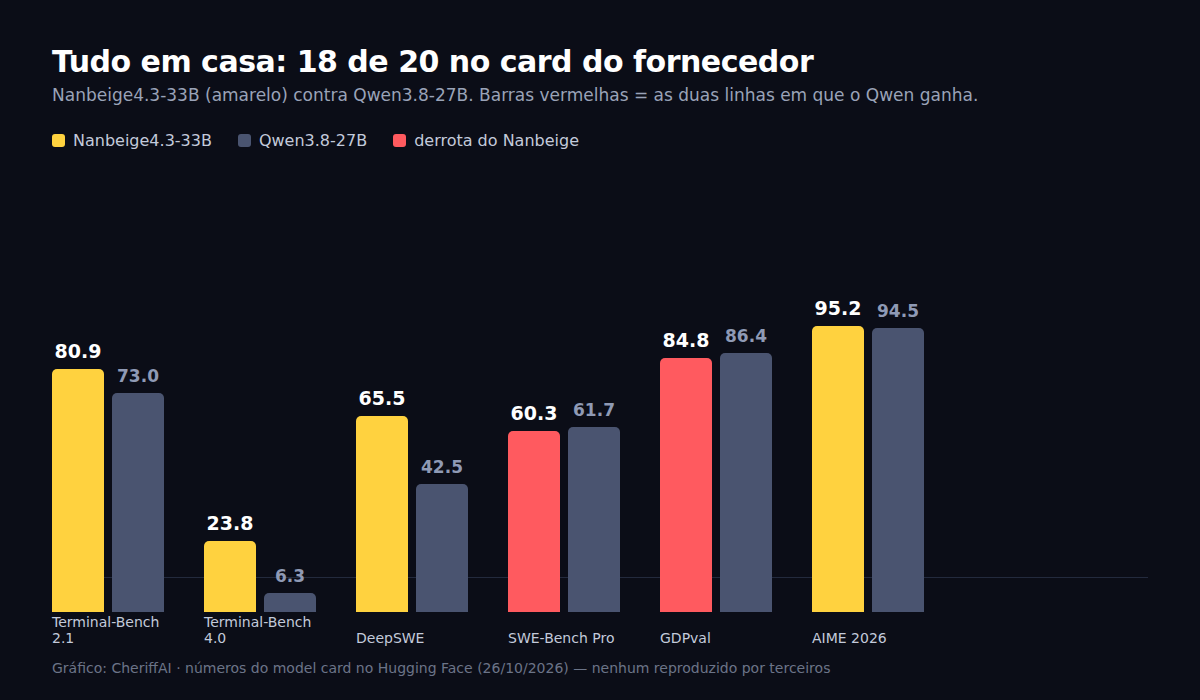
As duas derrotas ficam nas tarefas em que o "andaime" do agente menos ajuda: SWE-Bench Pro fica 60,3 contra 61,7 do Qwen, e GDPval (trabalho de escritório avaliado por rubrica) fica 84,8 contra 86,4. No raciocínio puro, o empate é quase total: AIME 2026 dá 95,2 contra 94,5, e o GPQA Diamond é ganho pelo Gemma4-31B, com 91,3 contra 89,5 dos dois.
As vitórias largas estão todas no mesmo lugar: agente de código. DeepSWE 65,5 contra 42,5. Terminal-Bench 2.1 em 80,9 contra 73,0. Terminal-Bench 4.0 em 23,8 contra 6,3. Vinte e três pontos de diferença é muito — e é exatamente o tipo de número que aparece quando o laboratório afina o próprio andaime contra o próprio modelo.
O rodapé que quase ninguém leu
Aqui está o detalhe que separa este lançamento de um resultado espetacular de um resultado promissor. O card tem uma nota de rodapé, pequena, que diz o seguinte: o Nanbeige4.3-33B foi avaliado com preserve_thinking=true.
Traduzindo: quando o modelo responde, ele pensa antes — e, nesse modo, o raciocínio dos turnos anteriores fica no histórico em vez de ser descartado. Para agente que executa 40 passos de ferramenta, isso é uma vantagem real e legítima, porque o modelo não precisa reconstruir o plano do zero a cada passo. O próprio card recomenda exatamente isso para uso com ferramentas, e exatamente o contrário para conversa comum.
O problema não é o ajuste. É que ninguém publicou o número do Nanbeige sem esse ajuste. E, como a execução usou andaimes diferentes por benchmark — Terminus 2 no Terminal-Bench 2.1, mini-swe-agent no DeepSWE, Claude Code no NL2Repo, Claude Code com busca no JobBench, e o GPT-6 Sol como juiz de 1.304 rubricas no SWE-Atlas-QnA —, a comparação é entre sistemas, não entre modelos. O levantamento do OrcaRouter sobre o repositório resume bem: há duas explicações vivas para o padrão, o modelo é muito melhor em código agêntico, ou as linhas agênticas são justamente aquelas em que quem afina o andaime contra o próprio modelo ganha mais. Nada no repositório distingue as duas.
E o ponto que fecha a questão: não existe harness de avaliação no repositório. Nenhum script, nenhuma configuração de tarefa, nenhum log. Até 26 de outubro, nenhum terceiro publicou nota, rating de arena ou entrada em índice independente para esse modelo. O 84,0 de "AA-LCR" na tabela é a Nanbeige rodando um benchmark do Artificial Analysis — não é o Artificial Analysis rodando o Nanbeige.
512K de contexto é um número no arquivo de configuração
Toda cobertura abriu com a janela de meio milhão de tokens. Quase nenhuma fez a conta — e a conta é dura. Cada token guardado no cache de atenção custa 208 KiB neste modelo. Multiplique:
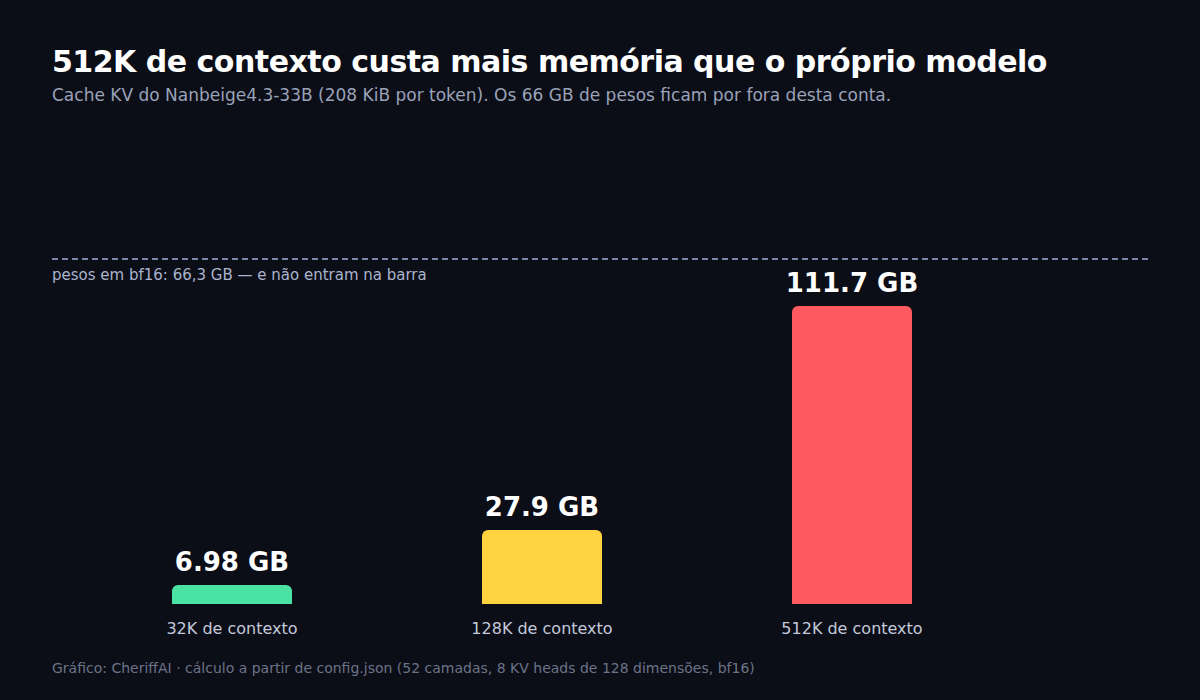
config.json do modeloA 512 mil tokens, o cache sozinho ocupa 111,7 GB — mais que os 66,3 GB de pesos, e fora de qualquer acelerador único vendido hoje. A 128 mil tokens, 27,9 GB. A 32 mil, 7 GB. Não é propaganda enganosa: a janela é nativa e num nó de quatro GPUs ela funciona — tanto que os próprios exemplos do card usam paralelismo de 4 vias. Mas "512K de contexto" como argumento de compra é um teto que você não alcança com o hardware que tem na sala.
Vale a comparação estrutural: o Qwen3.8-27B usa um empilhamento híbrido, com 48 camadas lineares de estado fixo contra 16 de atenção plena. É por isso que ele fica barato em contexto longo e o Nanbeige não — e essa diferença é de arquitetura, não de ajuste fino.
4 bits deixa de ser o mesmo modelo
Quase ninguém vai rodar 66 GB em bf16. Vai rodar quantizado, numa placa só. Segundo o levantamento do OrcaRouter sobre as conversões que apareceram em menos de um dia, este modelo é mais sensível à quantização que o normal — a concordância com o modelo em bf16 no próximo token cai de 98% (Q8, 35,2 GB) para 94,7% (Q5 com matriz de importância), 92,6% (Q4 com matriz) e 89,9% (Q4_K_M padrão do llama.cpp, 20,1 GB).
Para prosa, 90% de concordância é invisível. Para chamada de ferramenta, onde um argumento malformado encerra o turno, errar um token em dez é outro produto. Se o motivo do seu interesse é o desempenho agêntico, o mínimo honesto é Q5 com matriz de importância — o que, na prática, pede uma placa de 40 ou 48 GB.
O único teste de verdade até agora
Uma pessoa publicou o que aconteceu rodando os pesos. Um desenvolvedor japonês carregou o checkpoint completo em bf16 num Colab com A100 de 80 GB, em Transformers puro, e viu cerca de 63 GB de VRAM em uso; a primeira resposta, limitada a 1.024 tokens, levou uns 11 segundos.
Depois, três perguntas. Acertou a pegadinha do 9,11 contra 9,8, com explicação decimal correta. Sobre personagens de anime, nomes saíram embaralhados. Sobre o primeiro-ministro do Japão, errou a resposta, alegou corte de conhecimento em junho de 2024 e inventou um nome. E o raciocínio em inglês vazou antes da tag de fechamento.
Três perguntas casuais não são avaliação, e não devem ser lidas como tal. Mas o retrato combina com a forma da tabela: um modelo afinado com força para trabalho agêntico em inglês, dois anos desatualizado em conhecimento de mundo e sem desempenho notável numa segunda língua. O card promete inglês e chinês; teste em chinês ninguém publicou.
Por que ele existe: é um professor, não um produto
O parágrafo mais importante do card não é o da tabela. É o segundo, onde a Nanbeige diz que este 33B é o "modelo professor" da família Nanbeige4.3 — construído primeiro para destilar comportamento agêntico nos modelos pequenos da linha, como o Nanbeige4.3-3B.
Lido ao pé da letra, o lançamento é um artefato de treino que por acaso é publicável. É o modelo que você usa para gerar trajetórias para um aluno de 3B. E a razão de a suíte de benchmarks ser tão pesada em tarefas longas de agente — Terminal-Bench, DeepSWE, JobBench, Toolathlon — é que são exatamente os comportamentos que se quer transferir.
Isso explica também o orçamento de tokens: 65.536 novos tokens para trabalho com ferramentas, 262.144 para raciocínio e conversa, pensamento ligado por padrão. Professor é otimizado para produzir boas trajetórias com orçamento generoso, não para ser barato na inferência.
O que isso significa para quem constrói no Brasil
A tentação é óbvia: modelo aberto, licença permissiva, número melhor que o Qwen — migra. A conta, porém, é outra. O Qwen3.8-27B está hospedado a US$ 0,33 por milhão de tokens de entrada e US$ 2,40 de saída, com 262K de janela e leitura de imagem e vídeo. Um prompt agêntico de 65 mil tokens mais 8 mil de resposta custa cerca de 4 centavos de dólar. Um 33B auto-hospedado precisa bater esse número carregando GPU parada, risco de quantização e nenhum fallback.
Para times brasileiros que tratam dado de cliente como dado sensível — jurídico, saúde, financeiro —, a conta muda de natureza: cumprir LGPD sem mandar o dado para fora vale mais que 4 centavos. Nesse caso, o Nanbeige pode ser uma peça real de infraestrutura, desde que o piloto seja feito em Q5 ou bf16 e com avaliação própria no seu domínio, em português. E aí está o outro alerta: o modelo é declaradamente inglês e chinês, e o único teste público em outra língua saiu mal.
Como ler o próximo "venceu 18 de 20"
Uma checklist curta, que serve para qualquer lançamento de pesos abertos:
- Quem rodou? Número no card do fornecedor é anúncio, não medição.
- Com qual configuração? Aqui,
preserve_thinking=truee andaime por benchmark. Sem esse detalhe, a nota não é comparável. - Existe harness no repositório? Sem scripts e logs, ninguém reproduz — e o número fica esperando.
- Quantos downloads e quantizações? Na tarde de 26/10 o card mostrava 2.787 downloads no mês e 57 conversões quantizadas. Isso é adoção de curiosidade, ainda não de produção.
- Qual o custo real do contexto? Faça a conta do cache antes de acreditar no "512K".
O Nanbeige4.3-33B é o tipo de lançamento que a gente gosta de acompanhar: aberto de verdade, documentado acima da média e com uma tese clara por trás — fazer um professor para ensinar modelos pequenos. O que ele ainda não tem é a única coisa que separa empolgação de decisão: alguém de fora rodando a mesma suíte e publicando o resultado. Até lá, o número é real e a verificação não existe. As duas coisas cabem na mesma frase, e é assim que se deve reportar.
Fontes
- Hugging Face — Nanbeige/Nanbeige4.3-33B, model card e tabela de benchmarks (24/10/2026)
- Hugging Face — Nanbeige4.3-33B-Base, checkpoint base publicado 3 minutos antes (24/10/2026)
- OrcaRouter — Nanbeige4.3-33B vs Qwen3.8-27B: What the Repo Shows (26/10/2026)
- Hugging Face — conversões GGUF da comunidade: tamanhos por precisão (25/10/2026)
- AI Weekly — Nanbeige Opens 33B Model Under Apache 2.0 With 512K Context (25/10/2026)
- Reddit r/MachineLearning — discussão do lançamento e da nota sobre avaliação não verificada (25/10/2026)
- OrcaRouter — Qwen3.8-27B: preço por milhão de tokens e janela de contexto (26/10/2026)