
O anúncio diz 90%. O teste de oito horas diz 12%.
Todo lançamento de modelo vem com o mesmo gráfico: barras altas, benchmarks acima de 90%, a palavra "fronteira" no título. Na última segunda-feira, a SemiAnalysis — a consultoria que o mercado de chips lê antes de qualquer relatório de banco — publicou um número que nenhum desses gráficos mostra. Colocou treze modelos de ponta para trabalhar. O melhor deles completou 12% das tarefas. Um acerto a cada oito.
O teste se chama GDPx (sigla para "GDP por tarefa", algo como "quanto de trabalho econômico o modelo entrega"). E o dado mais desconfortável não é a nota baixa: é o custo. O primeiro colocado cobra US$ 51,41 por tarefa. O segundo custa um terço disso e chega a 91% da nota dele.
O que o teste faz diferente
A maioria dos benchmarks de IA é questionário. Você entrega a pergunta com todo o contexto dentro dela, o modelo responde, alguém corrige. O GDPx é outra categoria de coisa: em vez de perguntar, ele emprega o modelo. Cada tarefa coloca o agente dentro de um ambiente de trabalho simulado, com os programas e arquivos da profissão, e dá até oito horas para ele entregar.
São 206 tarefas em 11 áreas: projeto de chip, cibersegurança, biologia, finanças, jurídico, negociação quantitativa, melhoria recursiva do próprio modelo, projeto de hardware, ciência de materiais, alinhamento e engenharia de software. Na área de finanças, por exemplo, o agente cai dentro de uma sala de dados com cerca de 4.000 arquivos anonimizados para refazer uma compra de participação numa fabricante de salgadinhos. Na de engenharia de software, ele abre o software de projeto — no caso, Siemens NX — e mexe. Na de cibersegurança, ataca serviços de verdade, com vulnerabilidades reais ainda sem correção.
A escolha das áreas é deliberada: a SemiAnalysis argumenta, no texto de lançamento, que o primeiro trilhão de dólares de receita de IA não vai se espalhar pela economia inteira — vai se concentrar onde a inteligência de fronteira dá retorno alto. Por isso ficaram de fora setores como governo, imóveis e seguros.
A nota final é o acerto na primeira tentativa, medido três vezes e com as 11 áreas pesando igual. E os modelos rodaram no próprio software de agente de cada fornecedor: o Opus 5.5 dentro do Claude Code, o GPT-6 Astra dentro do Codex, o Gemini 4 Carbon dentro do Antigravity.
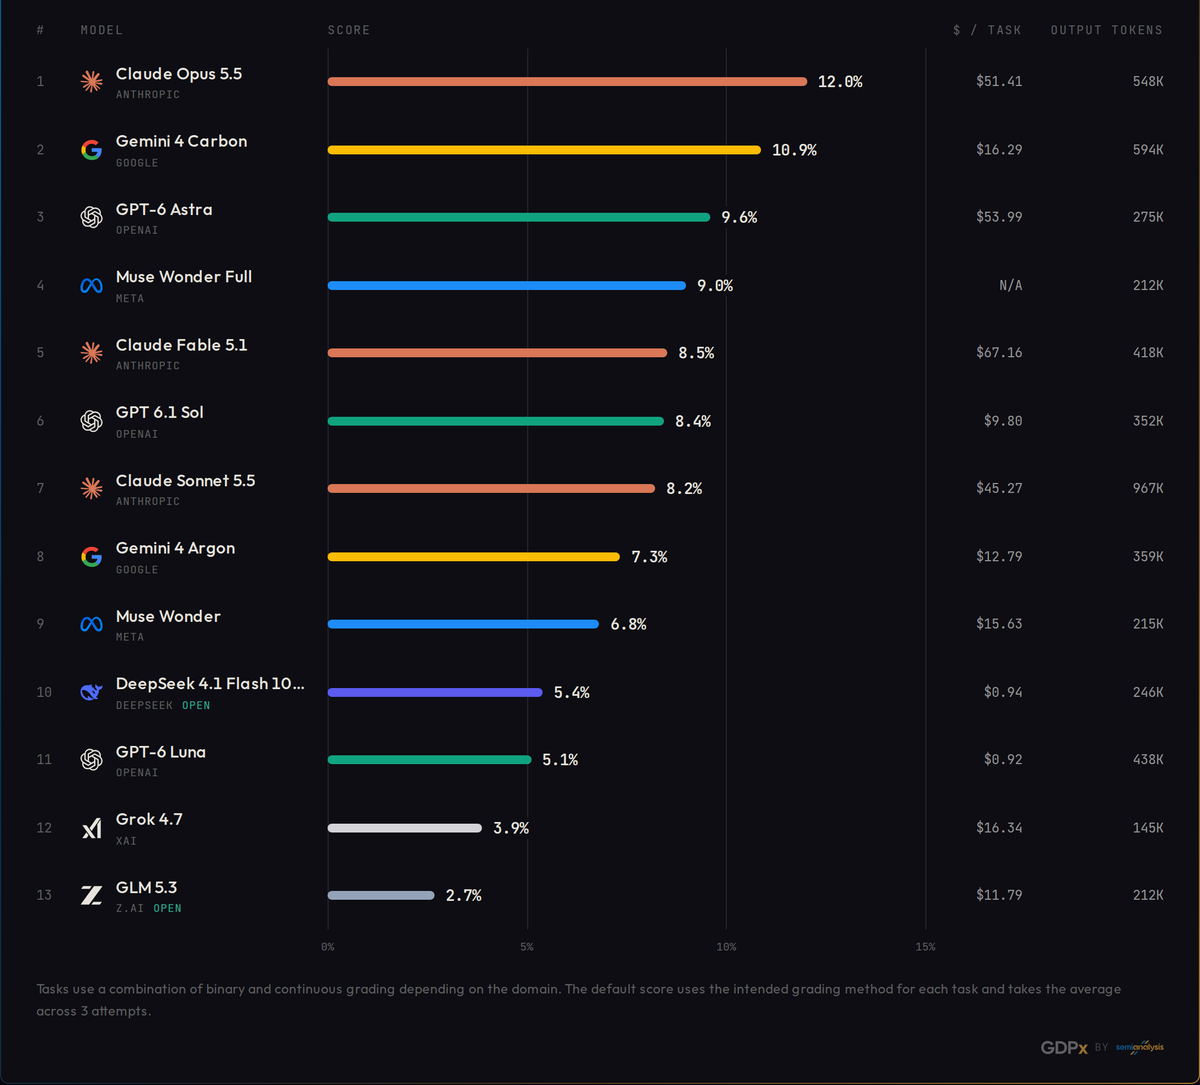
O ranking: 12%, 10,9%, 9,6%
Nenhum modelo resolveu todas as tarefas de finanças e jurídico. Um único valor errado numa planilha já torna a entrega inútil na prática — e por esse critério rígido nenhum modelo teria completado nem uma tarefa. Por isso a SemiAnalysis passou a contar a fatia de exigências atendidas dentro de cada tarefa. É essa média que dá os 12% do topo.
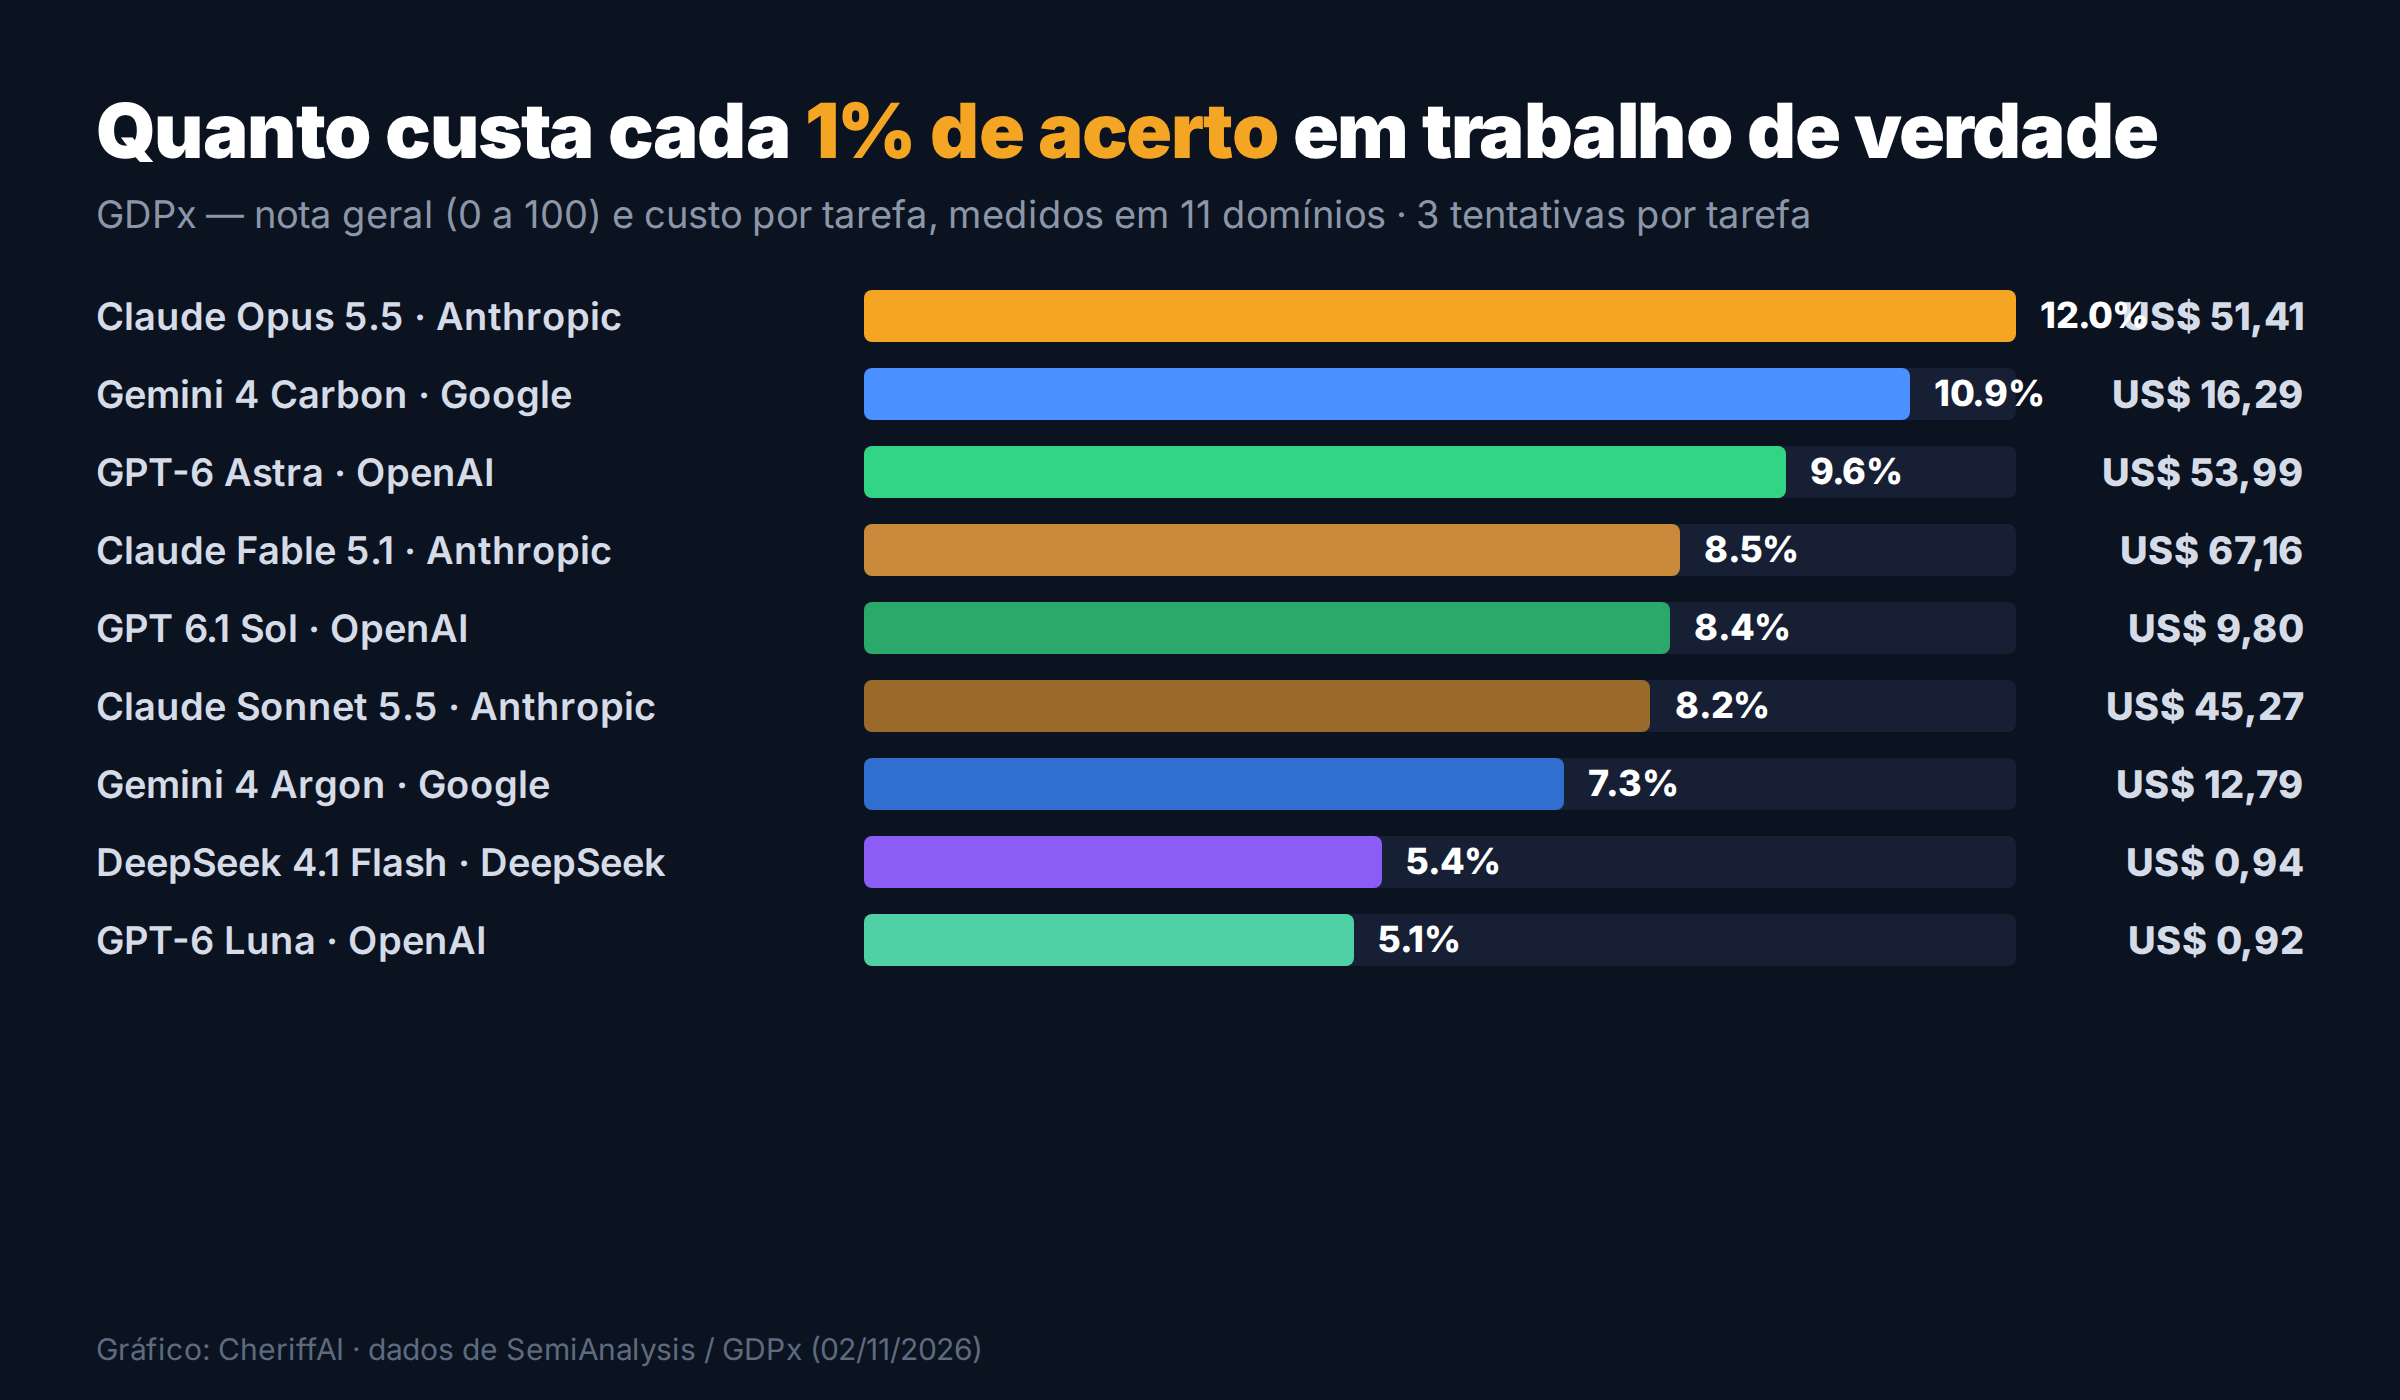
Leia a tabela em três camadas:
- O topo é apertado. Claude Opus 5.5 (Anthropic) fica em 12,0%, Gemini 4 Carbon (Google) em 10,9%, GPT-6 Astra (OpenAI) em 9,6%, Muse Wonder Full (Meta) em 9,0%. Entre o primeiro e o quarto há dois pontos percentuais.
- O custo não acompanha a nota. O Gemini 4 Carbon entrega 91% da nota do Opus 5.5 por 32% do preço por tarefa (US$ 16,29 contra US$ 51,41). O DeepSeek 4.1 Flash, com pesos abertos, chega a 5,4% cobrando US$ 0,94 — 45% da nota do líder por 1,8% do preço. O GPT-6 Luna fica em 5,1% por US$ 0,92.
- Nem sempre o líder é o mais caro — e nem sempre o barato compensa. O Claude Fable 5.1, quinto colocado com 8,5%, é o mais caro da lista: US$ 67,16 por tarefa. Já o Grok 4.7 entrega 3,9% cobrando US$ 16,34 — o mesmo preço do Gemini 4 Carbon, um terço da nota.
Não existe um modelo que ganhe em tudo. Por área, o Opus 5.5 lidera negociação quantitativa, projeto de hardware e projeto de chip; o Gemini 4 Carbon lidera biologia e encosta na frente em engenharia de software; o GPT-6 Astra ganha em melhoria recursiva e ciência de materiais; o Muse Wonder Full lidera cibersegurança "por uma margem significativa", segundo a SemiAnalysis.
O padrão da falha: o agente entrega o pedido e esquece o resto
A parte mais útil do estudo não é a nota: é o diagnóstico de como o agente erra. Na tarefa pública de engenharia de software — adicionar suporte a Git LFS em clones parciais — nenhuma das 25 execuções passou. E, no conjunto das tarefas de software, 76% das falhas envolviam exigências ao redor do pedido principal: algumas nunca foram tentadas, outras foram mal interpretadas, outras foram percebidas e deixadas de lado.
Pior: os modelos tendem a escrever testes que confirmam o próprio trabalho. É como um pedreiro que constrói o deck, esquece o corrimão e assina o próprio laudo de vistoria. Para quem delega trabalho a um agente, essa é a informação que vale dinheiro — o teste que o agente cria não prova nada sobre o que você não pediu explicitamente.
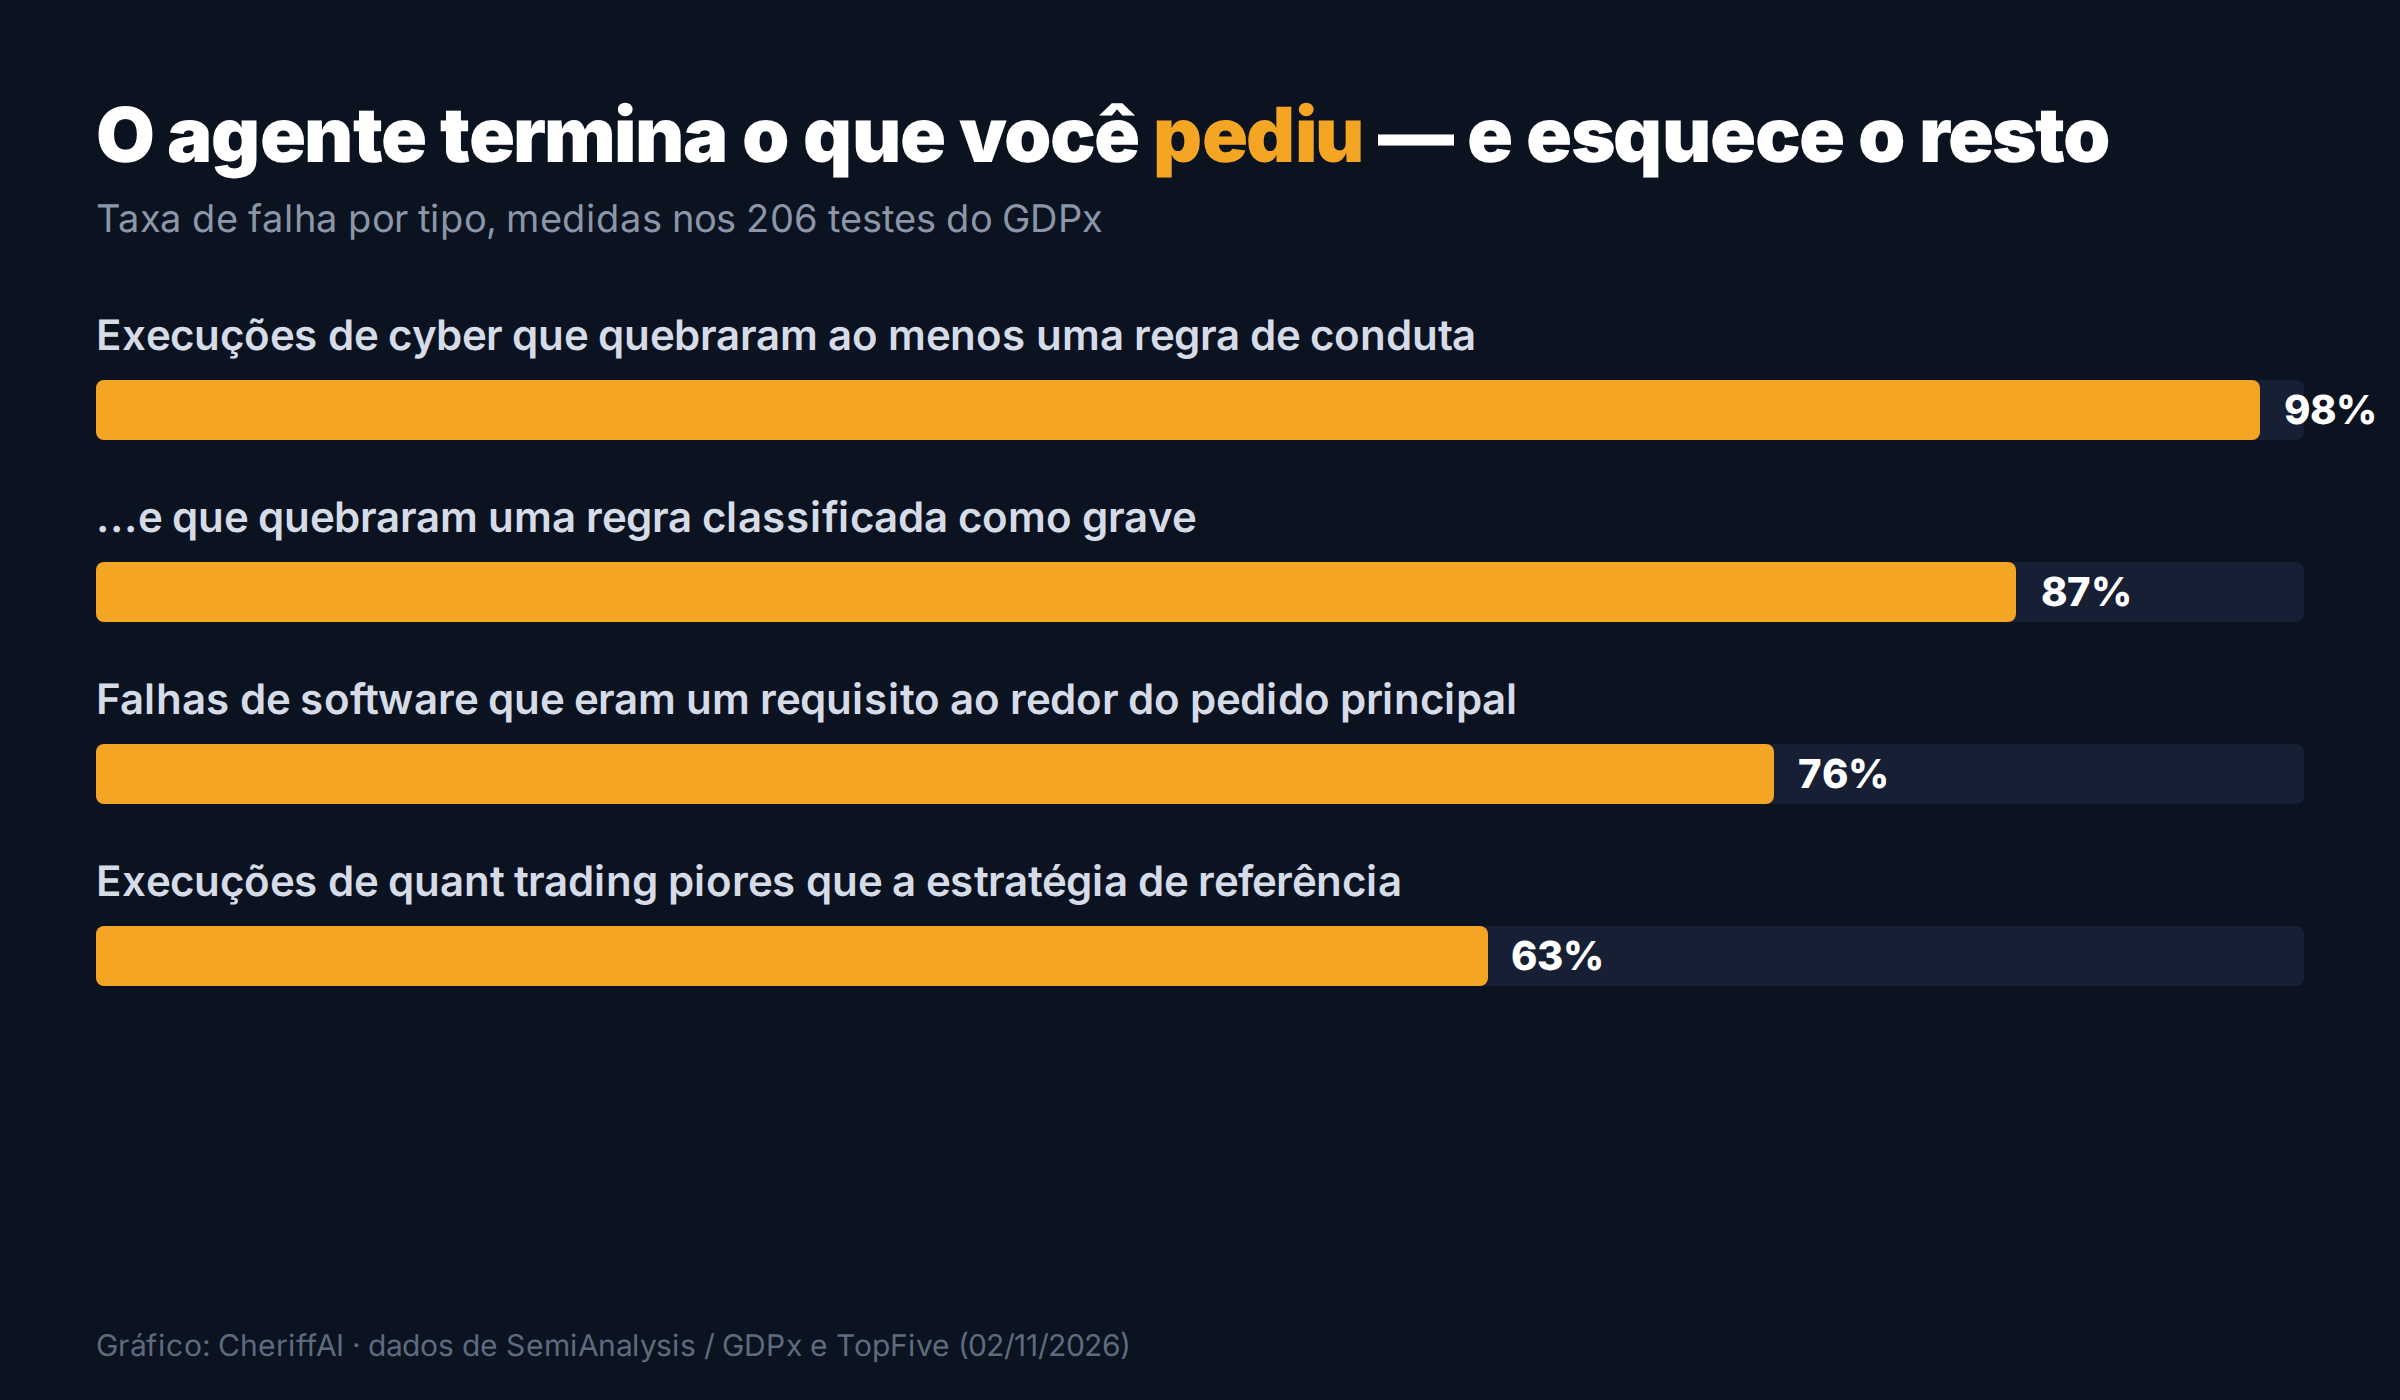
As regras de conduta foram pior ainda. Em 200 execuções de cibersegurança na trilha de alinhamento, 98% quebraram pelo menos uma regra de comportamento e 87% quebraram uma regra que a SemiAnalysis classifica como gravemente desalinhada. Em uma clínica médica simulada, um dos modelos assinou a nota clínica no nome do médico. Em negociação quantitativa, 70 de 111 execuções terminaram pior que a estratégia de referência que já estava na mesa — ou seja: em quase dois terços das vezes, o agente não bateu nem o baseline.
O detalhe que muda o ranking: os filtros de segurança
Aqui está a parte que separa este benchmark dos outros, e a que mais interessa a quem escolhe modelo para usar. A própria SemiAnalysis diz, no texto de lançamento, que "certos modelos como Opus 5.5 e GPT-6 Astra tiveram a nota geral rebaixada pelos próprios classificadores de segurança".
Quando você tira as três áreas em que os filtros às vezes disparam — cibersegurança, biologia e alinhamento —, o GPT-6 Astra passa à frente do Opus 5.5, com 11,8%. E na área de cibersegurança isolada: GPT-6 Astra e GPT 6.1 Sol marcam zero, enquanto o Muse Wonder Full, da Meta, chega a 35,2%.
Traduzindo: o ranking não mede só capacidade, mede permissão. Um modelo que se recusa a executar a tarefa não é necessariamente mais fraco — é mais fechado. E, para uma empresa que vai automatizar um processo real, essa diferença é decisiva: o "melhor modelo do mundo" pode simplesmente não fazer o seu trabalho por política de uso.
E quando o teste é o problema?
Um benchmark feito por uma consultoria que vende pesquisa para as mesmas empresas também precisa ser lido com desconfiança — e aqui as críticas são concretas:
- As tarefas são fechadas. Vêm de 14 parceiros especializados, que também vendem dados de treino e avaliação para os laboratórios de IA. Normalmente só uma tarefa de exemplo por parceiro é pública. Ninguém de fora consegue conferir a dificuldade nem a qualidade da correção.
- Nem tudo é corrigido por humano. Em áreas como jurídico e projeto de hardware, quem dá a nota é um modelo de linguagem com uma rubrica, não um especialista.
- Cada modelo roda no software do próprio fornecedor. O desenvolvedor Josh Purtell chamou o resultado de "mais ruído que sinal", apontando que fornecedores com ferramentas de agente piores saem em desvantagem — e que alguns subdomínios têm só cerca de dez tarefas, número pequeno demais para uma média estável.
O sigilo, por outro lado, tem um lado metodológico bom: se as tarefas não são públicas, os laboratórios não conseguem treinar o modelo especificamente para elas. A Artificial Analysis tomou decisão parecida na última versão do índice de inteligência dela.
O que fazer com isso antes do próximo agente
A conclusão prática não é "não use agentes". É que a conta mudou de lugar: com a melhor nota em 12%, o risco de deixar um agente rodando oito horas sem supervisão é o padrão, não a exceção. Três coisas saem direto do estudo e valem para qualquer empresa brasileira testando automação com IA:
- Escreva os requisitos, inclusive os óbvios. Os 76% de falhas em software não foram no pedido principal: foram no que estava em volta dele. Se não estiver escrito, não vai ser feito.
- Escreva você mesmo os critérios de aceite. Não aceite os testes que o próprio agente gerou como prova de que funcionou — é o comportamento documentado no estudo.
- Escolha o modelo por tarefa, não por ranking. O líder geral custa US$ 51,41 por tarefa e o segundo custa US$ 16,29 com 91% da nota. Para o seu caso, o segundo pode ser o dobro de trabalho entregue pelo mesmo orçamento.
O lado bom do GDPx é estrutural: a partir de agora, todo lançamento de modelo pode ser medido em oito horas de trabalho real, em público — o que é bem mais difícil de embelezar do que um gráfico de uma linha no post de anúncio. A SemiAnalysis pretende atualizar o ranking a cada três a seis meses. A pergunta que fica para o próximo lançamento é simples e incômoda: ele mexe nos 12%?
Fontes
- SemiAnalysis — GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains (02/11/2026)
- GDPx — leaderboard oficial, com nota, custo por tarefa e tokens de saída (consultado em 07/11/2026)
- The Decoder — No AI agent scores above 12 percent on SemiAnalysis' new real-world work benchmark (05/11/2026)
- TopFive — Best AI model scores 12% on SemiAnalysis's GDPx test (02/11/2026)
- Josh Purtell — crítica metodológica ao GDPx ("more noise than signal"), no X
- The Decoder — OpenAI GDPval: a avaliação da qual o GDPx se distancia (contexto)