
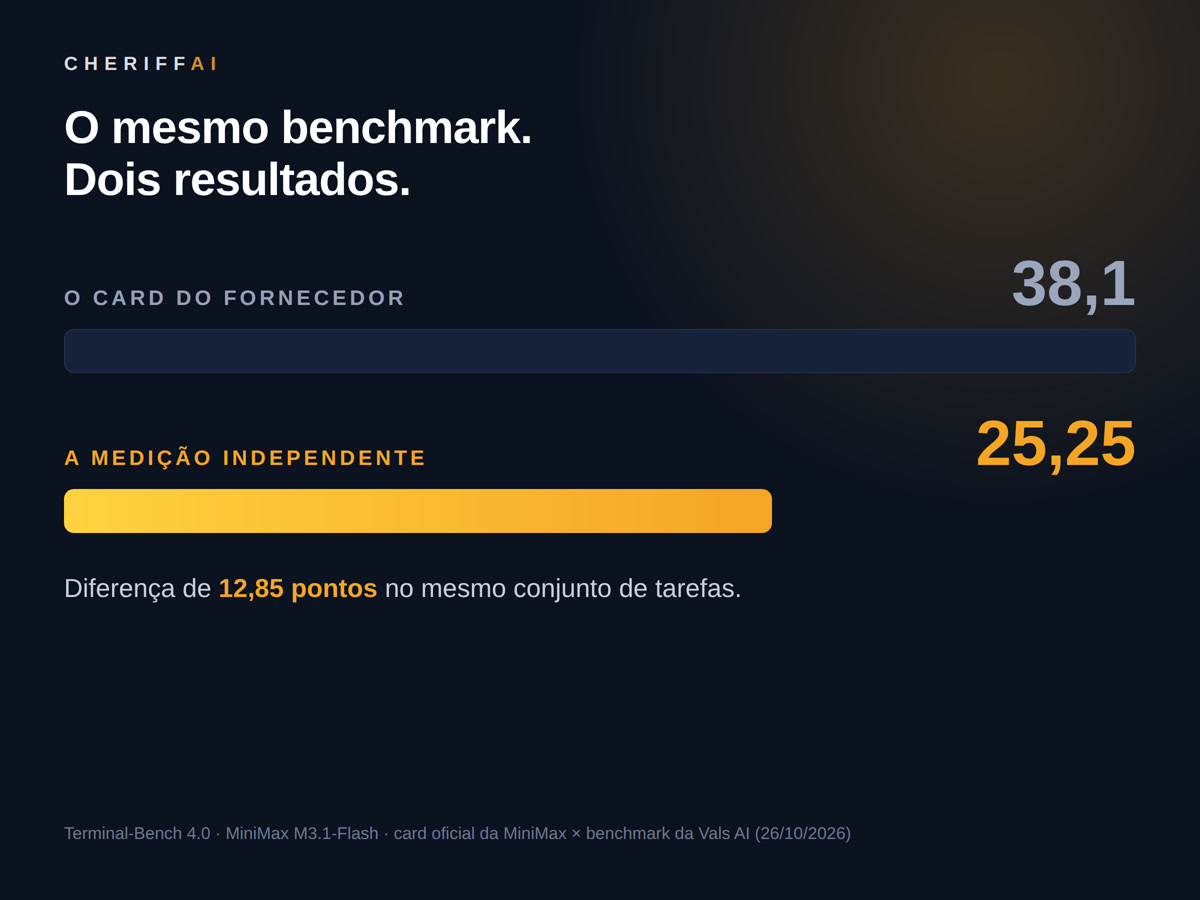
Na segunda-feira, o card do MiniMax-M3.1-Flash dizia 38,1. Na quinta, um laboratório independente publicou 25,25. Mesmo benchmark, mesmo conjunto de tarefas, mesma pergunta: quantos problemas de terminal o modelo resolve sozinho. A diferença entre os dois números é de 12,85 pontos percentuais — e não é erro de digitação de ninguém.
Esse é o tipo de caso que vale mais do que qualquer anúncio: quando duas medições honestas do mesmo modelo não batem, o número que a empresa coloca no material de lançamento deixou de ser um atalho para a decisão. Vamos pelos dois lados, com número e link.
O que o card diz
O card oficial do M3.1-Flash no Hugging Face descreve um modelo de mistura de especialistas com aproximadamente 428 bilhões de parâmetros no total e 23 bilhões ativados por token, contexto de até 1 milhão de tokens, entrada de texto, imagem e vídeo, saída de texto. A eficiência vem de três escolhas declaradas: atenção esparsa em todo o modelo (a MiniMax Sparse Attention, descrita no paper 2606.13392), treino ciente de quantização e decodificação especulativa com o cabeçote de rascunho DSpark incluído no release.
Na tabela de benchmarks do próprio card, o Terminal-Bench 4.0 aparece com 38,1 — e aqui está o detalhe que quase ninguém lê: a nota de rodapé informa que essa linha foi rodada dentro do Codex 0.149.1. Outras linhas do mesmo card usam harness diferente: o DeepSWE v1.1 (73,7%) rodou em mini-SWE-agent 2.4.5, e o CyberGym (82,2) em Claude Code 2.1.263 com 1 milhão de contexto. O card é cuidadoso e documenta cada um. Quem repete o número sem o rodapé, não.
No mesmo quadro, a MiniMax coloca os concorrentes ao lado: Automation-Bench v1.0.6 62,8 contra 60,5 do DeepSeek V4.1 Flash-1017 e 50,3 do Opus 5; DeepSWE v1.1 73,7; OSWorld 2.0 61,7 contra 65,7 do Opus 5; Terminal-Bench 4.0 38,1 contra 42,3 do DeepSeek e 51,8 do Opus 5. Ou seja: o próprio material de lançamento admite três derrotas.
O que a medição independente diz
A Vals AI é um dos poucos laboratórios que publica o resultado e a metodologia, incluindo como o modelo foi rodado: no caso do M3.1-Flash, pela API oficial da MiniMax, com temperatura 1, top_p 0,95, esforço computacional máximo e até 262 mil tokens de saída. O número que voltou do Terminal-Bench 4.0 foi 25,25%, a posição #22 de 51 modelos avaliados nesse benchmark.
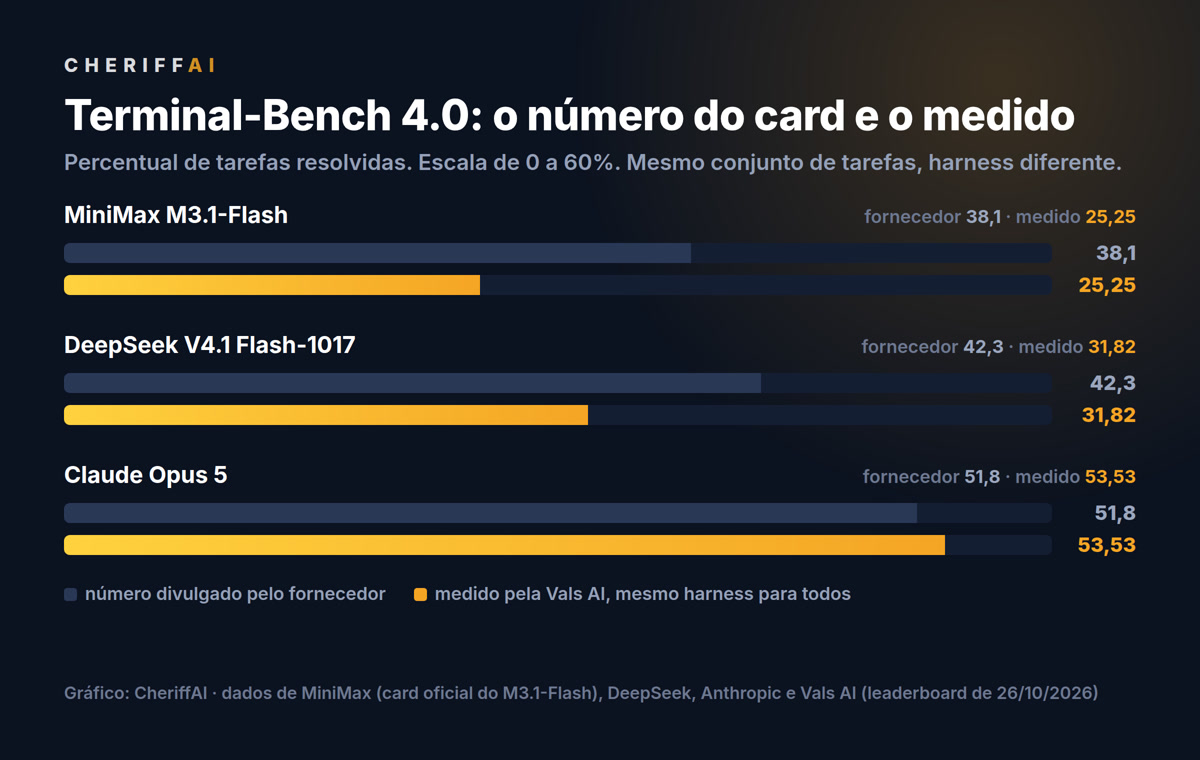
No leaderboard público atualizado em 26/10, a linha do M3.1-Flash registra 25,25%, US$ 0,73 por teste, 38,09 milhões de tokens e 50 minutos e 31 segundos por execução. No topo estão Claude Opus 5.5 (65,15%), Sonnet 5.5 (64,14%) e Kimi K3.1 Pro (63,64%). O DeepSeek V4.1 Flash-1017, que no card do concorrente valia 42,3, aparece ali com 31,82%.
E aqui vem a parte que desmonta a leitura fácil de "a MiniMax inflou o número": o Opus 5, que no card da MiniMax vale 51,8, aparece na Vals com 53,53% — mais alto do que o divulgado. Se fosse má-fé generalizada, todos os números cairiam na mesma direção. Não caem.
A explicação chata que resolve a conta: o harness
Harness é o programa que entrega o terminal ao modelo. Ele decide quando o modelo pode instalar um pacote, quantas vezes pode tentar de novo, o que conta como tarefa concluída e quando o relógio para. É o equivalente ao colega de trabalho que senta ao lado: a mesma pessoa, com um parceiro diferente, entrega um resultado diferente.
O 38,1 do card foi medido dentro do Codex. O 25,25 da Vals foi medido dentro do Mini-SWE-agent — o mesmo para todos os modelos do leaderboard. São duas provas com gabarito igual e régua diferente. Isso tem duas consequências práticas:
- O 38,1 não pode ser comparado ao 65,15 do Opus 5.5. Um número de harness diferente do outro é decoração, não comparação.
- A comparação válida é dentro da mesma coluna. Na coluna da Vals, o M3.1-Flash fica 40 pontos atrás do topo e 6,5 pontos atrás do DeepSeek V4.1 Flash-1017.
Traduzindo para quem não acompanha leaderboard: o modelo é bom em várias coisas, mas na tarefa de terminal de horizonte longo — a que exige tomar decisão, errar, corrigir e continuar sozinho por dezenas de passos — ele está na metade de baixo da tabela. E essa é justamente a tarefa que os vendedores de "agente autônomo" colocam no palco.
Onde ele ganha de verdade
A mesma avaliação independente mostra um perfil bem menos dramático. Contra o MiniMax-M3 anterior, o salto é grande e mensurável: Vibe Code Bench 73,94% contra 47,57%, Tax Agent Bench 32,14% contra 20,59% (6º entre 27 modelos abertos), EMB v1.1 67,84% contra 59,75%, Finance Agent v2.1 58,83% contra 54,34% e Legal Research 34,13% contra 29,81%.
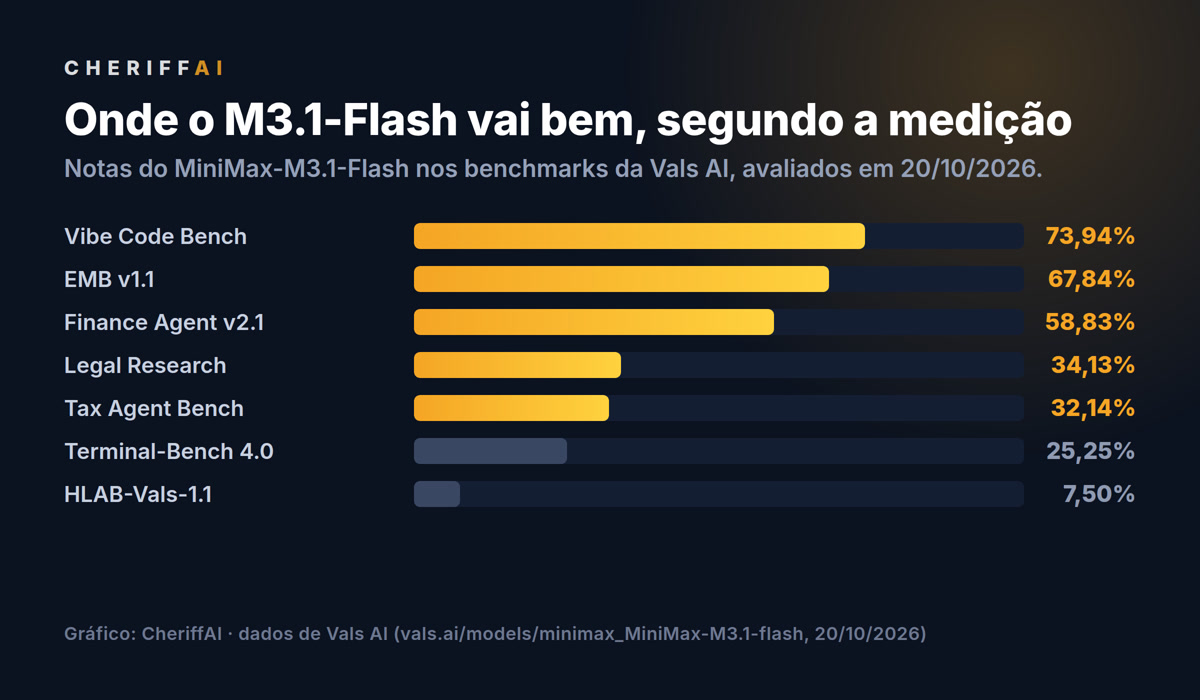
No índice agregado, o Vals Index dá 53,78% — 5º entre 11 modelos de pesos abertos, logo atrás do MiMo V2.6 Flash (54,83%). É um modelo competitivo de meio de tabela nas tarefas de escrita, finanças e código, e fraco nas duas provas agênticas longas: Terminal-Bench 4.0 (25,25%) e HLAB-Vals-1.1 (7,50%).
Quanto custa resolver uma tarefa
Preço por milhão de tokens é a métrica que todo mundo divulga, e é a que menos ajuda. O número que decide contrato é quanto custa uma tarefa resolvida, porque tarefa que falha também foi paga. Dividindo o custo por teste do leaderboard pelo percentual de acerto, chega-se a uma tabela que nenhum card publica:
| Modelo | Terminal-Bench 4.0 | Custo por teste | Custo por tarefa resolvida |
|---|---|---|---|
| Claude Opus 5.5 | 65,15% | US$ 13,20 | US$ 20,26 |
| Claude Sonnet 5.5 | 64,14% | US$ 16,51 | US$ 25,74 |
| Kimi K3.1 Pro | 63,64% | US$ 4,57 | US$ 7,18 |
| Claude Opus 5 | 53,53% | US$ 18,60 | US$ 34,75 |
| DeepSeek V4.1 Flash-1017 | 31,82% | US$ 0,54 | US$ 1,70 |
| MiniMax-M3.1-Flash | 25,25% | US$ 0,73 | US$ 2,89 |
| MiMo V2.6 Flash | 24,24% | US$ 0,21 | US$ 0,87 |
A leitura é desconfortável para o anúncio: o MiniMax M3.1-Flash é 18 vezes mais barato por teste que o Opus 5.5, mas também é 1,7 vez mais caro por tarefa resolvida que o DeepSeek V4.1 Flash-1017 — o modelo que o material de lançamento usa como comparação favorável. Quem se posiciona como "o mais eficiente" precisa ser o mais barato no fim da conta, e nessa régua específica ele não é.
O que o peso aberto não significa
O modelo é aberto de verdade: pesos públicos, acesso livre, e hoje o repositório acumula 13.247 downloads e 434 curtidas (medido na API do Hugging Face em 28/10), com 72 arquivos versionados, incluindo o cabeçote de rascunho do DSpark. Abrir o peso, porém, não é abrir a licença. O card marca license: other com licença MiniMax Community — não é OSI, não é Apache, e uso comercial tem condições próprias.
Para uma empresa brasileira avaliando o modelo, isso tem consequência jurídica concreta: "rodar local" não significa "usar de graça em produto". Vale ler a licença antes do benchmark, não depois.
O que fazer na segunda-feira
Se você está escolhendo modelo para um agente que mexe em sistemas, três procedimentos resolvem 90% da dúvida — e nenhum deles custa uma assinatura:
- Peça o harness junto do número. Se o fornecedor não diz em que programa o benchmark rodou, o número não é comparável com nada.
- Compare dentro da mesma coluna. Número de harness A contra número de harness B é folclore. Leaderboards independentes existem para isso.
- Meça na sua tarefa, com o seu harness. Trinta tarefas reais do seu fluxo valem mais que qualquer índice. O custo por tarefa resolvida do seu caso é o único que importa.
O M3.1-Flash é um bom modelo de meio de tabela com preço agressivo e um salto real sobre o M3 — isso está medido e não é opinião. O que ele não é, ainda, é o que o número de capa sugere. A diferença entre as duas coisas é exatamente o trabalho de quem lê, não de quem publica.
Fontes
- Hugging Face — card oficial do MiniMax-M3.1-Flash, com a tabela de benchmarks e o harness de cada linha (consultado em 28/10/2026)
- Vals AI — MiniMax-M3.1-Flash: benchmarks, custo e capacidades (avaliação de 20/10/2026)
- Vals AI — leaderboard do Terminal-Bench 4.0 (atualizado em 26/10/2026)
- Vals AI — metodologia do Vals Index v2.2
- arXiv 2606.13392 — MiniMax Sparse Attention, o paper citado no card
- MiniMax Platform — documentação da API usada na avaliação (preço por token e contexto)