
Em 23 de outubro a Moonshot publicou o Kimi K3.1 Pro. O anúncio abre chamando o modelo de "o mais capaz da classe de 3 trilhões de parâmetros com pesos abertos até hoje". Doze parágrafos depois, na seção de disponibilidade, vem a frase que muda a leitura de todo o resto: "os pesos completos do modelo serão liberados até 4 de novembro de 2026".
Ou seja: o modelo que se apresenta como aberto ainda não pode ser baixado. No momento em que este post foi escrito ele era o assunto nº 1 do Hacker News. Mas quem quiser usar hoje tem que passar pela API da Moonshot — o download fica para a semana que vem.
Isso não é detalhe burocrático. É a diferença entre "aberto" como característica técnica e "aberto" como promessa de calendário. E, no mesmo dia do lançamento, o avaliador independente Artificial Analysis já publicou os números — que contam uma história mais interessante do que o próprio release.
O que a Moonshot anunciou
O K3.1 Pro não é uma arquitetura nova: é um pós-treinamento do Kimi K3 (o modelo de 2,8 trilhões de parâmetros que o blog cobriu em julho) com muito mais compute de pós-treinamento. A Moonshot diz ter montado um reinforcement learning conjunto em "centenas de domínios" e otimizado cada camada da pilha — framework de RL, inferência de contexto longo, agendamento de rollouts, sandbox de execução — para que cada incremento de compute rendesse ganho estável.
O contexto é de 1 milhão de tokens, com entrada de texto e imagem. E a empresa lançou junto uma variante Highspeed, com "2 a 3 vezes a velocidade" do modelo padrão.
Os números que a própria Moonshot escolheu para abrir a conversa:
- Terminal-Bench 4.0: 65,7%, à frente do GPT-6 Astra (58,2%) e "estreitamente atrás" do Claude Opus 5.5 (66,4%);
- BenchCAD (reconstrução 3D a partir de renderizações): 92,7% com ferramentas, contra 96,2% do Opus 5.5 e 95,9% do Astra;
- OfficeQA Pro v2 (análise de documentos financeiros reais): 64,4 — a Moonshot chama de estado da arte;
- Kimi Hallu Bench (benchmark interno): a taxa de alucinação por afirmação caiu de 23,4% no K3 para 8,3% — com a ressalva, escrita no próprio texto, de que é um teste de estresse e não representa erro no uso diário.
O resumo da casa é uma frase só: "o K3.1 Pro iguala ou se aproxima dos modelos proprietários mais fortes".
O que a medição independente diz
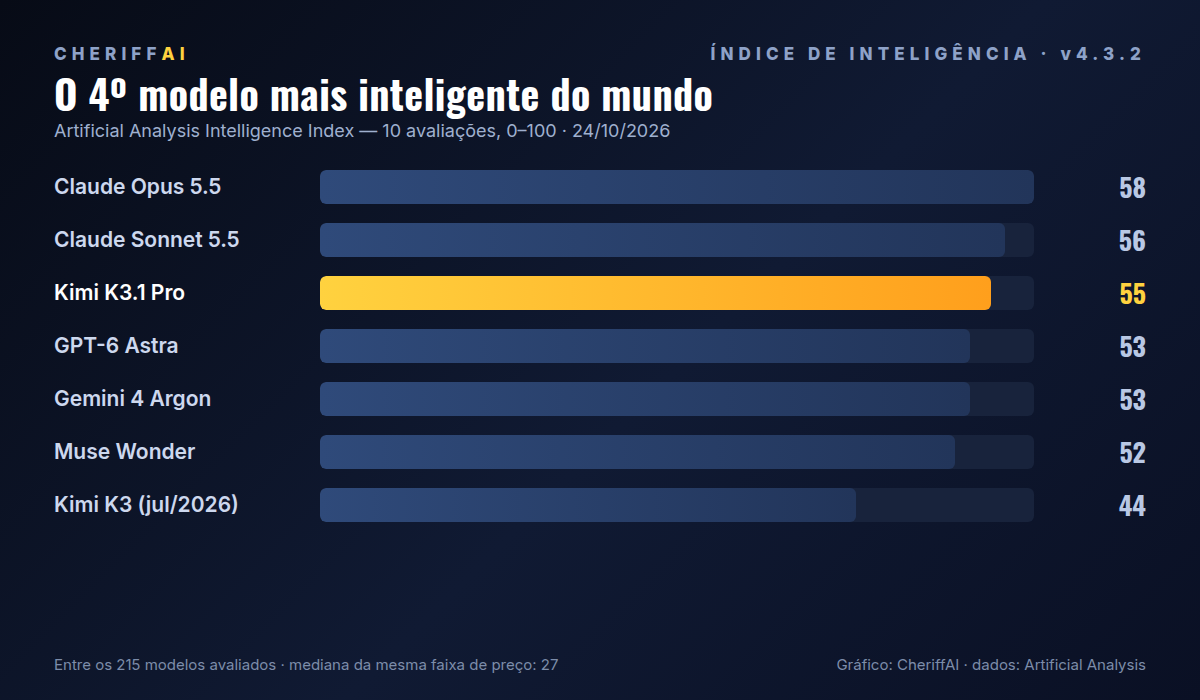
A Artificial Analysis roda os próprios testes, com os próprios prompts, e não copia tabela de fornecedor. O resultado do K3.1 Pro no Índice de Inteligência (versão 4.3.2, que junta dez avaliações) foi 55 pontos.
Isso coloca o modelo em 4º lugar entre 215 modelos avaliados — com mediana de 27 na mesma faixa de preço. Fica atrás do Claude Opus 5.5 (58) e do Claude Sonnet 5.5 (56), e à frente do GPT-6 Astra (53), do Gemini 4 Argon (53) e do Muse Wonder (52). Sobre o próprio antecessor, o salto é grande: o Kimi K3 marcava 44.
O ganho mais espetacular não está no índice composto, e sim no teste de terminal: no mesmo Terminal-Bench 4.0, o Kimi K3 acertava 13% e o K3.1 Pro acerta 67% segundo a AA. É a diferença entre um modelo que tropeça em tarefa de linha de comando e um que trabalha sozinho por horas.
A parte estranha: o número do anúncio é pior que o da medição
Aqui a história dá uma volta. No Terminal-Bench 4.0, a Moonshot se coloca atrás do Opus 5.5 (65,7 contra 66,4). A AA mede o contrário: Kimi 67% contra 60% do Opus 5.5 (e 64% do Sonnet 5.5, 59% do GPT-6 Astra).
Não é o modelo que mudou de tamanho — é o arnês. A Moonshot declara, nas notas de rodapé do anúncio, que rodou o K3.1 Pro em esforço máximo de raciocínio (temperatura 1,0, top-p 0,95) e que os testes com ferramentas usaram o harness do Claude Code. E registra que os números dos rivais na tabela vêm dos relatórios técnicos de cada fornecedor e de leaderboards oficiais — ou seja, não são execuções no mesmo arnês.
Ou seja: a tabela do fornecedor é honesta até certo ponto, mas não é uma comparação controlada. Benchmark de agente mede o pacote inteiro — modelo, arnês, orçamento de tokens, política de parada. Quando alguém troca uma peça, o placar se move. Já mostramos esse mecanismo em outro post, sobre como um benchmark pode ser trapaceado sem que ninguém minta.
Onde ele ganha de verdade
Lendo os números da AA por categoria, o K3.1 Pro é um modelo de trabalho agêntico: terminal (67%), automação de tarefas (73% no AutomationBench-AA, contra 68% do Astra e 70% do Opus 5.5) e contexto longo (86% no AA-LCR, contra 81% do Astra). No GDPval-AA, que mede entrega de trabalho econômico real, marca 1.846 pontos de Elo.
E ganha com folga na conta que importa para quem paga: o custo por tarefa. A AA calcula, com preço de token e consumo medido, US$ 2,11 por tarefa do índice — contra US$ 3,26 do GPT-6 Astra, US$ 5,46 do Sonnet 5.5 e US$ 5,98 do Opus 5.5. No preço de tabela: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, com 90% de desconto no cache.
Tem mais um número que explica por que gente de agente gosta deste modelo: o tempo até o primeiro token é de 2,97 segundos, contra 562 segundos do Opus 5.5 rodando em esforço máximo com fallback. Parece absurdo até lembrar o que está sendo medido: o Opus "pensa" muito antes de responder. Em um loop de agente que faz 40 chamadas por tarefa, essa diferença de latência decide se o fluxo termina em minutos ou em horas.
Onde ele perde — e a perda é específica
A fraqueza do K3.1 Pro não é "inteligência" genérica. É densidade de conhecimento. Nos testes que medem saber acumulado, ele fica atrás em todos:
- Humanity's Last Exam: 52% contra 55% do GPT-6 Astra e 61% do Opus 5.5;
- CritPt (raciocínio de física em nível de pesquisa): 25% contra 32% dos dois rivais;
- AA-Omniscience (calibração de conhecimento): 30 contra 43 do Astra e 46 do Opus 5.5.
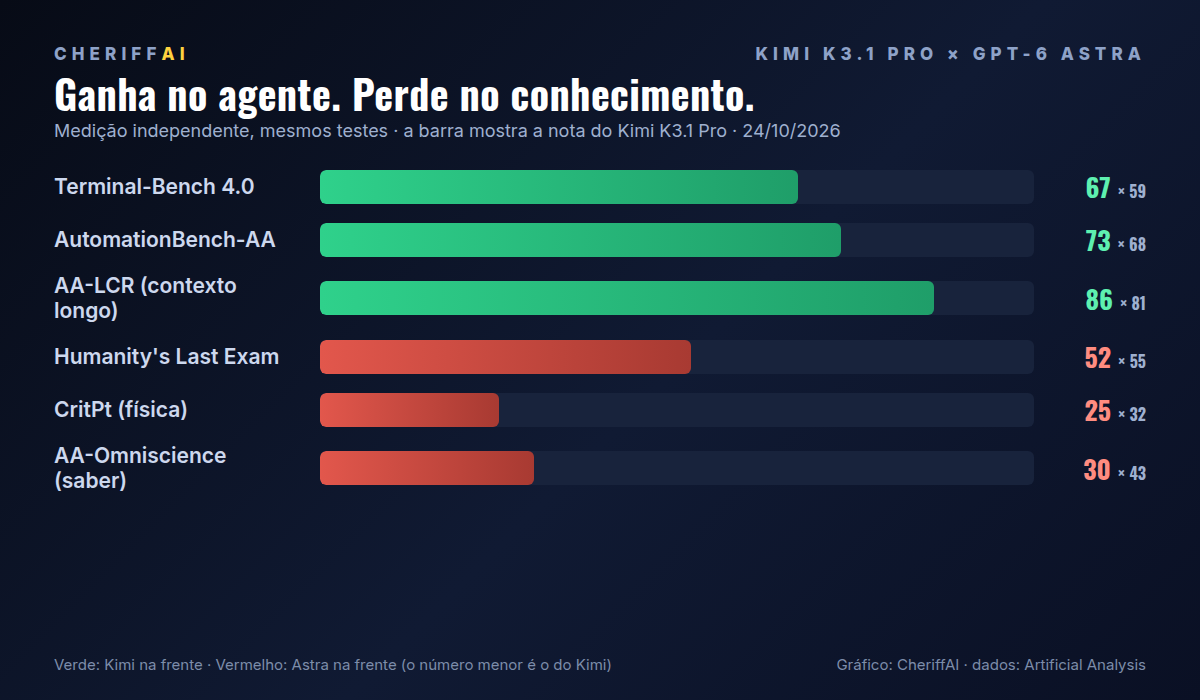
Na prática: para código, terminal, planilha e fluxo de várias etapas, é um dos melhores modelos do mundo pelo preço. Para "me diga o fato obscuro e a referência exata", ainda é um segundo escalão. Quem usa IA para pesquisa jurídica, científica ou regulatória precisa saber disso antes de trocar de fornecedor.
E há um detalhe de consumo: a AA classifica o modelo como muito verboso — 55 mil tokens de saída por tarefa, o dobro do GPT-6 Astra (27 mil), embora menos da metade do Opus 5.5 (119 mil). Como a saída é a linha cara da tabela (US$ 10 por milhão), o preço baixo por token é parcialmente devolvido em verbosidade. O número que sobrevive a isso é justamente o custo por tarefa, e nele o Kimi ainda ganha.
O peso que ainda não saiu
Voltemos à frase do começo. Na ficha técnica da Artificial Analysis, o campo "Open Source (Weights)" do Kimi K3.1 Pro está marcado como "No" — enquanto o Kimi K3, de julho, está marcado "Yes", sob a Kimi K3 License, com uso comercial sem restrições.
Não é erro do avaliador: é o retrato de 24 de outubro. Enquanto os pesos não saem, o K3.1 Pro é um modelo fechado com promessa de abertura — e a promessa tem data (4 de novembro) mas não tem licença publicada. Para quem planeja rodar o modelo em infraestrutura própria, isso muda o cálculo: o custo, o hardware e a licença do dia 4 ainda são incógnitas.
A boa notícia é que a Moonshot cumpriu esse calendário antes: o K3 de julho saiu aberto de verdade. A pergunta é se o K3.1 Pro sai com a mesma licença ou com uma versão mais restrita — algo que só se responde abrindo o repositório.
O corte que a Moonshot fez de propósito
Tem um parágrafo no anúncio que quase ninguém citou e que, na nossa leitura, é o mais honesto do release. A Moonshot conta que, ao escalar o pós-treinamento, a capacidade de pesquisa de vulnerabilidades subiu junto — e que a causa era conteúdo de cibersegurança dentro do corpus de mid-training e tarefas de cyber na mistura de RL. A resposta foi remover esse conteúdo e filtrar os ambientes de treino.
O efeito está medido no benchmark interno deles: o checkpoint sem essas medidas resolve 90,5% dos problemas do xdev-bench-hard; o K3.1 Pro final resolve 81,0%. A Moonshot escreve a intenção sem rodeios: "não queremos liberar pesos abertos que estendam a fronteira absoluta da capacidade cibernética".
Isso é um precedente importante e vale para toda a indústria: o modelo aberto agora vem com tampa escolhida a dedo. É uma decisão defensável — e, ao mesmo tempo, a confirmação de que "aberto" nunca significou "sem controle".
O que isso muda para quem usa IA no Brasil
Três consequências práticas para times que avaliam modelos hoje:
- Se você quer self-host, espere o dia 4. Até lá o K3.1 Pro é API. Baixar peso de 2,8 trilhões de parâmetros não é trivial de qualquer forma — o que a abertura muda é quem pode auditar o modelo e quem pode afiná-lo.
- Meça custo por tarefa, não preço por token. A diferença entre US$ 2,11 e US$ 5,98 por tarefa é o que decide o orçamento de um agente que roda mil vezes por dia. E ela só aparece quando você conta os tokens que o modelo realmente gastou.
- Rode a sua própria bateria de 20 tarefas. O ranking muda conforme o arnês — vimos isso no mesmo benchmark, no mesmo dia. Um teste pequeno, com as suas tarefas reais, vale mais que a tabela do fornecedor e o índice do avaliador juntos.
O anúncio diz "aberto". A medição diz "4º lugar do mundo, e mais barato que os três da frente". As duas frases convivem — desde que você saiba qual ler primeiro, e que a segunda tem data para deixar de ser promessa.
Fontes
- Kimi (Moonshot AI) — Kimi K3.1 Pro Tech Blog: Advancing Open Intelligence (23/10/2026)
- Artificial Analysis — Kimi K3.1 Pro: Intelligence, Performance & Price Analysis (24/10/2026)
- Artificial Analysis — Kimi K3.1 Pro vs. Claude Opus 5.5 (Max, Default Fallback) (24/10/2026)
- Artificial Analysis — Kimi K3.1 Pro vs. GPT-6 Astra (Max) (24/10/2026)
- Artificial Analysis — Kimi K3.1 Pro vs. Kimi K3 (Max) (24/10/2026)
- Kimi Platform — API do K3.1 Pro (acesso em 24/10/2026)