
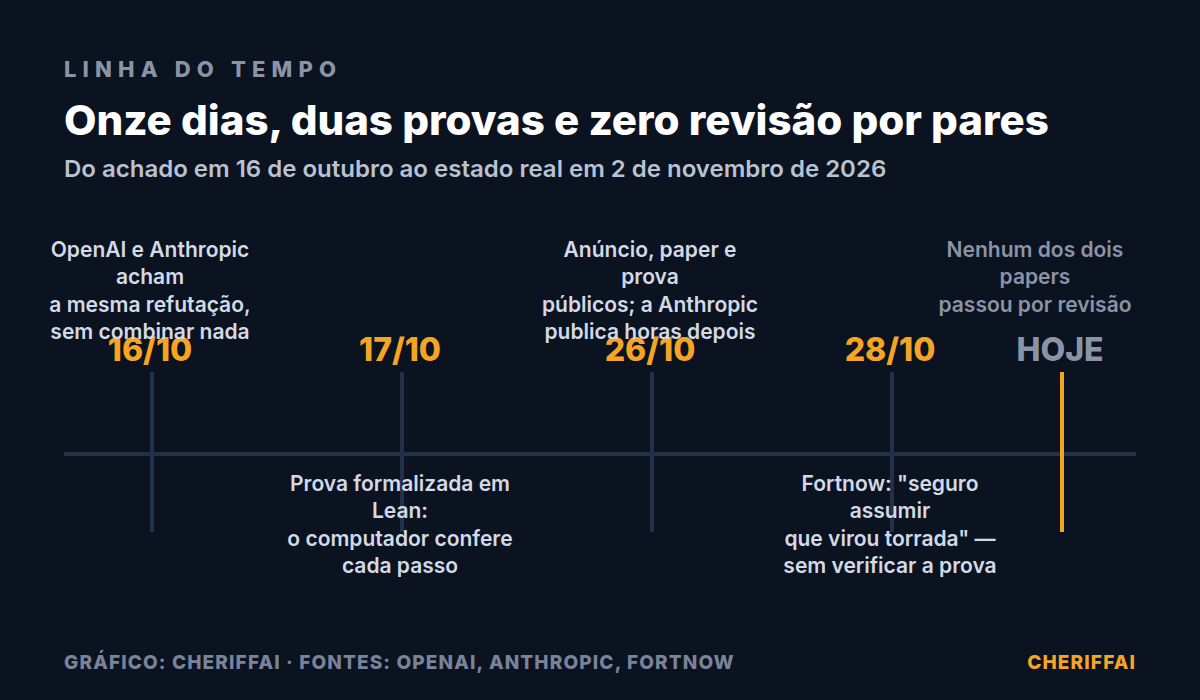
Em 16 de outubro de 2026, dois laboratórios diferentes anunciaram, sem combinar nada, o mesmo achado: uma inteligência artificial havia derrubado uma conjectura que a ciência da computação tratava como verdade desde 1999. Dez dias depois, a OpenAI publicou o resultado — e, horas depois, a Anthropic publicou o seu. Duas IAs, dois papers, a mesma conclusão, o mesmo dia de descoberta.
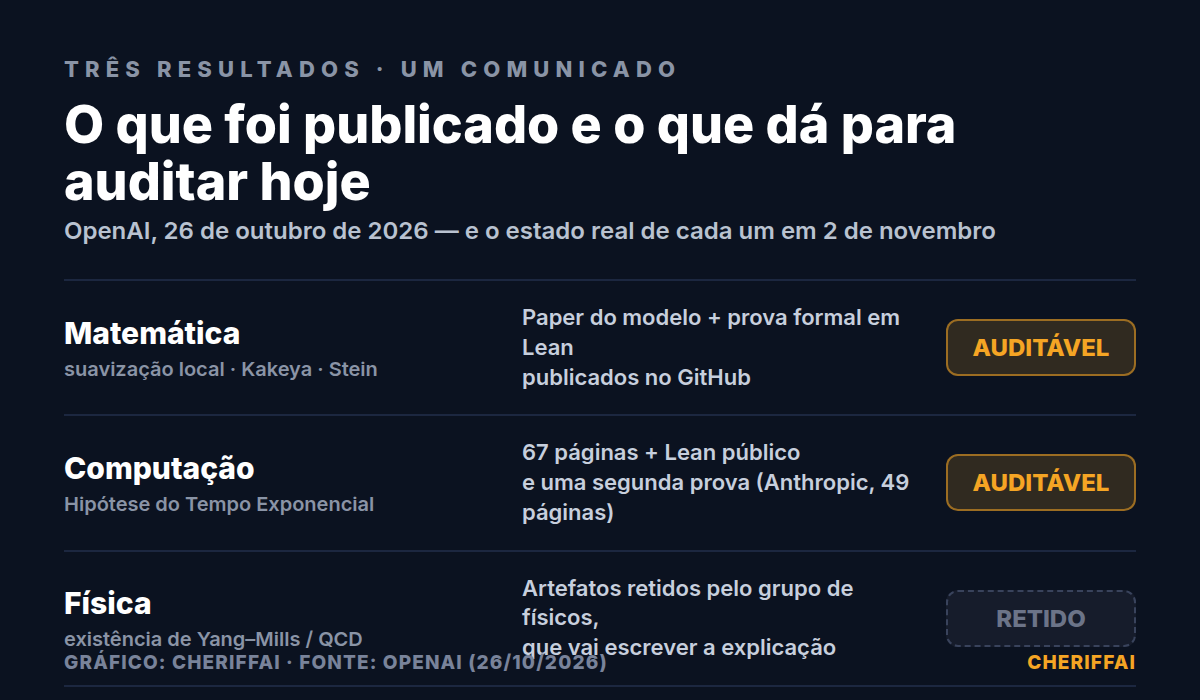
O que torna essa história mais interessante do que "IA faz matemática" é o que veio junto: a OpenAI anunciou três descobertas no mesmo comunicado e, para as três, escolheu uma forma diferente de divulgar. Das três, só duas podem ser conferidas por qualquer pessoa com um computador hoje. A terceira está retida por decisão dos próprios físicos que foram chamados para avaliar.
É aí que esta história deixa de ser sobre modelos e passa a ser sobre a palavra que virou o gargalo de 2026: verificado.
O que exatamente caiu
A conjectura que caiu é a Hipótese do Tempo Exponencial (ETH, na sigla em inglês), proposta em 1999 por Russell Impagliazzo e Ramamohan Paturi. Em linguagem de gente: ela dizia que existe um tipo de problema — satisfazer fórmulas lógicas do tipo 3-SAT — que não tem jeito de ser resolvido muito mais rápido do que testar as combinações uma por uma.
Não é um detalhe acadêmico. A ETH era usada como alicerce em centenas de papers para provar que certos problemas são "difíceis demais" — em teoria dos grafos, biologia computacional, bancos de dados, geometria, e em toda a área que estuda limites de algoritmos. Quando o alicerce é uma hipótese, cada paper herda a aposta. Se a hipótese cai, a cadeia de consequências precisa ser reescrita ou passa a valer por outros motivos.
Segundo a publicação oficial da OpenAI em 26/10, o modelo interno encontrou a refutação em 16 de outubro, e a prova foi formalizada em Lean — um programa que confere passo a passo se uma demonstração está correta — no dia seguinte, 17 de outubro. O texto tem 67 páginas e autor "OpenAI". O resumo técnico é direto: existe um algoritmo determinístico que conta as soluções de uma fórmula k-CNF em tempo proporcional a 2 elevado a n dividido por raiz de log n. Como esse divisor cresce com n, o tempo deixa de ser exponencial no sentido que a ETH exigia.
Traduzindo o tamanho do feito: para uma fórmula com 1 milhão de variáveis, o expoente deixa de ser 1.000.000 e passa a ser algo em torno de 220 mil. Continua sendo um número absurdo de grande — não é uma revolução prática, e a própria Anthropic escreve isso em letras maiúsculas no seu repositório: o resultado "é puramente assintótico e não diz nada sobre resolver fórmulas na prática". O valor está em outro lugar: a fronteira do que é possível mudou de lugar.
O segundo resultado: ondas que se concentram
A descoberta de matemática é sobre a conjectura de suavização local (local smoothing), que Christopher Sogge propôs em 1991. Ela fala do comportamento de ondas quando se concentram: diz que a concentração máxima tem de ser curta. Em 2019, Guth, Wang e Zhang provaram o caso de duas dimensões espaciais; agora, segundo a OpenAI, o modelo provou o caso de todas as dimensões.
O peso disso aparece nas consequências: a prova, se confirmada, resolve também a conjectura de Kakeya e as estimativas de restrição de Stein em todas as dimensões. É a diferença entre acertar uma peça e destravar uma família inteira de problemas. A OpenAI obteve o resultado em 18/10, formalizou em Lean no dia 19 e publicou o texto produzido pelo modelo e a prova formal no GitHub.
O terceiro resultado que ninguém pode ler
O terceiro achado é o mais impressionante no papel e o menos verificável na prática: uma prova de existência, matematicamente rigorosa, de certas teorias quânticas de campo com campos de gauge e férmions em quatro dimensões — incluindo a cromodinâmica quântica (QCD) e uma extensão unificada do Modelo Padrão. Como subproduto, a prova de existência da teoria de Yang–Mills pura, que é parte de um dos Problemas do Milênio do Clay Institute. Só a parte de existência: o mass gap continua aberto.
Os números de bastidor: a prova em linguagem natural saiu em 9 de setembro, a versão para QCD em 18 de setembro, e a formalização em Lean só terminou em 16 de outubro. O grupo chamado para avaliar é liderado por David Gross (Nobel de Física de 2004) com Michael Douglas, Arthur Jaffe, Igor Klebanov e Nikita Nekrasov. E o grupo decidiu não liberar os artefatos produzidos pela IA — vai escrever a explicação por conta própria, e a OpenAI aceitou.
Compare os três tratamentos, no mesmo comunicado:
"Verificado" não quer dizer o que você acha
Aqui está a parte que quase nenhuma manchete contou. Uma prova formalizada em Lean é conferida por um programa que não erra passo lógico — e isso é uma garantia real, muito mais forte do que "um colega leu e achou bom". Mas ela é uma garantia condicional: o Lean verifica que a prova decorre das afirmações que estão escritas no arquivo. Ele não verifica se essas afirmações são as mesmas do paper.
O repositório da Anthropic diz isso com uma honestidade rara: "Lean confere as provas, mas nenhuma máquina confere que este arquivo diz o que o paper diz; o arquivo é mantido curto justamente para que um leitor humano possa conferir isso". Lá dentro há um arquivo, MainResults.lean, com as duas afirmações centrais e nenhuma prova, importando apenas a biblioteca padrão de matemática.
Ou seja, existe uma camada de tradução — do que o modelo escreveu em português matemático para o que foi codificado em linguagem formal — que nenhum programa cobre. É exatamente aí que mora o risco de um "provado" que na verdade prova outra coisa. A conferência dupla que a Anthropic roda (Lean mais um segundo verificador independente, o nanoda) reduz erro de implementação, não erro de tradução.
O que os matemáticos de verdade disseram
Timothy Gowers, medalha Fields, escreveu que o resultado é "muito surpreendente e consequente". Lance Fortnow, um dos nomes mais conhecidos da teoria da complexidade, foi mais longe no seu blog em 28/10: "não verifiquei a prova pessoalmente, mas é seguro assumir agora que a hipótese do tempo exponencial virou torrada".
O mesmo texto, porém, coloca três travas que as manchetes ignoraram. Primeira: a prova em Lean estabelece um limite um pouco mais fraco que o do paper. Segunda: o fato de ETH e SETH caírem não torna falsas as consequências que foram derivadas delas — o que caiu foi o alicerce, não os teoremas. Terceira: para problemas como Subset Sum e o caixeiro-viajante, nada muda.
E os três pesquisadores que a OpenAI chamou para organizar a avaliação — Impagliazzo e Paturi, os autores da hipótese, mais Ryan Williams, do MIT — assinaram uma carta pública dizendo que o envolvimento deles "não deve ser tomado como certificação da alegação". Nenhum dos dois papers passou por revisão por pares.
O contraponto que dói: o próprio conselho da OpenAI recomendou o contrário
O detalhe mais revelador apareceu no dia anterior ao anúncio. Segundo a cobertura do The Verge, o painel de conselheiros matemáticos da própria OpenAI (AGMAI) publicou uma recomendação dizendo que as empresas de IA não deveriam adotar a prática de designar pessoas específicas para receber o resultado antes dos outros — apontando acesso desigual, reputação emprestada e seleção enviesada como problemas. A recomendação era publicar em repositórios acadêmicos, com prova formalizada em Lean, informação sobre como os problemas foram escolhidos e financiamento para quem for entender o resultado.
Um dia depois, a OpenAI anunciou exatamente o modelo de "padrinhos" (shepherds) que o painel desaconselhou — com a diferença de que, no caso da ciência da computação, o grupo pediu que tudo fosse publicado imediatamente, e foi. No caso da física, o grupo preferiu reter. A empresa reconhece o trade-off no próprio texto: escolher quem vê primeiro "necessariamente molda quem participa primeiro e cria assimetria de informação".
Isso não é detalhe de relações públicas. É a diferença entre "a IA provou" e "nós podemos conferir que a IA provou". Publicar a prova formal e o paper é o que transforma um anúncio em material auditável — e é justamente o que faltou no terceiro resultado.
O que isso muda para quem trabalha com software no Brasil
Três consequências práticas, na ordem de urgência:
- Quem usa complexidade fina como argumento de arquitetura precisa revisar a dependência. Se alguma decisão sua — de banco de dados, de indexação, de algoritmo de busca — foi justificada com "não existe algoritmo melhor que X assumindo ETH", essa justificativa perdeu o lastro teórico. A decisão pode continuar correta por motivos práticos, mas o argumento mudou de base.
- Nada muda na sua máquina hoje. O resultado é assintótico. Não existe biblioteca nova, não existe speedup, e a própria Anthropic escreve que ele "não diz nada sobre resolver fórmulas na prática". Quem vender "3-SAT rápido" nos próximos meses está vendendo outra coisa.
- O gargalo virou gente que confere. Dois laboratórios produziram em um mês mais matemática de fronteira do que uma universidade inteira produz em anos. O recurso escasso agora é quem entende o suficiente para dizer se a tradução do paper para o Lean está certa. Isso é uma avenida real para times de auditoria e verificação — inclusive no Brasil, onde o custo de hora técnica é competitivo.
O acervo aberto que ninguém está lendo
O repositório openai/math é, hoje, um dos maiores conjuntos de matemática formalizada já publicados: licença Apache 2.0, 17.267 estrelas, 1.942 forks, 751 diretórios de manuscritos e 245 arquivos de prova em Lean. É grátis, é público, e a barreira para auditar é saber ler matemática — não é acesso.
É o contraste mais forte do ano. Nunca foi tão barato gerar um resultado de fronteira e nunca foi tão caro conferir. A CheriffAI mede, e a medição aqui é essa: os dois resultados que podem ser auditados estão no ar há uma semana, com prova formal e paper; o terceiro continua sendo uma frase em um comunicado. A diferença entre eles não é de qualidade — é de acesso.
Quando a poeira baixar, o que vai ficar não é o modelo que escreveu a prova. Vai ficar quem conseguiu mostrar que ela estava certa.
Fontes
- OpenAI — Working with academic communities to build scientific understanding (26/10/2026)
- GitHub — openai/math: manuscritos e provas formais em Lean (Apache-2.0; 17.267 estrelas, consultado em 02/11/2026)
- Preprint — The Exponential Time Hypothesis is False (OpenAI, 17/10, rev. 25/10/2026)
- Lean — formalização da refutação da ETH no repositório openai/math
- Anthropic — A 2^o(n) Time Algorithm for 3-SAT: paper e formalização em Lean 4 (26–27/10/2026)
- The Verge — OpenAI announces three big science discoveries and a new way to work with academics (26/10/2026)
- Computational Complexity (Lance Fortnow) — The Exponential Time Refutation (28/10/2026)
- Annals of Mathematics — Guth, Wang e Zhang, prova da suavização local em duas dimensões (2020)
- Clay Mathematics Institute — enunciado do Problema do Milênio de Yang–Mills quântico