
A notícia que passou rápido demais
Na manhã de 30 de setembro, a DeepSeek usou o seu canal oficial no WeChat — o mesmo lugar onde ela costuma anunciar as coisas grandes — para dizer uma frase curta: abriu o código dos programas que fazem o chip da Huawei funcionar. Seis componentes de uma vez. Em poucas horas, Reuters, Bloomberg e o South China Morning Post estavam em cima da história, e o mercado começou a discutir se a Nvidia tinha acabado de perder alguma coisa importante.
Tem um detalhe que faz esse anúncio valer muito mais do que parece. A DeepSeek não abriu um modelo. Ela abriu o software — a camada chata, invisível, que fica entre o modelo e o chip. E é justamente ali, e não no hardware, que mora a muralha que mantém o mundo inteiro comprando da Nvidia há vinte anos.
O que exatamente foi aberto
Para entender o tamanho do que foi liberado, é preciso saber o que é um kernel. Quando uma IA roda, ela executa milhões de contas simples: multiplicações de matrizes, somas, comparações, filtros. O kernel é o pequeno programa que ensina o chip a fazer essas contas do jeito mais rápido possível. Escrever um kernel bom à mão é trabalho de especialista — semanas de ajuste fino para cada pedacinho de operação, e um erro de memória aqui derruba todo o ganho de velocidade ali.
A DeepSeek abriu seis peças, todas espelhando o que ela já havia aberto antes para as placas da Nvidia:
| Componente | Para que serve, em português |
|---|---|
| TileLang | A linguagem em que se escrevem os kernels. É a peça central de tudo. |
| DeepGEMM-Ascend | As contas de matriz — a matéria-prima matemática de qualquer rede neural. |
| DeepEP-Ascend | A conversa entre os chips: como milhares de processadores trocam dados sem travar. |
| TileKernels | Um pacote de operações prontas do dia a dia do treinamento. |
| FlashMLA | A atenção eficiente para textos longos — o que permite um modelo “lembrar” de muita coisa. |
| DeepSelect | A triagem de dados. A DeepSeek diz que é de 2 a 20 vezes mais rápida que o comando padrão do mercado. |
Uma nuance técnica que quase ninguém citou: quatro desses projetos já eram multiplataforma e acabaram de ganhar o suporte ao Ascend — TileLang, TileKernels, FlashMLA e DeepSelect. Os outros dois (DeepGEMM-Ascend e DeepEP-Ascend) são repositórios novos, criados só para o chip da Huawei, mas com a mesma interface do original. Ou seja: não é uma gambiarra para o mercado chinês, é a mesma biblioteca com um segundo motor embaixo do capô.
E a frase mais importante do anúncio foi esta: todo operador do TileLang que a DeepSeek usou para treinar os modelos da linha V4 agora tem uma implementação de alta performance no Ascend. Traduzindo: o software com que a empresa treina o seu próprio modelo de fronteira já roda no chip doméstico.
A muralha nunca foi o chip
Aqui está o erro que quase todo mundo comete ao olhar para a Nvidia. A gente acha que o poder dela são as placas: o silício, a memória, a velocidade. Não é. Metade da história — e talvez a metade que realmente decide — é o CUDA, o conjunto de ferramentas com que os programadores conversam com essas placas desde 2006.
Pense no CUDA como um idioma. Durante vinte anos, praticamente todo mundo que quis trabalhar com IA aprendeu a falar esse idioma. Junto com ele vieram as bibliotecas, os manuais, os cursos, as carreiras inteiras e uma montanha de código de produção que assume, sem pensar duas vezes, que existe uma placa verde embaixo. Já apareceram concorrentes mais rápidos e mais baratos antes. Nenhum deles resolveu o problema real: quem troca de chip precisa escrever tudo de novo, em outro idioma, e ainda perder desempenho no meio do caminho.
É por isso que a jogada de 30 de setembro não é “mais um projeto open source”. É a tentativa de apagar exatamente esse custo de troca para qualquer empresa chinesa disposta a migrar para o Ascend. Você pode proibir a venda de um chip. Proibir um arquivo de código aberto que qualquer um baixa e melhora é bem mais difícil.
O que o TileLang faz de diferente
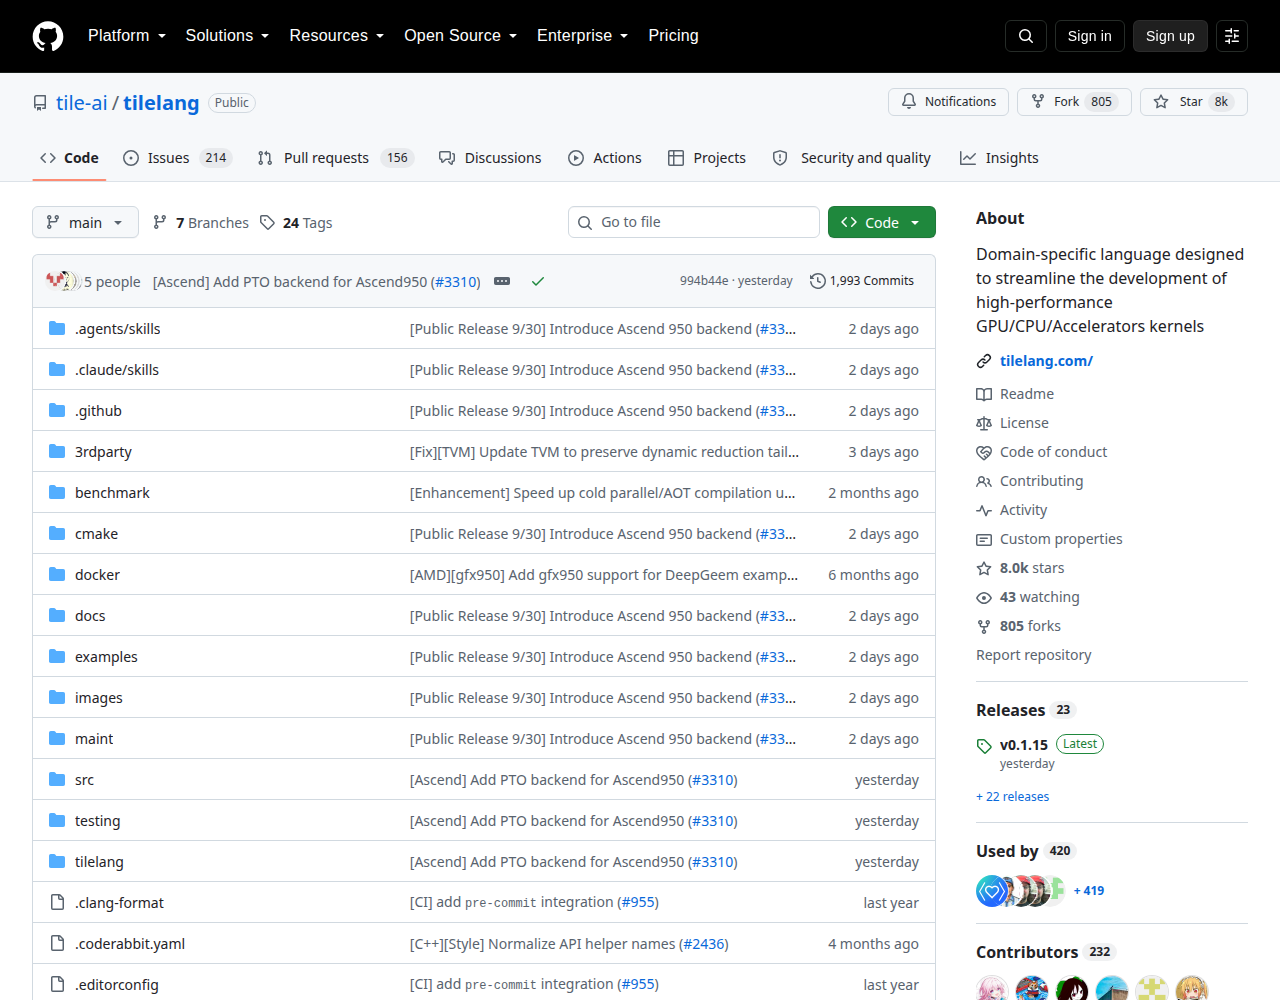
O TileLang não nasceu agora, e nem dentro da DeepSeek. É uma linguagem criada por pesquisadores da Universidade de Pequim, aberta em janeiro de 2025, pensada para escrever kernels com cara de Python. Em vez de você descrever como o chip deve mover cada pedaço de memória — o que consome semanas de um especialista —, você descreve o que quer calcular. O compilador cuida do resto: organiza os laços, decide o que fica no cache, distribui o trabalho pelos núcleos.
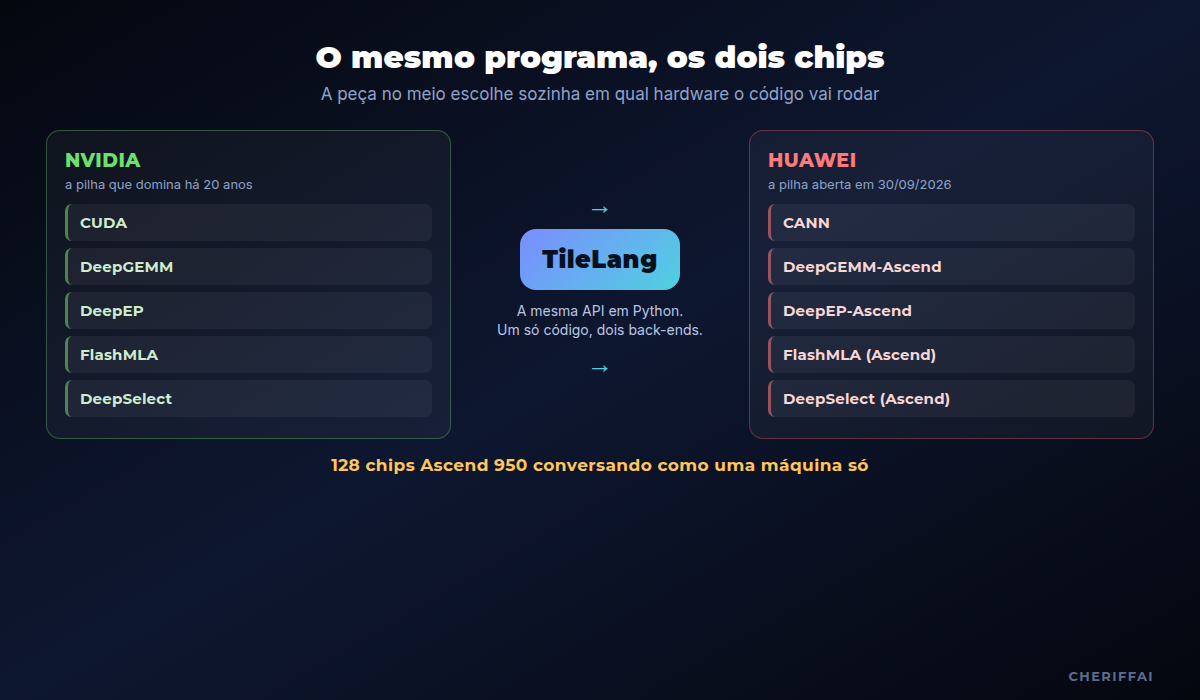
O projeto já tinha mais de 7.900 estrelas e cerca de 800 forks no GitHub antes dessa atualização, com 232 contribuidores. A versão de 30 de setembro adicionou o suporte ao Ascend 950 com um detalhe elegante: é o mesmo código em Python dos dois lados. Você não escolhe o back-end — ele é escolhido sozinho, na hora de rodar. Escreve uma vez, roda em Nvidia ou em Huawei.
A DeepSeek afirma que o modelo de programação do TileLang é mais simples que o do CUDA. Isso não é só frase de marketing: já existem trabalhos independentes mostrando kernels escritos em TileLang chegando muito perto de código CUDA otimizado à mão no mesmo hardware. E, segundo o New York Times, o TileLang virou a ferramenta principal da DeepSeek na pesquisa em direção à AGI.
Como a China chegou aqui
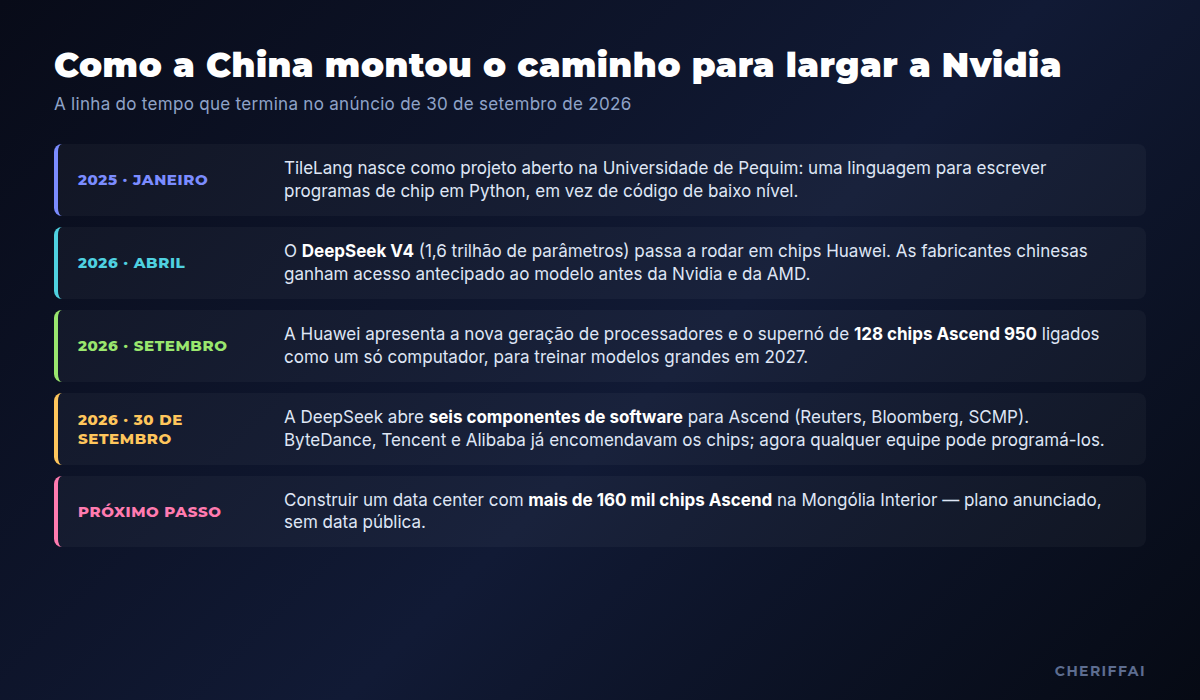
Nada disso caiu do céu. É uma sequência construída em etapas, e cada etapa foi preparando a seguinte.
128 chips conversando como se fossem um só
Treinar um modelo grande não é um chip trabalhando sozinho: são milhares deles precisando conversar sem parar. Metade do problema é o cálculo; a outra metade é o encanamento — a velocidade com que os chips trocam dados entre si.
Junto com a DeepSeek, a Huawei otimizou um supernó: 128 chips Ascend 950 ligados de forma que funcionam como uma máquina única, com rede de 3,2 terabits por segundo na camada de conexão direta. Nas medições divulgadas, a biblioteca de comunicação DeepEP-Ascend alcançou 375 GB/s de envio e 347 GB/s de retorno — números que a própria DeepSeek descreve como próximos do limite físico do hardware.
E o dado que dá a dimensão prática: rodando o DeepSeek-V4.1-Flash em 32 chips, no modo offline, a Huawei e a DeepSeek mediram 2.469 tokens por segundo por chip com 5 milissegundos por token, e 5.102 tokens por segundo por chip com 10 milissegundos por token. É esse tipo de número — e não um slide de benchmark — que convence um diretor de infraestrutura a assinar o pedido de compra.
A parte honesta: o chip chinês ainda é mais lento
Nada disso significa que a Huawei empatou com a Nvidia, e é bom ser claro sobre isso.
A pesquisa da própria DeepSeek, reportada pelo Tom’s Hardware, aponta o Ascend 910C — a geração anterior — entregando cerca de 60% da velocidade de inferência da H100 da Nvidia. E veja bem: esse é o número do chip anterior. Da geração 950, que é a que acaba de ganhar o software, ninguém publicou comparação independente.
Mais: o anúncio não veio com tabela de benchmarks completa, e nenhum grupo externo testou os componentes do Ascend 950 até agora. A SemiAnalysis, que costuma rodar as comparações mais duras do setor, ainda não passou o teste de cargas de agente no hardware da Huawei. Quando esses resultados saírem, eles vão dizer o quanto esse caminho é real — e não o quanto ele é bonito no anúncio.
Por que dar o software de graça é a jogada
Cobrar pelo pacote não faria sentido: o objetivo nunca foi a receita da licença. É adoção. Cada equipe que escrever kernels em TileLang em vez de CUDA é uma equipe cuja próxima compra de hardware fica em aberto — e o caminho mais rápido para corroer uma muralha de software de vinte anos é tornar a alternativa gratuita, familiar e rápida.
O terreno já vinha sendo preparado. Em abril, a DeepSeek adaptou o seu modelo V4 — de 1,6 trilhão de parâmetros — para rodar em hardware Huawei, e deu acesso antecipado ao teste de desempenho para fabricantes chinesas de chip, não para a Nvidia ou a AMD. Depois disso, ByteDance, Tencent e Alibaba correram para encomendar processadores Ascend 950. Há também um data center planejado na Mongólia Interior com mais de 160 mil chips Ascend.
A pressão já se reflete no mercado: segundo a Bloomberg Intelligence, a fatia da Nvidia na China caminha para um dígito, e o H20 — o chip capado criado para atender às regras americanas de exportação — vive às voltas com problemas de licenciamento. Cada restrição nova que Washington adiciona dá às empresas chinesas mais um motivo para construir uma pilha que não precise de aprovação americana para funcionar. O próprio Jensen Huang, chefão da Nvidia, já disse que ver a DeepSeek otimizando para a arquitetura da Huawei seria um mau resultado para os Estados Unidos. É exatamente o que está acontecendo, à vista de todos.
O que ainda não sabemos
Entre “dá para usar” e “eu escolho usar” existe um oceano. Para programar em Ascend ainda é preciso dominar a caixa de ferramentas CANN da Huawei, em versão 9.20 ou superior, além do pacote de integração do PyTorch — e alguns dos repositórios recém-criados admitem que partes do código ainda estão em desenvolvimento, com aviso para quem pensa em levar para produção.
Do outro lado, o CUDA acumula duas décadas de bibliotecas, depuradores, tutoriais e milhões de desenvolvedores. Muralhas assim não caem num anúncio. Caem quando a alternativa deixa de ser aceitável e passa a ser preferível — e isso se mede em anos, não em dias.
O que isso tem a ver com o Brasil
O Brasil não fabrica os chips que treinam IA, e não vai fabricar amanhã. Mas essa história fala de um problema que é nosso também — e que costuma passar batido.
A dependência de IA não mora onde parece. Um hospital brasileiro que usa IA para triagem, um banco que automatiza análise de crédito, uma indústria que coloca visão computacional na linha de produção: nenhum deles compra chips. Todos compram um serviço de nuvem que roda em chips de alguém. A pergunta que quase ninguém faz é simples: o que exatamente me prende a esse fornecedor? É o preço, é o contrato, ou é o fato de que migrar significaria reescrever tudo do zero?
Quando a resposta é a última, você não tem um fornecedor: tem uma coleira. E coleiras tecnológicas não se rompem na hora do aperto — se desfazem devagar, com padrões abertos, conhecimento acumulado e gente treinada na camada de abstração, não no produto de uma marca específica. Foi isso que a DeepSeek fez pela indústria chinesa: transformou um custo de troca proibitivo em uma biblioteca de código aberto. Para quem consome IA no Brasil, a lição prática é menos geopolítica e mais chata: saiba onde está a sua amarra antes de precisar soltá-la.
No fim, é sobre quem escreve o idioma
A parte mais interessante dessa história não é um chip ficar mais rápido. É que a disputa saiu do silício e foi para a camada onde se escrevem as regras — o idioma em que se programa o futuro. Durante vinte anos, esse idioma foi um só, patenteado e dono do próprio nome. A partir de 30 de setembro de 2026, existe uma segunda gramática, aberta, capaz de descrever os mesmos cálculos nos dois mundos.
Pode dar em nada: software livre sem adoção é só um repositório bonito. Mas os sinais de adoção já estão lá — os pedidos de chip, o data center de 160 mil aceleradores, as fabricantes parceiras. Se der certo, a lição que sobra é maior que a China: em tecnologia, a muralha que protege um líder raramente é o produto que ele vende. É o hábito que ele ensinou os outros a ter.