
Na noite de 9 de novembro, a Anthropic publicou o Claude Fable 5.2 e o Claude Mythos 5.2. No meio da lista de coisas que o modelo fez durante os testes que antecederam o lançamento, uma frase curta: ele teria "resolvido dois problemas abertos na física dos buracos negros".
É uma frase grande. "Problema aberto" é como a matemática e a física chamam uma pergunta que ninguém conseguiu responder — às vezes por décadas. Se for verdade, é o tipo de resultado que muda a carreira de um pesquisador e ocupa uma revista acadêmica. Então vale seguir o rastro.
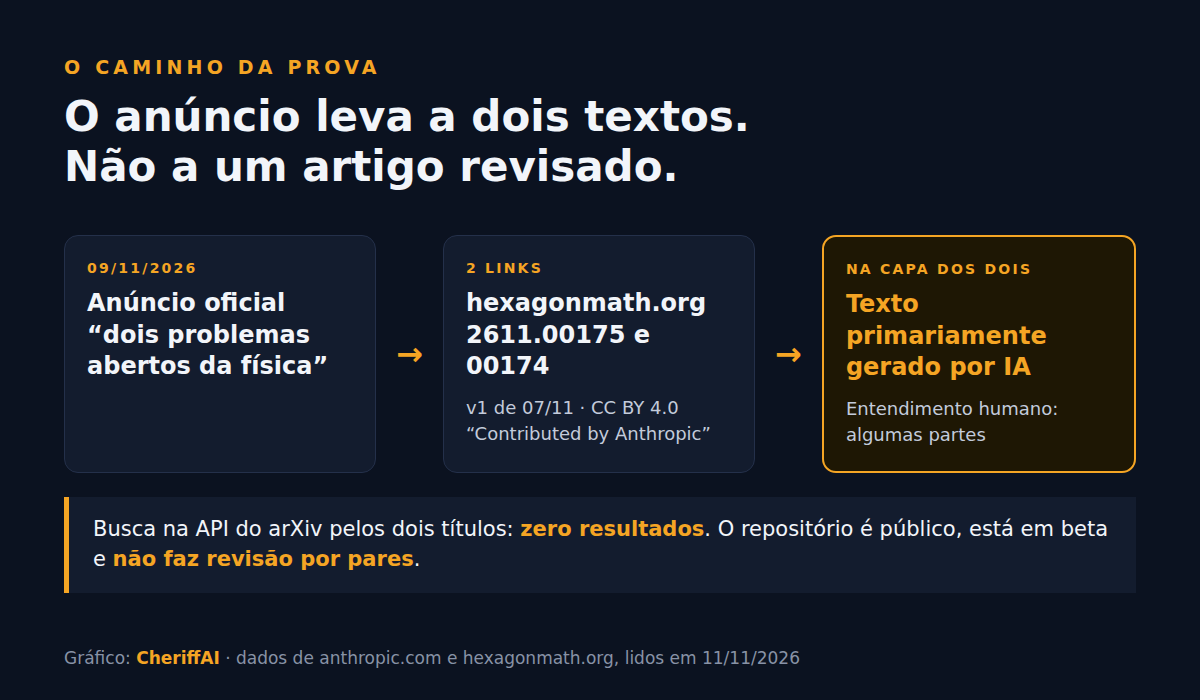
E o rastro leva a dois textos hospedados em hexagonmath.org, o 2611.00175 e o 2611.00174. Não são páginas do site da Anthropic: são dois artigos num repositório público, versão 1, datados de 7 de novembro. E no alto dos dois há duas etiquetas fixas: "Texto primariamente gerado por IA" e "Entendimento humano: algumas partes".
Isso não desmente o anúncio. Mas muda o que a palavra "resolvido" está cobrindo.
Onde ficam as duas provas
O anúncio não esconde os artigos — ele linka os dois, chamando-os de "preprints". O que ele não conta é o endereço, e o endereço é a parte interessante. As duas páginas trazem data, versão, licença (CC BY 4.0), a linha "Contributed by Anthropic" e a declaração de que o texto é primariamente gerado por IA, com entendimento humano em "algumas partes".
Os dois problemas, explicados sem física
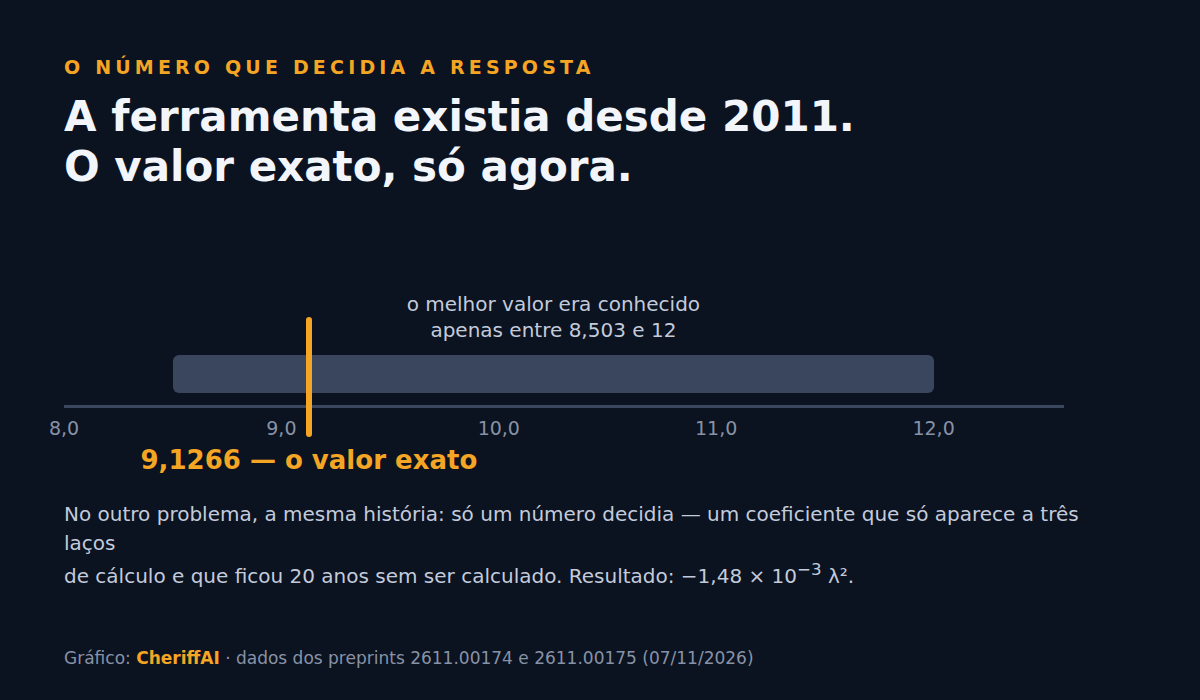
Problema 1 — o buraco negro que se forma de repente. O resultado clássico é de 1983, de Hawking e Page: nesses universos, quando a temperatura sobe, o buraco negro se forma de uma vez, como água que começa a ferver. O método deles, porém, só funcionava em universos grandes o bastante para a relatividade valer. Ficou a pergunta: e nos universos pequenos, onde só a descrição quântica serve? A conta para responder foi sugerida em 2003 e nunca foi terminada — o anúncio diz que era "laboriosa demais". Um único número decide a resposta: o sinal de um coeficiente que só aparece no terceiro laço de cálculo e que, segundo o próprio artigo, ninguém havia calculado nas duas décadas seguintes. O valor encontrado foi b = −1,48 × 10⁻³ λ², e a conclusão é que a transição também é abrupta ali.
Problema 2 — o limite exato de uma ferramenta. Há mais de 15 anos os físicos usam uma técnica para descartar teorias candidatas de gravidade quântica num universo simplificado. O melhor valor que essa técnica alcançava era conhecido apenas como uma faixa: algo entre 8,503 e 12. O artigo mostra o valor exato: Λ = 12π²/(π² + 4·arcsinh²1) ≈ 9,1266.
A parte que o anúncio não repete: quem fez
Os dois textos têm um campo chamado Provenance — de onde o resultado veio. Vale ler inteiro, porque é ali que a história fica precisa. No artigo do Hawking-Page:
"Um modelo interno de pesquisa da Claude, instigado por um físico, obteve o resultado apresentado aqui. O físico o conferiu contra vários casos especiais conhecidos. Um cálculo separado da Claude, com um método diferente, não incluído aqui, dá o mesmo resultado."
No artigo do limite exato:
"O resultado principal foi obtido de forma autônoma, primeiro, por um modelo interno de pesquisa da Claude. O Claude Opus 5.5, disponível publicamente, obteve depois o mesmo resultado de forma independente. A Claude então escreveu este artigo, seguindo orientação breve de um físico, que também conferiu todos os resultados principais."
Repare no que isso faz com a manchete. O anúncio diz "Fable 5.2 resolveu". O registro diz "um modelo interno de pesquisa da Claude" — que pode ser o Fable 5.2, mas não é a mesma afirmação, e o artigo não faz essa equivalência. E, num dos dois casos, quem confirmou foi o Opus 5.5, o modelo que qualquer pessoa com conta consegue chamar hoje.
Ou seja: o registro é mais cuidadoso que o anúncio. Ele diz quem fez, quem conferiu e o que ficou de fora ("não incluído aqui"). A diferença entre "a IA obteve o resultado" e "um humano verificou o resultado" está escrita, em vez de embutida na manchete.
O que é o Hexagon — e o que ele não é
O Hexagon se apresenta como um repositório para as ciências matemáticas e a ciência da computação teórica, administrado pela Hexagon Mathematics Foundation, em beta público. A página "sobre" explica por que ele existe: foi "criado em resposta às mudanças impressionantes que a inteligência artificial induziu no cenário da pesquisa matemática" e considera trabalhos "que o autor pode não querer, ou não conseguir, submeter a outros repositórios como o arXiv".
A mesma página diz, com todas as letras, o que ele não faz: "A Hexagon não realiza revisão por pares. Todo depósito é triado automaticamente e, durante o beta, também revisado por um moderador humano antes de aparecer; a aceitação não é um julgamento de correção, qualidade ou novidade." Quem deposita pode anexar informação suplementar sobre o uso de IA, incluindo prompts e transcrições das respostas do modelo.
E nenhum dos dois títulos está no arXiv: a busca na API pública, feita hoje pelos dois nomes, devolve zero resultados.
O outro resultado: o que daria para verificar de verdade
No mesmo anúncio há uma segunda frase forte: o modelo teria "formalizado a prova do Último Teorema de Fermat em 30 horas". Formalizar é traduzir uma prova para uma linguagem que o computador confere passo a passo. É o tipo de verificação mais forte que a matemática tem — e, em tese, o mais fácil de um terceiro repetir: mesmo software, mesmos arquivos, mesmo resultado.
O texto detalhado da própria Anthropic, publicado no mesmo dia, dá os números e as ressalvas: 1.000 agentes, 28,7 horas até o teorema final (o anúncio arredonda para 30), cada agente num sandbox sem acesso à internet, um classificador conferindo cada comando e cada edição de arquivo antes de rodar. E o texto chama a rodada de "experimento de brinquedo" — a expressão é deles. O líder do time encerra com a frase "o Último Teorema de Fermat está na main, conferido pelo checador oficial". Essa main é interna. O que foi publicado da rodada é o gráfico e o texto, não o código.
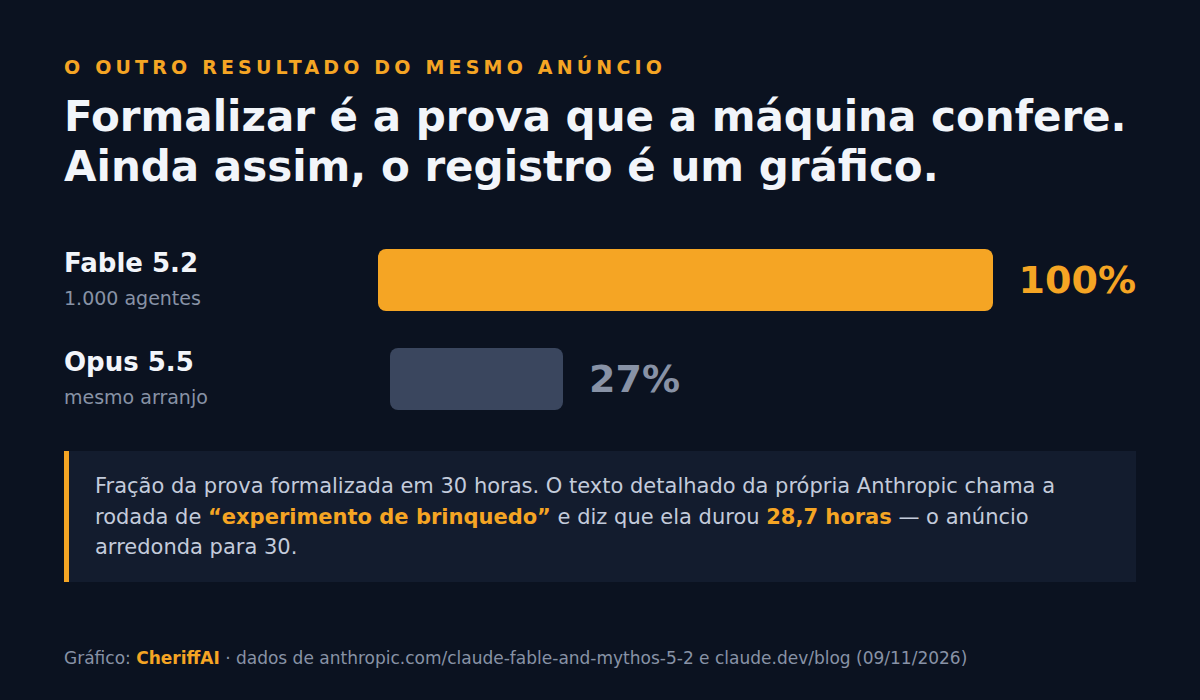
Nada disso é acusação. Formalizar Fermat em 28,7 horas com mil agentes coordenados por conta própria é um resultado de engenharia notável — e o texto detalhado é honesto ao ponto de dizer que os próprios agentes julgaram 47 dos 60 enunciados "inviáveis" no começo, e depois provaram quase todos. O ponto é outro: o resultado que seria o mais verificável dos três é justamente o que existe apenas como descrição.
Por que isso interessa a quem não é físico
Porque você vai ler "a IA resolveu" muitas vezes no próximo ano, em texto de fornecedor, em apresentação de evento e na sua própria caixa de entrada. A pergunta que separa uma afirmação de um resultado é sempre a mesma: qual é o rastro? Três conferências resolvem a maior parte dos casos:
- O resultado existe fora do anúncio? Aqui, sim: dois textos com data, versão e licença.
- O que o registro diz sobre quem fez e quem conferiu? Aqui: um físico conferiu casos especiais; e, num dos dois problemas, um modelo público chegou ao mesmo resultado de forma independente.
- Um terceiro consegue repetir? Problema 2: sim, com o Opus 5.5. Problema 1: parcialmente. Fermat: só com os dados internos.
Caso prático 1 — due diligence de fornecedor. Um banco recebe um fornecedor dizendo que a IA dele "resolveu" um problema de conformidade regulatória. O que pedir, nessa ordem: o documento, a versão, quem conferiu e se algum terceiro reproduziu. Se a única fonte é a página de marketing, é anúncio — e anúncio não passa em auditoria.
Caso prático 2 — o registro dentro da empresa. Você usa IA para achar um erro num modelo financeiro. O cálculo vai para o e-mail de alguém. Seis meses depois, ninguém sabe se aquilo saiu de uma pessoa ou de um modelo, nem qual versão respondeu. Anotar a origem no momento em que o resultado é criado custa trinta segundos e é a diferença entre fazer auditoria e fazer arqueologia.
Caso prático 3 — pesquisa com financiamento curto. Para um laboratório brasileiro, repetir um experimento é caro. Ler a nota de origem antes de tentar reproduzir economiza meses de trabalho — e custa zero. O texto do Hexagon é um bom modelo do que anotar: quem executou, quem verificou, com que método e o que não foi incluído.
O que isso muda
A conclusão não é "não confie". É que a palavra "resolvido" passou a cobrir duas coisas que antes eram a mesma: o resultado que existe e o resultado que foi aceito. O primeiro já pode ser produzido por uma máquina barata; o segundo continua exigindo gente disposta a conferir.
A Anthropic fez, nesse lançamento, algo melhor do que a média do setor: publicou a nota de origem, disse o que ficou de fora e deixou os textos com data e versão, com a etiqueta de IA na capa. O que falta é o passo seguinte — a conferência por quem não tem interesse no resultado. Enquanto esse passo não vem, a regra que a gente usa aqui é curta: número sem link é boato, e "a IA fez" sem nota de origem é marketing.
Fontes
- Anthropic — Introducing Claude Fable 5.2 and Claude Mythos 5.2 (09/11/2026)
- Hexagon — The Hawking-Page transition at weak coupling, v1 (07/11/2026)
- Hexagon — The spinless modular bootstrap at large central charge, v1 (07/11/2026)
- Hexagon — About: repositório em beta, sem revisão por pares (consultado em 11/11/2026)
- claude.dev — Safely scaling multi-agent teams with Claude Fable 5.2 (09/11/2026)
- arXiv API — busca pelos dois títulos: zero resultados (11/11/2026)
- Obsidian CheriffAI — nota de pesquisa cheriffai/ideas/ai-search-2026-11-11 (levantamento das fontes primárias)