
O que a Z.ai colocou no ar na segunda-feira
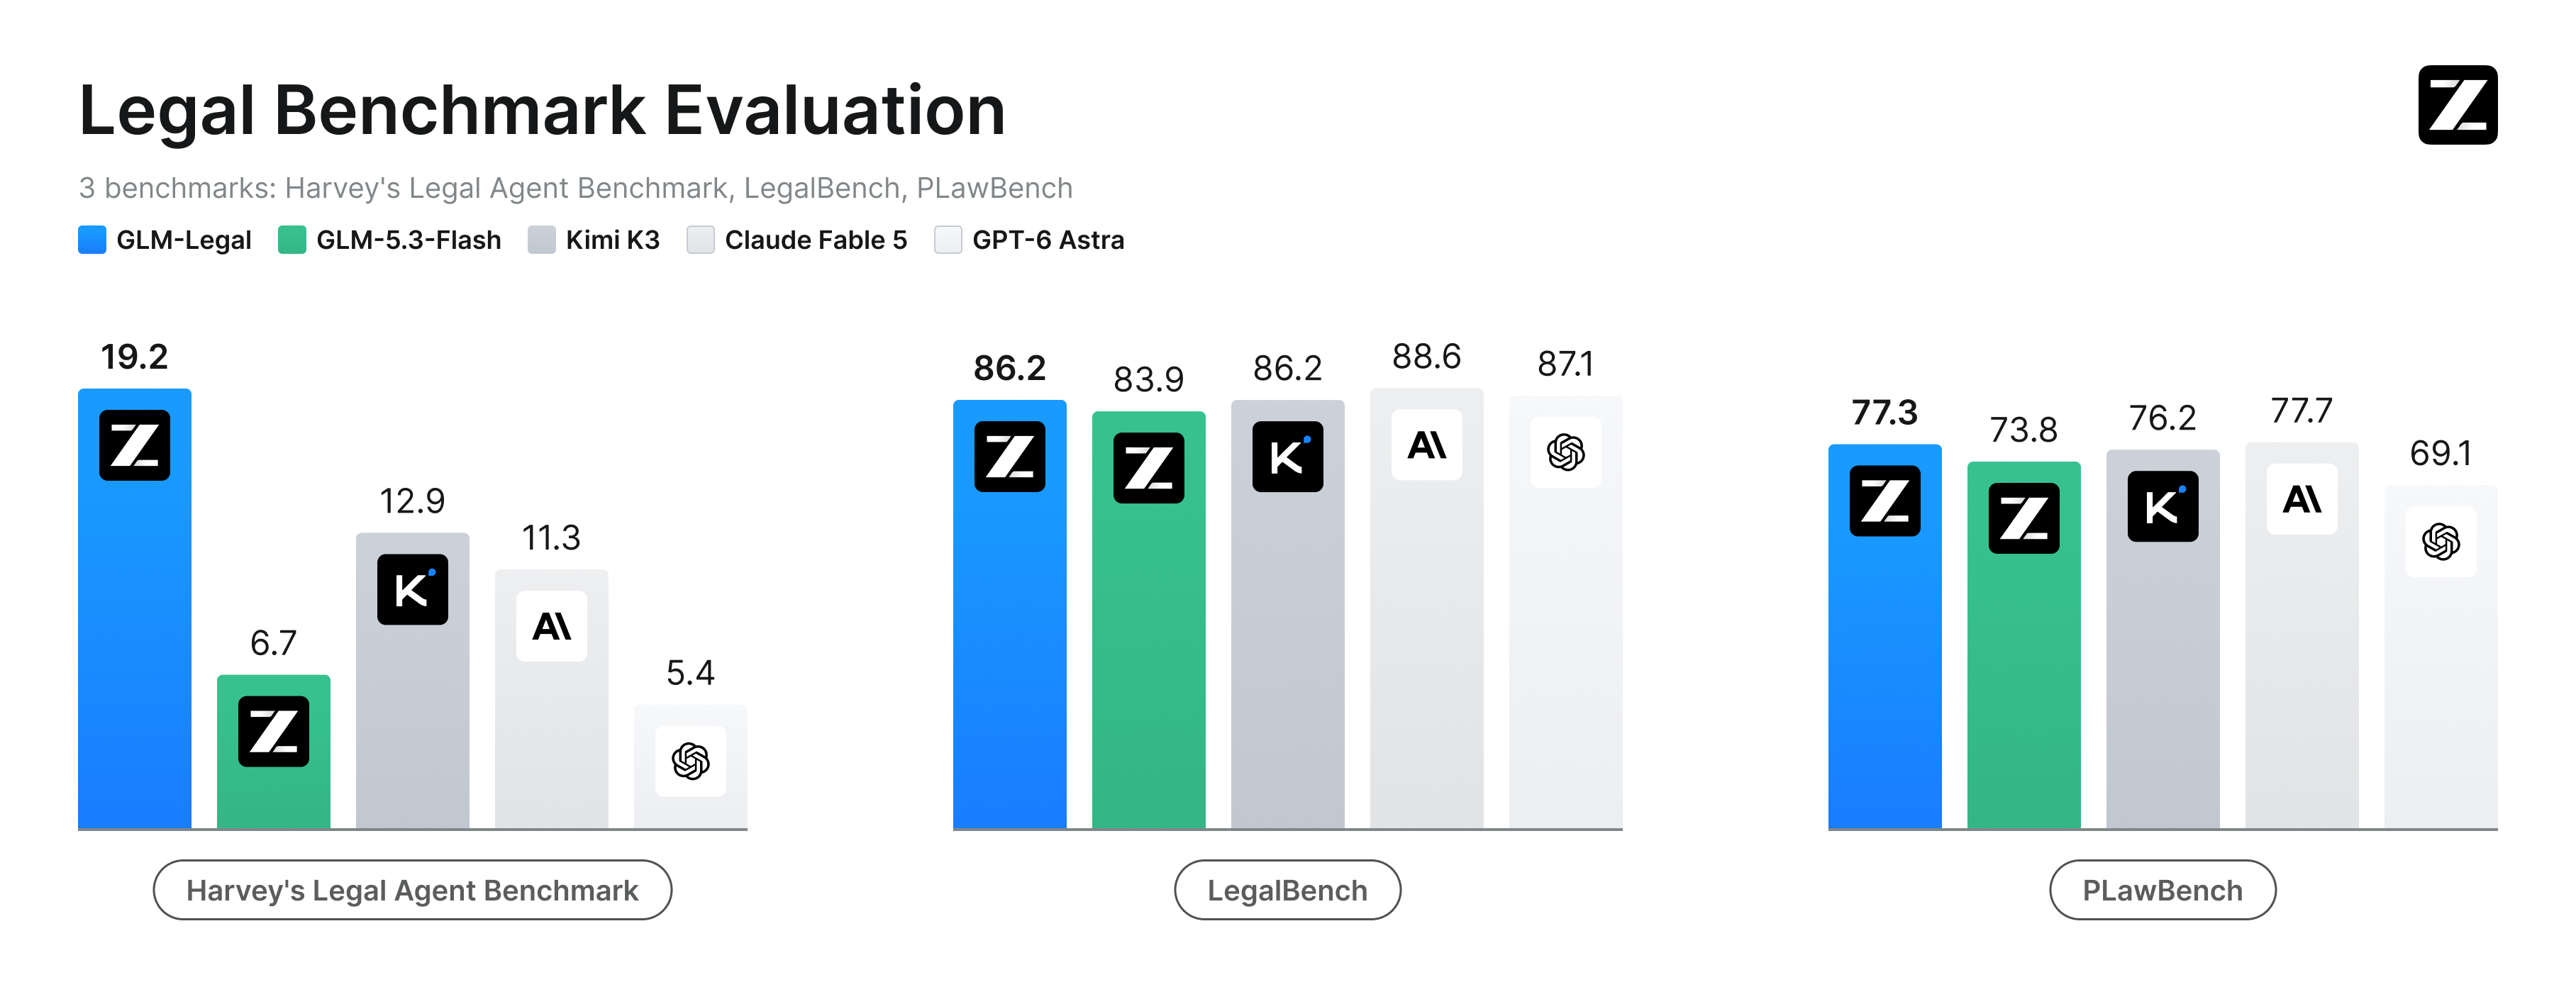
Na segunda-feira, 12 de outubro, a Z.ai — o laboratório chinês por trás da família GLM, também conhecido como Zhipu — abriu em beta um modelo que não sabe fazer quase nada além de direito. Ele se chama GLM-Legal, e o número que a empresa colocou na capa do anúncio é este: 19,2% das tarefas de um escritório de advocacia concluídas no Harvey's Legal Agent Benchmark, o teste mais duro do setor jurídico hoje.
Parece pouco. Não é. Esse benchmark é avaliado por regra de tudo-ou-nada: uma tarefa só conta como concluída se 100% dos critérios passarem — os fatos certos, as cláusulas certas, a análise defensável e o documento no formato pedido. É o teste que separa "escreveu um texto bonito sobre o contrato" de "entregou o trabalho pronto para um sócio assinar".
O modelo-base da Z.ai, o GLM-5.3-Flash, faz 6,7% nesse mesmo teste. O GLM-Legal faz 19,2%. São 12,5 pontos percentuais de diferença — ganhos com especialização, não com tamanho.
O que é, exatamente, um modelo especializado
Vale entender o que a Z.ai fez, porque é uma receita que vai se repetir em outras áreas.
O ponto de partida é o GLM-5.3-Flash, um modelo de 320 bilhões de parâmetros com apenas 18 bilhões ativos por resposta. Esse formato se chama mixture of experts e funciona como um condomínio de especialistas: o modelo não acorda todos os 320 bilhões de parâmetros para cada pergunta — ele chama só os 18 bilhões mais úteis para aquilo. Por isso é rápido e barato para o tamanho que tem. A outra característica é o contexto de 1 milhão de tokens, ou seja: dá para despejar milhares de páginas de processo de uma vez só.
A especialização veio em três etapas descritas no anúncio oficial. Primeiro, um treinamento intermediário com um volume muito maior de textos jurídicos. Depois, aprendizado por reforço em dezenas de milhares de ambientes jurídicos realistas — nos quais o próprio sistema que roda o agente (o harness, a parte que organiza tarefas, ferramentas e contexto) foi ajustado junto com o modelo, em ciclo. Por último, avaliações de advogados reais sendo convertidas em sinal de treinamento: o que o profissional reprovava virava erro a corrigir na próxima rodada.
Traduzindo: não é um chatbot genérico com um manual de direito colado na frente. A especialização está nos pesos — o modelo raciocina de outro jeito sobre um contrato, em vez de apenas buscar o trecho relevante e resumir.
O anúncio diz 19,2%. A medição independente diz 7º lugar.
Aqui começa a parte que interessa. O número do anúncio foi conferido por fora: a Vals AI, avaliadora independente que roda os mesmos testes do Harvey com metodologia própria, mediu o GLM-Legal em 12/10 e publicou três resultados:
- 19,17% no Harvey LAB — 7º lugar entre 79 sistemas, ao custo de US$ 0,15 por tarefa (o mais barato de todo o top 10);
- 86,24% no LegalBench — 14º lugar entre 150 modelos;
- 41,83% no Legal Research Bench — 24º entre 78.
Ou seja: o salto de 12,5 pontos sobre o modelo-base é real e reproduzível — o que já é mais do que a maioria dos anúncios de benchmark pode dizer. Mas "7º lugar" tem uma consequência que o gráfico do anúncio esconde: existem seis modelos à frente dele no ranking, e nenhum dos seis aparece no material de lançamento. O gráfico mostra GLM-Legal, GLM-5.3-Flash, Kimi K3 (12,9%), Claude Fable 5 (11,3%) e GPT-6 Astra (5,4%) — todos abaixo. Ficam de fora três variantes do Muse Spark (25,4%, 23,8% e 22,9%), o Wonder Full (21,7%), o Muse Spark 1.1 (20,0%) e o Gemini 4 Argon (19,6%), que estão acima.
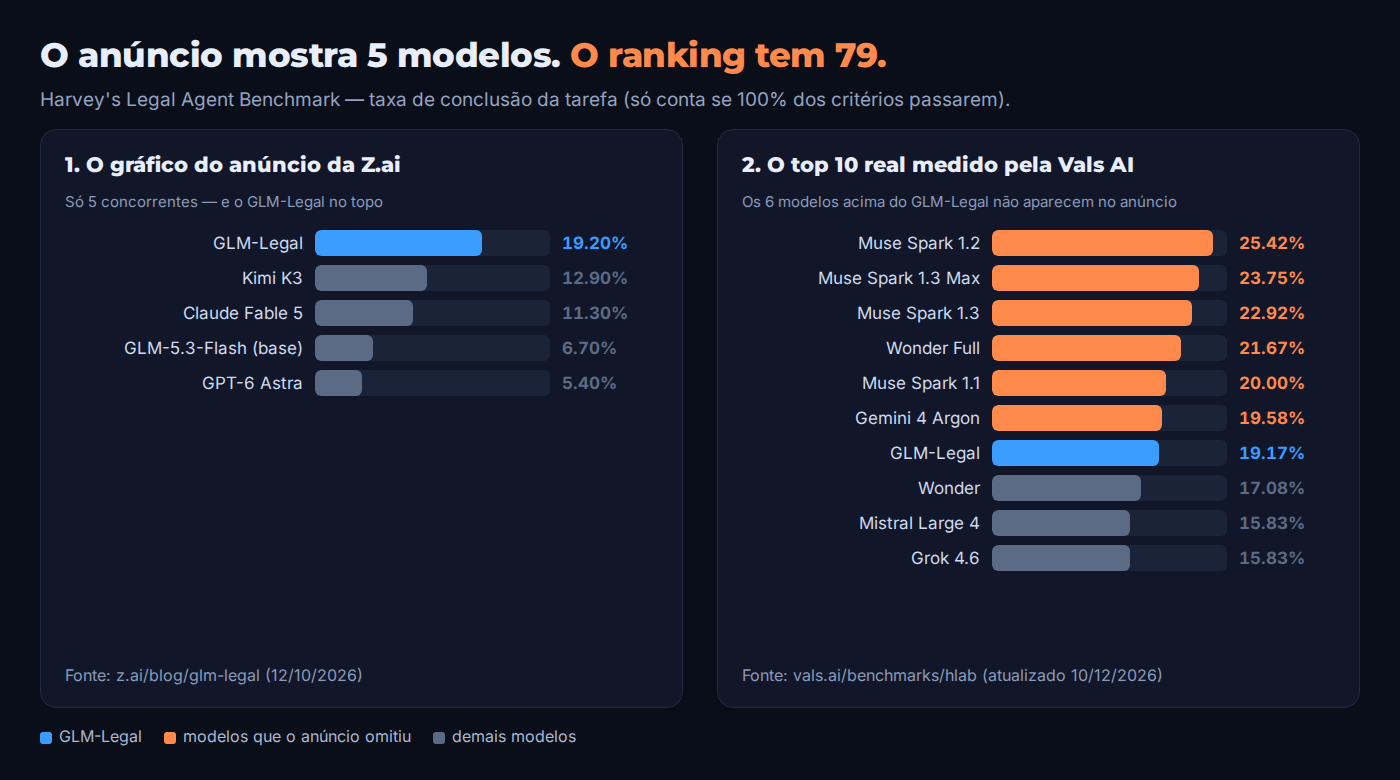
Não é fraude — os cinco números do gráfico batem com a medição independente. É curadoria de comparação: escolher os concorrentes que fazem o próprio número parecer liderança. A regra prática continua a mesma: quando o gráfico do fornecedor não inclui quem está na frente, o ranking independente é a única fonte que importa.
O placar real, com preço
Este é o top 10 do Harvey's Legal Agent Benchmark na medição da Vals (atualizada em 12/10/2026). A coluna de custo é por tarefa avaliada — e é aí que a conversa muda de figura.
| # | Modelo | Tarefas concluídas | Custo por tarefa | Tempo por tarefa |
|---|---|---|---|---|
| 1 | Muse Spark 1.2 | 25,42% | US$ 2,09 | 24 min |
| 2 | Muse Spark 1.3 Max | 23,75% | US$ 2,26 | 15 min |
| 3 | Muse Spark 1.3 | 22,92% | US$ 2,76 | 17 min |
| 4 | Wonder Full | 21,67% | US$ 5,41 | 53 min |
| 5 | Muse Spark 1.1 | 20,00% | US$ 0,80 | 12 min |
| 6 | Gemini 4 Argon | 19,58% | US$ 10,55 | 44 min |
| 7 | GLM-Legal | 19,17% | US$ 0,15 | 1 h 12 min |
| 8 | Wonder | 17,08% | US$ 7,08 | 23 min |
| 9 | Mistral Large 4 | 15,83% | US$ 4,18 | 39 min |
| 10 | Grok 4.6 | 15,83% | US$ 4,01 | 45 min |
Dois detalhes de método que evitam leitura errada. Primeiro: a Vals usa dois juízes de IA (GPT 5.5 e Claude Sonnet 4.6) e exige unanimidade de critérios. Segundo: os modelos grandes acertam cerca de 90% dos critérios individuais — o que derruba a nota é a exigência de acertar todos de uma vez. É por isso que 19% é um resultado forte e, ao mesmo tempo, significa que quatro de cada cinco tarefas completas ainda falham.
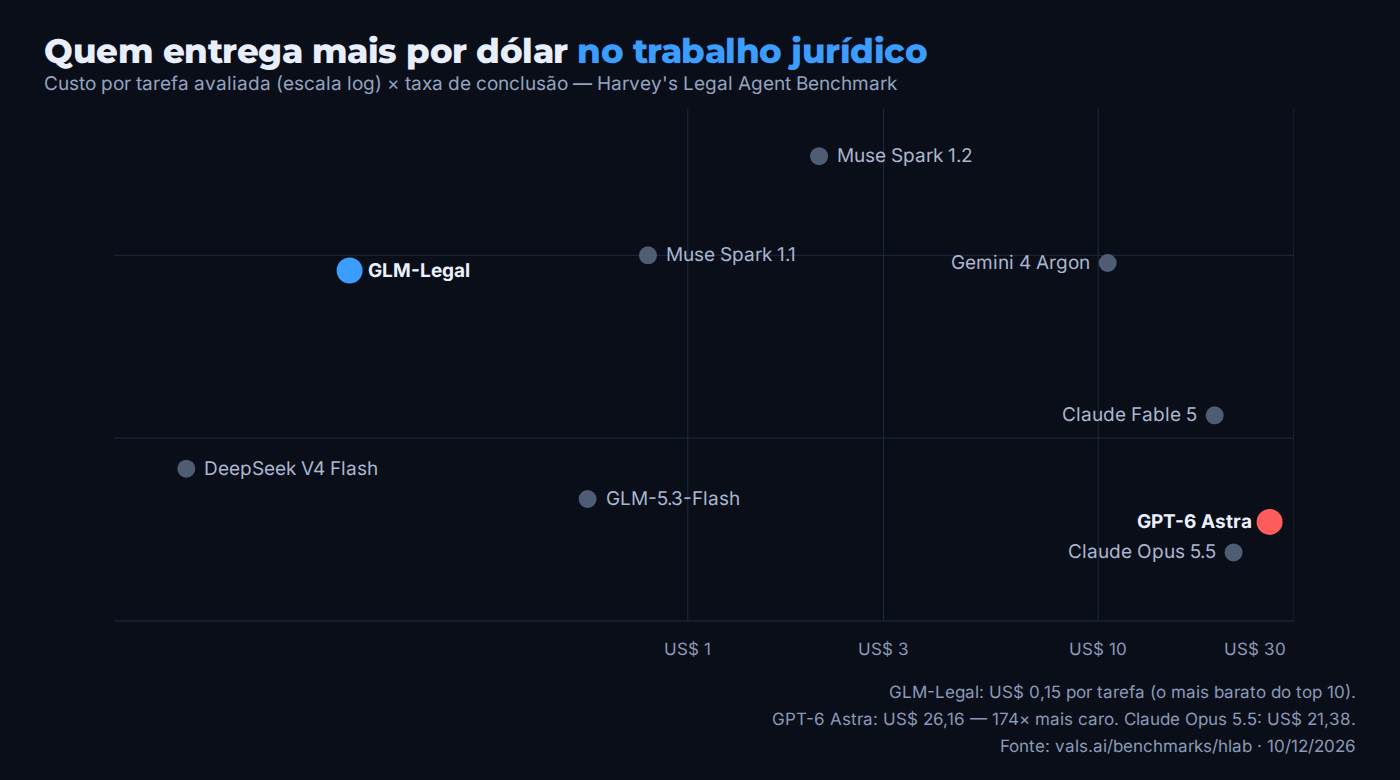
A conta que interessa: US$ 0,15 contra US$ 26,16
Compare as linhas 7 e 6, e depois a linha 34 do ranking completo: o GLM-Legal custa US$ 0,15 por tarefa, o Gemini 4 Argon custa US$ 10,55 (70 vezes mais) e o GPT-6 Astra, US$ 26,16 (174 vezes mais) — para fazer 5,42%, um quarto do que o modelo jurídico entrega.
O anúncio transforma isso em "desempenho de fronteira sem preço de fronteira", e a frase é defensável: nenhum modelo no top 10 chega perto desse custo. Os dois contrapesos honestos são que o GLM-Legal é o mais lento do top 10 — 1 hora e 12 minutos por tarefa, contra 24 minutos do líder — e que barato não é sinônimo de confiável: num contrato, errar custa o mesmo, tendo o modelo cobrado centavos ou dezenas de dólares.
Dois casos práticos que o próprio anúncio mostra
A parte mais útil do material da Z.ai são três exemplos lado a lado, comparando o que o modelo-base respondia e o que o GLM-Legal respondeu. Dois deles mostram bem a diferença entre "resumir o documento" e "trabalhar o caso".
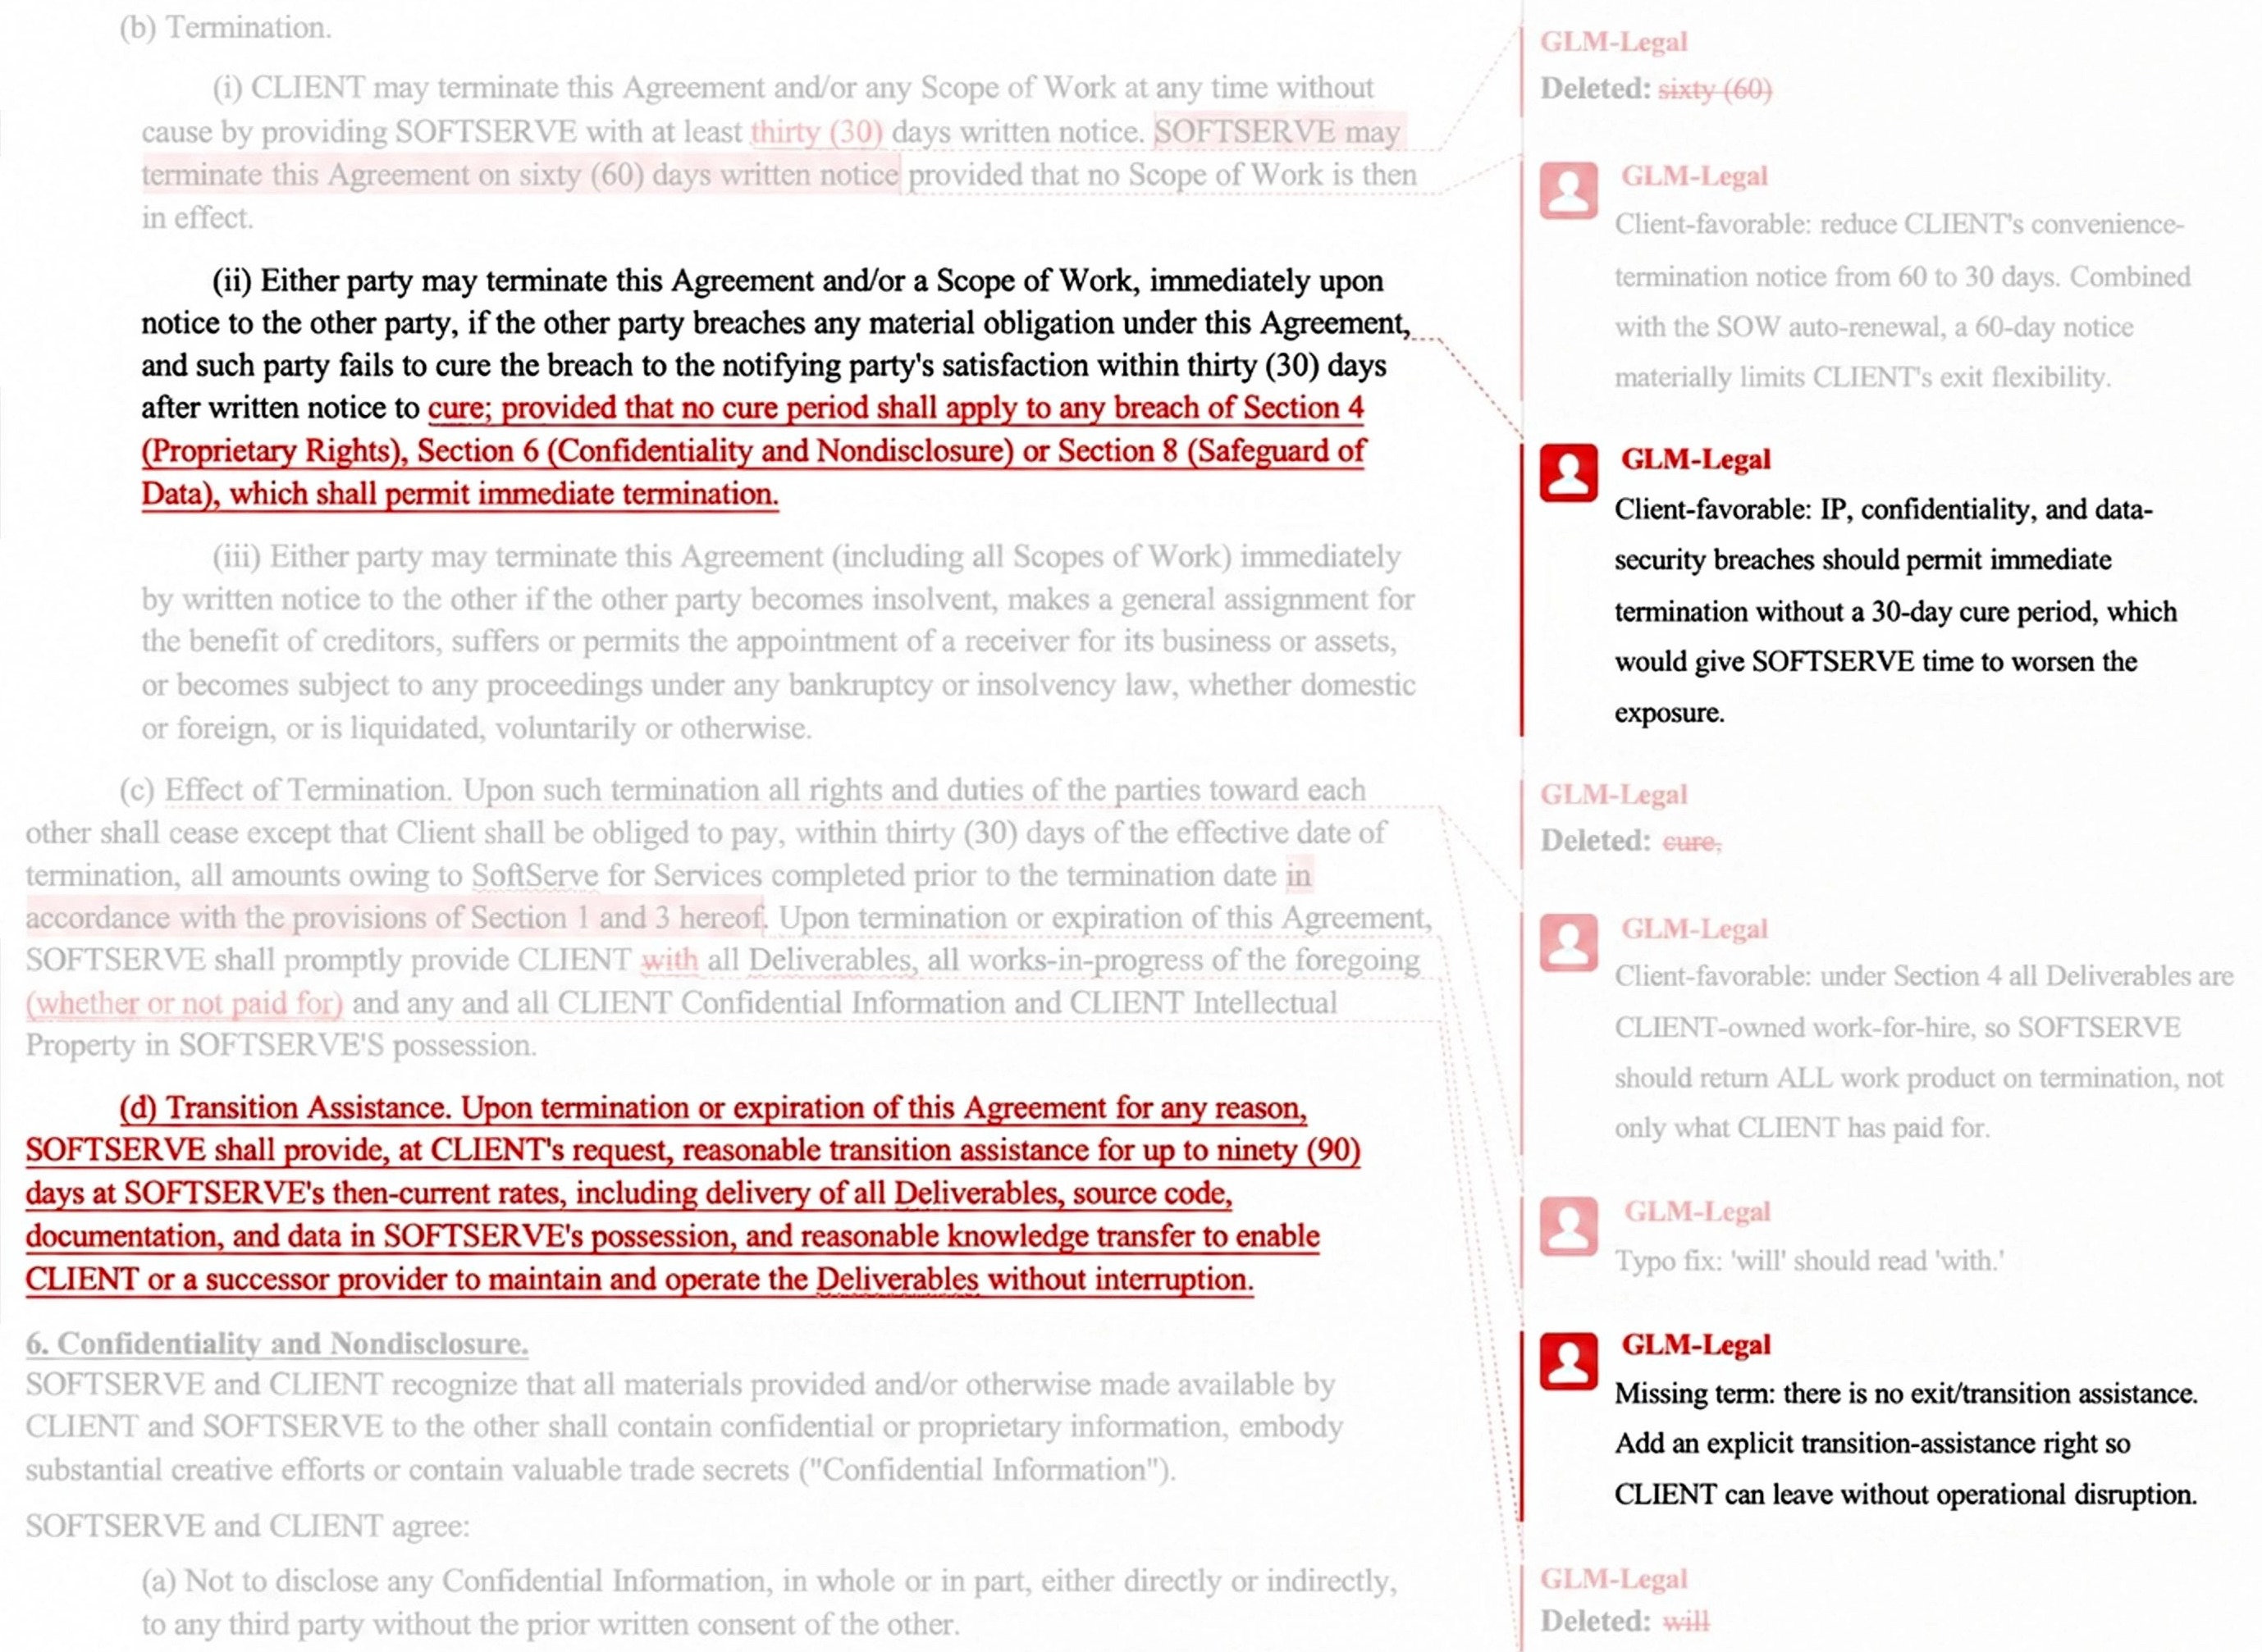
1. Revisão de contrato de software. O cliente está trocando de fornecedor e quer uma cláusula de saída que proteja a migração. O modelo genérico respondeu o óbvio: encurtar o aviso prévio e pedir a devolução dos dados. O GLM-Legal escreveu termos específicos — reduzir de 60 para 30 dias o aviso de conveniência, remover o prazo de cura para quebra de propriedade intelectual, confidencialidade ou segurança de dados (permitindo rescisão imediata), exigir a devolução de todo o material produzido, mesmo o ainda não pago, e incluir até 90 dias de assistência de transição cobrindo código-fonte, documentação e transferência de conhecimento. E entregou como documento do Word com marcas de revisão, pronto para negociar — não como texto solto num chat.
2. Análise de provas em uma disputa. Quarenta documentos de um projeto de software, e a pergunta é se os relatórios de andamento do fornecedor foram enganosos. O modelo genérico listou a contradição. O GLM-Legal construiu a tese: cruzou o relatório de 30 de setembro ("no prazo, 60% concluído") com o alerta interno de 8 de setembro de que o marco não poderia ser cumprido com honestidade e com o registro interno de ~41%, ligou isso à instrução de esconder o risco e continuar faturando, e ainda citou as cláusulas do contrato segundo as quais pagar não renuncia a direitos e as garantias sobrevivem ao pagamento. Fechou dizendo o que faltava provar antes de concluir.
O terceiro exemplo é um plano de conformidade para lançamento em Cingapura, Malásia e Indonésia: em vez de "publique um aviso de privacidade", saiu uma lista priorizada com referência legal por país (lei de proteção de dados de Cingapura, seção 26; da Malásia, seção 129; da Indonésia, artigos 55 e 56) e a recomendação de consentimento com adesão explícita onde exigido.
O que o anúncio não conta
- Os pesos do modelo jurídico não foram publicados. O modelo-base, GLM-5.3-Flash, é aberto e pode ser baixado; a variante jurídica não é — o acesso é por candidatura, em beta. Curiosamente, a ficha do GLM-Legal no catálogo da Vals o descreve como open-weight, rótulo que confunde: aberto é o que se pode baixar, e isso ninguém pode.
- Não há preço de tabela nem detalhamento de tratamento de dados. O anúncio não diz quanto vai custar depois do beta nem como (e por quanto tempo) os documentos do cliente ficam guardados — a pergunta mais séria para qualquer escritório.
- O próprio benchmark está sob crítica. Em 10 de outubro foi aberto um relato no repositório público do Harvey LAB apontando rubricas que parecem excluir casos legítimos — e a discussão no Hacker News tem advogados dizendo que 20% de conclusão não impressiona quem litiga, porque a prática é feita de casos novos, não de repetição.
Nada disso anula o resultado. Muda o que ele é: um primeiro passo muito mais barato, não um advogado. Um modelo que falha quatro de cinco tarefas completas serve para triagem, minuta e segunda leitura — com alguém responsável assinando embaixo.
Por que isso interessa a quem advoga no Brasil
A advocacia brasileira já usa IA em escala. Segundo o levantamento Impacto da IA Generativa no Direito 2026, citado pelo Jornal da Advocacia da OAB-SP, 77% dos advogados usam IA ao menos uma vez por semana — eram 55% em 2025.
Do lado institucional, o Conselho Federal da OAB lançou em 15 de junho de 2026 o Plano Nacional de Integração da Inteligência Artificial na Advocacia, estruturado em cinco eixos (governança, capacitação, modernização, defesa das prerrogativas e inclusão tecnológica). Na governança, a OAB vai consolidar as recomendações existentes num Código de Boas Práticas de IA na Advocacia, atualizado pelo Observatório Nacional de Cibersegurança, IA e Proteção de Dados — e o próprio anúncio do plano cita entre seus objetivos preservar o sigilo profissional, a privacidade dos dados dos clientes e a autonomia da advocacia.
Esse é o ponto em que a notícia chinesa encontra o escritório brasileiro. Se o modelo não pode ser baixado e os documentos do cliente vão para um servidor fora do país, o ganho de custo precisa ser pesado contra sigilo e LGPD — e é uma decisão que ninguém deve tomar só olhando o gráfico do anúncio. Ao mesmo tempo, a receita está na mesa: o modelo-base é aberto, custa US$ 0,075 por milhão de tokens de entrada e a Z.ai mostrou que dá para especializar. Um escritório com acervo próprio de peças e contratos tem um caminho concreto para treinar o seu especialista — e, se fizer isso, que meça como a Vals mediu, não como o anúncio mediu.
O número de capa é bom: 19,2% das tarefas e US$ 0,15 cada uma. Os outros três números — 7º de 79, seis modelos à frente e 1 hora e 12 minutos por tarefa — não cabem na capa. Cabem aqui.
Fontes
- Z.ai — GLM-Legal: Advancing Agentic Legal Intelligence (12/10/2026)
- Vals AI — ficha do GLM Legal: 7º de 79 no Harvey LAB, 14º de 150 no LegalBench, 24º de 78 no Legal Research Bench (12/10/2026)
- Vals AI — Harvey's Legal Agent Benchmark, leaderboard completo de 79 sistemas com custo por tarefa e metodologia dos dois juízes (atualizado em 12/10/2026)
- GitHub — harvey-labs, issue #191: relato de rubrica problemática no benchmark (10/10/2026)
- Hacker News — discussão sobre o GLM-Legal com críticas de advogados ao benchmark (12/10/2026)
- OAB — CFOAB lança Plano Nacional de Integração da IA na Advocacia (15/06/2026)
- OAB-SP, Jornal da Advocacia — três em cada quatro advogados usam IA no trabalho (26/03/2026)
- AI Daily Post — GLM-Legal Hits 19.17% on Harvey Legal Benchmark (13/10/2026)
- IA en un minuto — Z.ai unveils GLM-Legal, em beta e por candidatura (12/10/2026)