
O que a Anthropic anunciou no dia 23 de setembro
Em 23 de setembro de 2026, a Anthropic publicou em seu blog um texto com um título que parece exagero de marketing: "Claude descobre um novo sistema enzimático com repetições semelhantes às do CRISPR". Não é marketing. É um preprint (estudo ainda não revisado por pares) com números concretos, e os números são o mais interessante da história.
Cerca de 950 agentes de IA — instâncias do Claude Code trabalhando em conjunto — passaram 21 horas e meia lendo sequências de DNA e consumiram 215,6 milhões de tokens. No fim, entregaram 19 relatórios. Um deles descrevia um sistema biológico que ninguém havia descrito antes, batizado de ART (de array-associated reverse transcriptase, ou transcriptase reversa associada a um arranjo de repetições).
Uma observação importante antes de qualquer entusiasmo: ninguém sabe para que esse sistema serve. A própria Anthropic escreve isso no texto. E é exatamente por isso que a história vale um post — é o primeiro capítulo honesto de uma série sobre IA fazendo ciência de verdade.
Por que ler DNA é o gargalo da biologia hoje
Imagine uma biblioteca que dobra de tamanho a cada quatro anos e cujos livros são escritos em um idioma que ninguém terminou de aprender. Esses são os bancos públicos de sequências genéticas hoje: bilhões de proteínas catalogadas, a maior parte nunca examinada por um ser humano.
O método tradicional de garimpar esse material é chamado de genome mining. Você monta um programa de computador que procura por padrões conhecidos — "me traga todas as proteínas parecidas com esta" — e depois classifica os resultados por critérios definidos antes de olhar os dados. O problema é óbvio: um pipeline só encontra aquilo que alguém já imaginou procurar. Se aparecer algo estranho que não cabe em nenhuma categoria, ele passa batido.
É por isso que, no fim de todo garimpo automatizado, existe sempre um especialista humano revisando à mão, olhando as sequências uma por uma. Esse passo humano é o gargalo: não escala com o volume de dados. Foi contra esse gargalo que a Anthropic apontou os agentes.
Como funciona: agentes que dividem o trabalho como uma equipe de laboratório
A Anthropic montou o que chama de harness — um software que organiza vários agentes trabalhando ao mesmo tempo, cada um com um papel. É quase uma reprodução de um grupo de pesquisa:
- Workers (trabalhadores): propõem um plano de análise e executam, rodando código e consultando bancos de dados;
- Supervisors (supervisores): revisam o plano e o resultado, e podem abrir novas tarefas a partir do que foi observado;
- Curators (curadores): registram tudo numa base de conhecimento compartilhada;
- Editors (editores): revisam os relatórios finais.
O detalhe crucial: 98 das 119 tarefas nasceram de observações feitas durante o próprio trabalho, não do roteiro original. Ou seja, a campanha se estendeu sozinha conforme os achados apareciam. Foi em uma dessas tarefas extras que a coisa interessante aconteceu.
A cena que interessa: um agente estranhando o que leu
O roteiro inicial pedia transcriptases reversas — enzimas que copiam RNA de volta para DNA — que estivessem associadas a genes parceiros ainda não descritos. Trabalhando nisso, um agente resolveu checar o DNA ao redor de uma dessas enzimas em um bacteriófago (um vírus que infecta bactérias) e escreveu, no seu registro de raciocínio, algo que soa bastante humano:
"O flanco é espetacular: consigo ver a olho nu um arranjo de repetições em tandem (...) isso parece um mini-arranjo do tipo CRISPR ou uma região de repetição do tipo retron."
Traduzindo: o agente percebeu que uma sequência de letrinhas — CATGTGTATCGCATGTT — aparecia repetida dezenas de vezes, separada por espaçadores, do lado de uma enzima que copia RNA para DNA. Essa combinação (a enzima + o arranjo de repetições + uma proteína parceira de função desconhecida) é o que define a família ART. O arranjo tem unidades de cerca de 200 nucleotídeos.
Vale notar o que houve aqui. Não foi um buscador programado para achar repetições. Foi um modelo de linguagem lendo DNA bruto como se fosse texto e achando estranho — a mesma reação que um pesquisador humano tem quando algo não fecha. É isso que a Anthropic chama, no paper, de "visão genômica".
Os números: acertos, erros e o que foi descartado
Aqui está o motivo pelo qual o trabalho merece crédito, e não só hype. A campanha produziu muito lixo também, e a Anthropic mostra o lixo.
| Etapa da campanha | Número |
|---|---|
| Agrupamentos de transcriptases reversas varridos | ~200.000 |
| Classes distintas de RT identificadas | 9 |
| Loci amostrados e famílias candidatas avaliadas | ~11.000 loci / 3.564 famílias |
| Famílias que passaram nos critérios e viraram investigação dedicada | 17 |
| Confirmadas como associação realmente inédita | 3 |
| Descartadas (artefato de anotação, sistema já conhecido, vizinho de bairro) | 14 |
| Tarefas executadas / sessões de agente | 119 / 949 |
| Tempo de parede / horas de agente / tokens | 21,5 h / 77 h / 215,6 milhões |
Ler essa tabela com atenção muda o tom do anúncio. De 17 famílias promissoras, 14 foram jogadas fora — sobraram três associações realmente novas. E o relatório do ART não foi o campeão: ficou em terceiro lugar num torneio em que um modelo (o próprio Mythos 5 da Anthropic) comparou os 19 relatórios aos pares, em 342 confrontos, dando notas de impacto, novidade, solidez e aplicabilidade.
O teste que separa os modelos — e a pista sobre o que importa
Para não depender de uma história bonita, a Anthropic transformou o achado em um teste padronizado. Sete modelos Claude receberam as mesmas sequências do ART, em cinco níveis de informação (só no contexto, ou em arquivos com ferramentas de análise) e 100 tentativas cada, num total de 3.500 rodadas julgadas por uma rubrica de dez características.
O resultado tem duas leituras. A primeira: existe um degrau claro de capacidade — os quatro modelos mais fortes (Opus 5.5, Mythos 5.1, Mythos 5 e Opus 5) encontraram bem mais características do que os três seguintes (Opus 4.6, Opus 4.8 e Sonnet 5). A segunda é a mais interessante para quem usa IA no trabalho: acertar dependia de quantos nucleotídeos contíguos de DNA cabiam na janela do modelo. Com menos de 200 nucleotídeos seguidos no contexto, quase nenhuma rodada reconheceu o arranjo; com trechos longos, o reconhecimento disparava.
Tem uma consequência prática nisso. Não adianta dar ao modelo uma ferramenta que resuma o dado antes — é preciso deixá-lo ler o dado original, na íntegra, para que ele tenha a chance de estranhar. E não é metáfora: os autores mediram sinais internos do modelo que literalmente disparam quando a sequência repetida passa pela leitura. Quando eles embaralharam as cópias da repetição, os sinais se calaram, e o modelo não a reconheceu mais.
A parte honesta: o que a Anthropic ainda não sabe
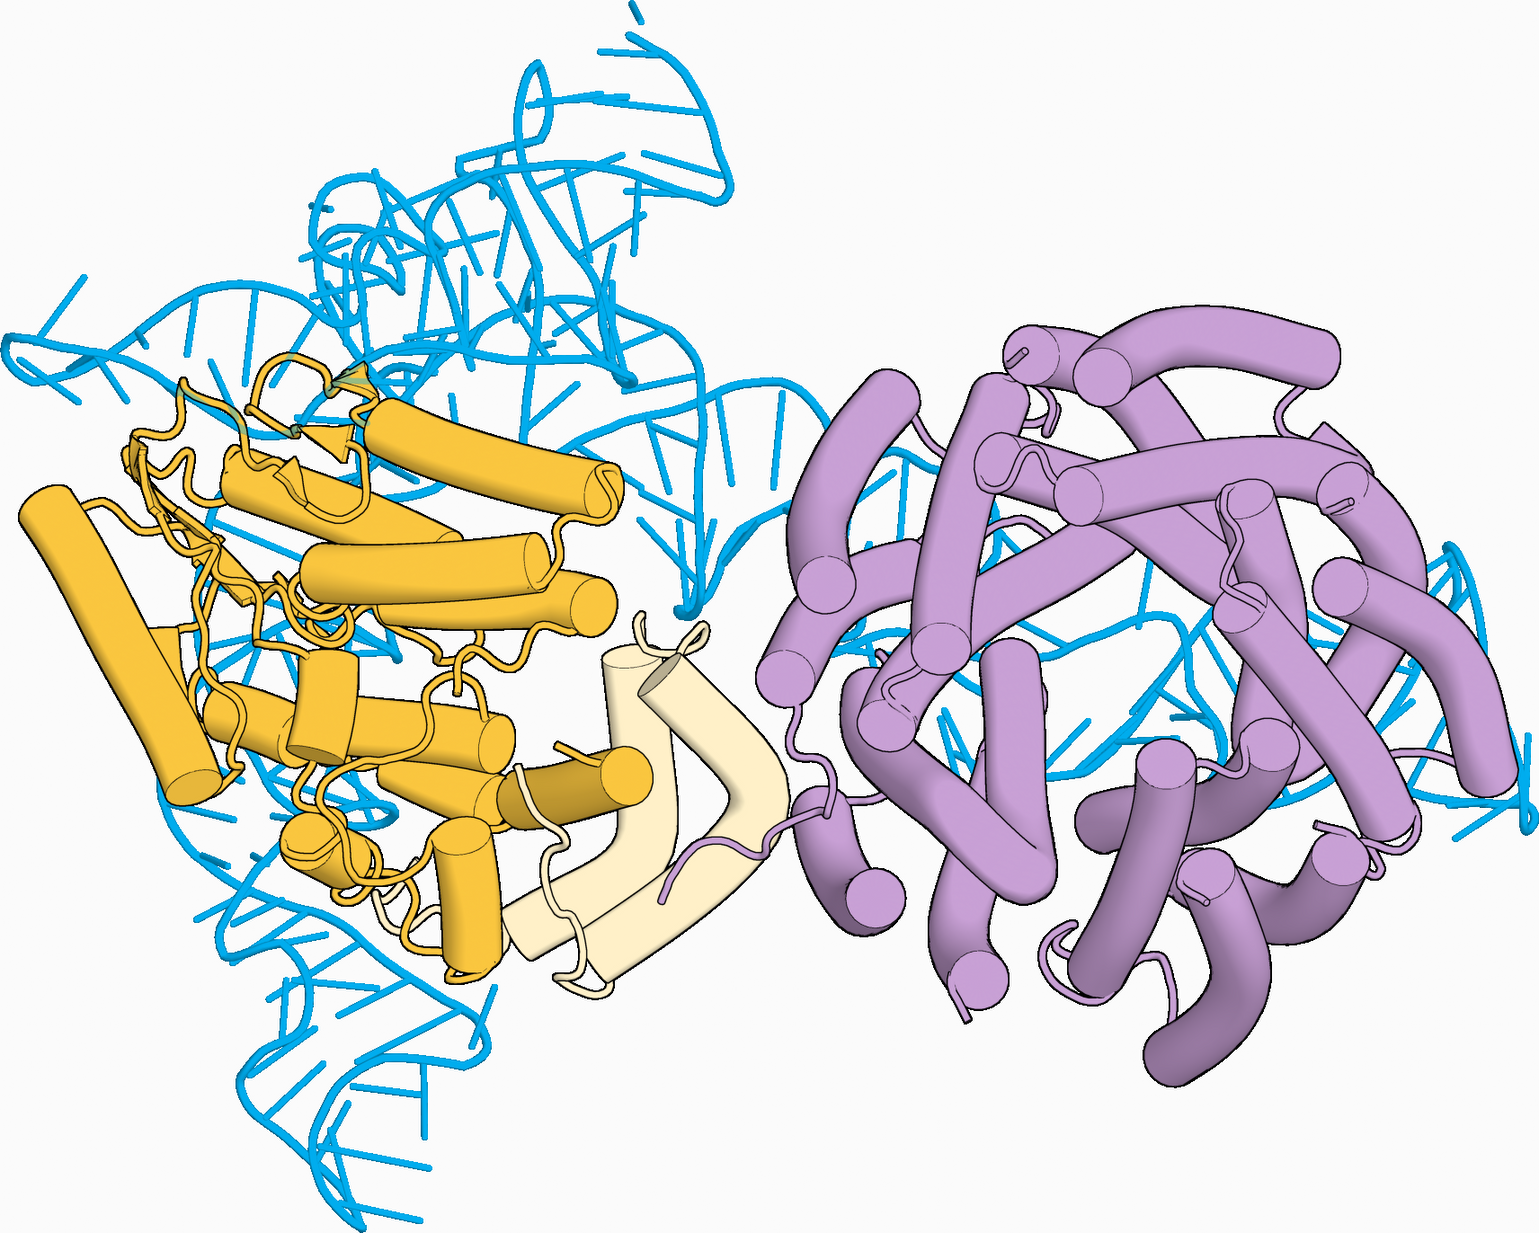
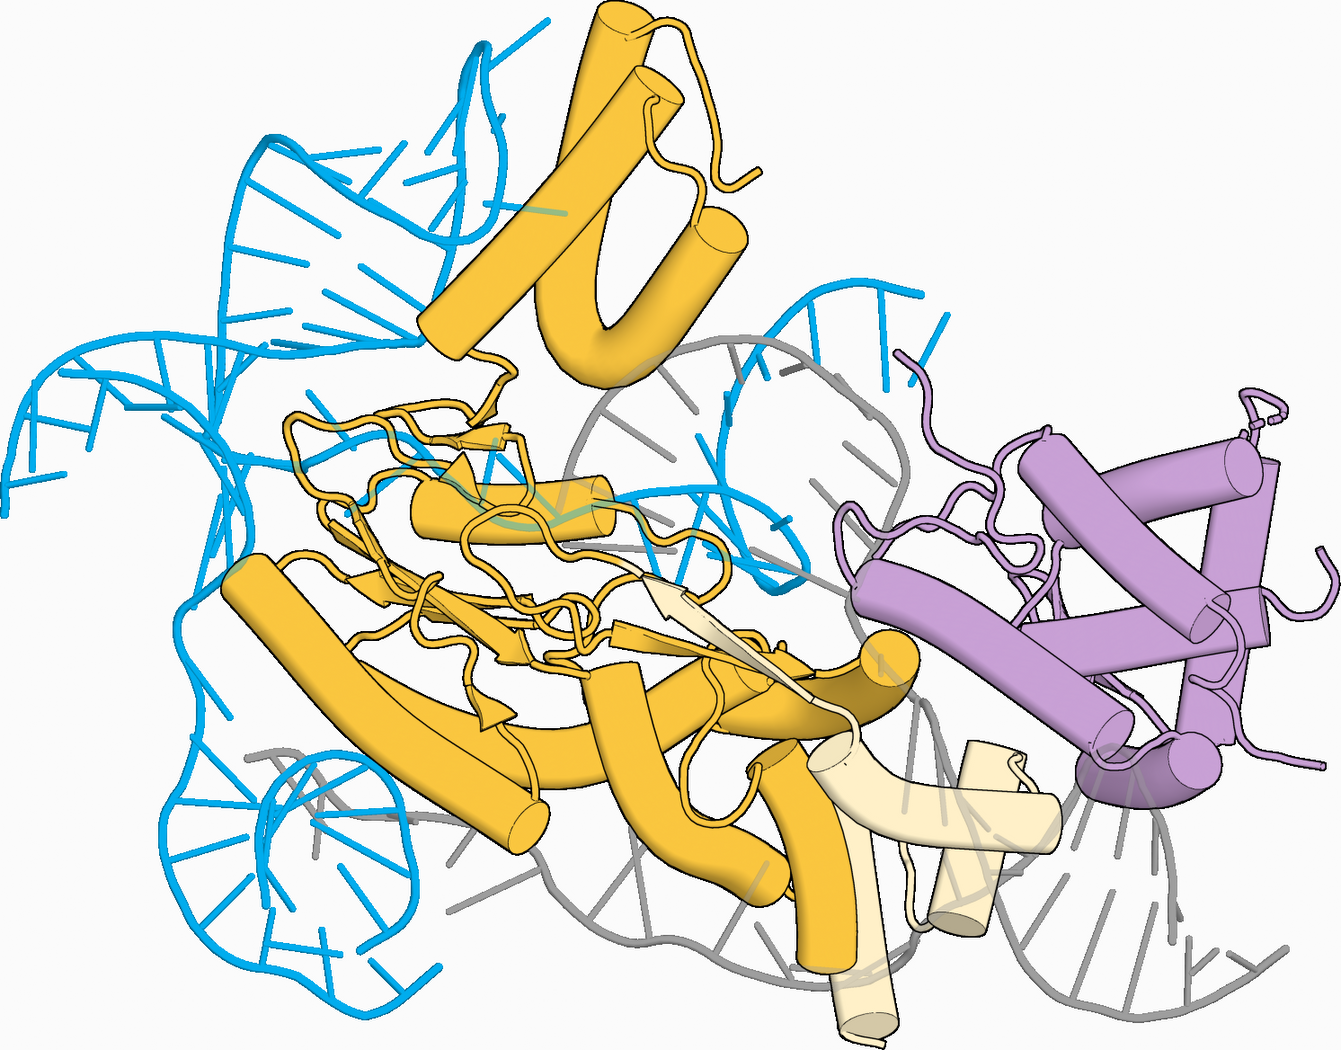
O sistema ART não foi provado funcional. O que existe até agora é o primeiro passo de bancada: os pesquisadores verificaram que o arranjo é transcrito (lido e copiado em RNA) e que isso aparece em abundância durante a infecção — chega a até 8% dos RNAs do vírus 15 minutos depois da infecção, o que faz desses pedaços um dos produtos mais abundantes do fago. Também viram RNAs curtos e discretos aparecendo quando o sistema foi movido para outra bactéria (a E. coli), no laboratório.
Até aí, tudo o que se sabe. O preprint diz, com todas as letras, que não foi demonstrado que a enzima é ativa, que os RNAs sejam seus substratos, que a enzima interaja com a proteína parceira ou que o sistema sirva para alguma coisa para o vírus.
Do lado de fora, as críticas vieram rápidas e não são hostis à IA — são sobre o quanto o achado é novo. Lucas Harrington, que fez doutorado no laboratório de Jennifer Doudna e cofundou a Mammoth Biosciences, lembrou que garimpar vizinhanças de genes para achar sistemas biológicos é prática de décadas, que transcriptases reversas ao lado de arranjos tipo CRISPR são conhecidas desde 2008 e que há trabalhos que descobrem e validam dezenas de sistemas novos em um único estudo. A frase dele resume o ponto: "encontrar um agrupamento esquisito de genes e repetições costuma ser a parte fácil; a difícil é descobrir o que o sistema faz".
Do outro lado, Feng Zhang, do MIT e do Broad Institute, leu o preprint e disse que é "um exemplo empolgante de como agentes de IA podem contribuir para descobertas biológicas" — e que o padrão merece investigação. A Anthropic também reconhece que o crédito pela descoberta da própria enzima não é dela: o locus onde o ART foi encontrado já tinha sido descrito antes, com a enzima anotada, mas sem ninguém notar nem as repetições nem a proteína parceira.
Por que isso continua importando (mesmo se a enzima não servir para nada)
Se o ART virar apenas uma nota de rodapé da biologia, a parte que sobra é o método — e ela não é pequena.
A Anthropic fez algo que nenhum artigo do gênero tinha feito antes com esse nível de escala: colocou o julgamento de relevância dentro do sistema. Nos projetos anteriores de "IA na ciência", o humano definia o que era interessante e o agente só executava. Aqui, os agentes decidiram sozinhos que uma observação atípica merecia virar uma nova tarefa e abriram 98 tarefas adicionais por conta própria. Erraram em 14 de 17 casos — e isso é a informação mais valiosa do paper, porque mostra o preço real da automação: volume, não precisão.
Também é importante lembrar que a Anthropic não está só escrevendo código: montou um laboratório de biologia próprio na região da Baía de São Francisco e colocou a mesma equipe cuidando do treinamento do modelo e dos experimentos de bancada. A justificativa oficial é direta — em biologia, o teste final continua sendo a bancada. Uma hipótese bonita é só uma hipótese até alguém molhar a pipeta.
Isso conecta com outro post da casa: em setembro, 10 mil IAs resolveram um problema de matemática aberto há 90 anos. Matemática tem uma vantagem cruel sobre biologia: um matemático pode trabalhar só com a lógica. Um biólogo quase sempre precisa de um laboratório. A IA acabou de aprender a fazer a parte que a matemática já permitia — e agora esbarrou na parte que exige um edifício de concreto.
E o que isso significa para o Brasil
O Brasil é um dos países mais bem posicionados do mundo para essa próxima fase, e não pela IA — pelos dados. Nosso território concentra uma parcela enorme da biodiversidade planetária, com microbiomas de solo, rios e da própria Amazônia que praticamente não foram sequenciados em profundidade. É matéria-prima para garimpo genômico em uma escala que os bancos públicos só começaram a arranhar.
O gargalo, aqui, é o mesmo que o paper tenta atacar — só que multiplicado. Falta infraestrutura de análise em escala, falta gente formada em biologia computacional e falta, sobretudo, bancada: sequenciar é cada vez mais barato, mas confirmar que um sistema faz o que parece que faz continua exigindo laboratório, dinheiro e tempo.
A leitura otimista é que a barreira de entrada para o garimpo acabou de cair. Um grupo de pesquisa pequeno, com acesso a um modelo de fronteira e um bom harness de agentes, hoje consegue varrer bases que antes exigiriam um time inteiro de curadores. A leitura realista é que o valor não está em achar o padrão esquisito — está em provar o que ele faz. E essa parte, por enquanto, continua sendo trabalho de gente com jaleco.