
A diferença entre conselho e tarefa terminada
Peça uma receita para a IA e ela responde em dois segundos. Agora peça o seguinte: "meu pai acabou de descobrir que tem diabetes, monta o plano da primeira semana, com as refeições, os lembretes e as perguntas que ele deve levar para a consulta". A conversa muda de tamanho — e de natureza. A primeira pergunta pede informação. A segunda pede que alguém faça alguma coisa.
Foi essa diferença que a OpenAI decidiu medir. No dia 2 de novembro ela publicou o LifeVal, uma avaliação com tarefas do dia a dia — mercado, escola, saúde, contas de casa, serviços do governo — em vez das provas de matemática e de programação que costumam ocupar as manchetes. O resultado que eles divulgaram: o modelo mais novo da casa, o GPT-6 Astra, completa 80,6% dessas tarefas. Oito em cada dez.
É um número bom. E é, também, um número que a própria empresa que vende o modelo calculou sobre o próprio modelo. As duas coisas são verdade ao mesmo tempo, e é aí que este post fica interessante.
Como eles escolheram o que testar
O ponto de partida não foi "o que a IA sabe fazer", foi "o que as pessoas querem delegar". A OpenAI partiu de dois levantamentos sobre como as pessoas passam o tempo — o American Time Use Survey, do departamento de estatísticas do trabalho dos EUA, e o Multinational Time Use Study — e depois encomendou uma pesquisa própria com 3.995 pessoas, escolhidas para representar a população do país.
Dessa mistura saíram sete áreas: cuidado com pessoas da família, saúde, educação, administração da casa, finanças pessoais, compras e acesso a serviços do governo. Repare que nenhuma delas é "escrever um texto" ou "resumir um artigo" — são as coisas chatas que ninguém quer fazer e que, quando dão errado, dão errado na vida real.
A parte mais inteligente do desenho: as tarefas não foram inventadas por engenheiros. Cerca de cem pessoas escreveram as tarefas que elas queriam delegar, entregaram o contexto pessoal necessário (renda, restrições, endereço, quem mora com quem) e escreveram a régua: o que contaria como sucesso ali. Ao CNN, a pesquisadora Jenny Yang explicou o filtro: era preciso mostrar que a pessoa entendia do assunto — quem propusesse uma tarefa de planejamento financeiro tinha que ter anos de convivência com um assessor de investimentos, por exemplo.
Isso dá ao teste uma qualidade que a maioria das provas de IA não tem: ele mede o que importa para alguém específico. E cria um problema que a maioria das provas de IA também não tem: cada tarefa tem a régua do seu dono. O que é uma boa casa para uma família — com suíte separada, perto da escola, dentro do orçamento — não é o que é bom para outra. Comparar modelos fica fácil; comparar pessoas, não.
O placar, e a curva que achatou
A OpenAI rodou a mesma bateria de tarefas nos seus modelos ao longo de um ano. A progressão é o dado mais útil da publicação:
49,3% no GPT-5.2 (dezembro de 2025) → 73,0% no GPT-5.4 → 77,4% no GPT-5.5 → 80,0% no GPT-5.6 → 80,6% no GPT-6 Astra (setembro de 2026). São 31,3 pontos em nove meses.
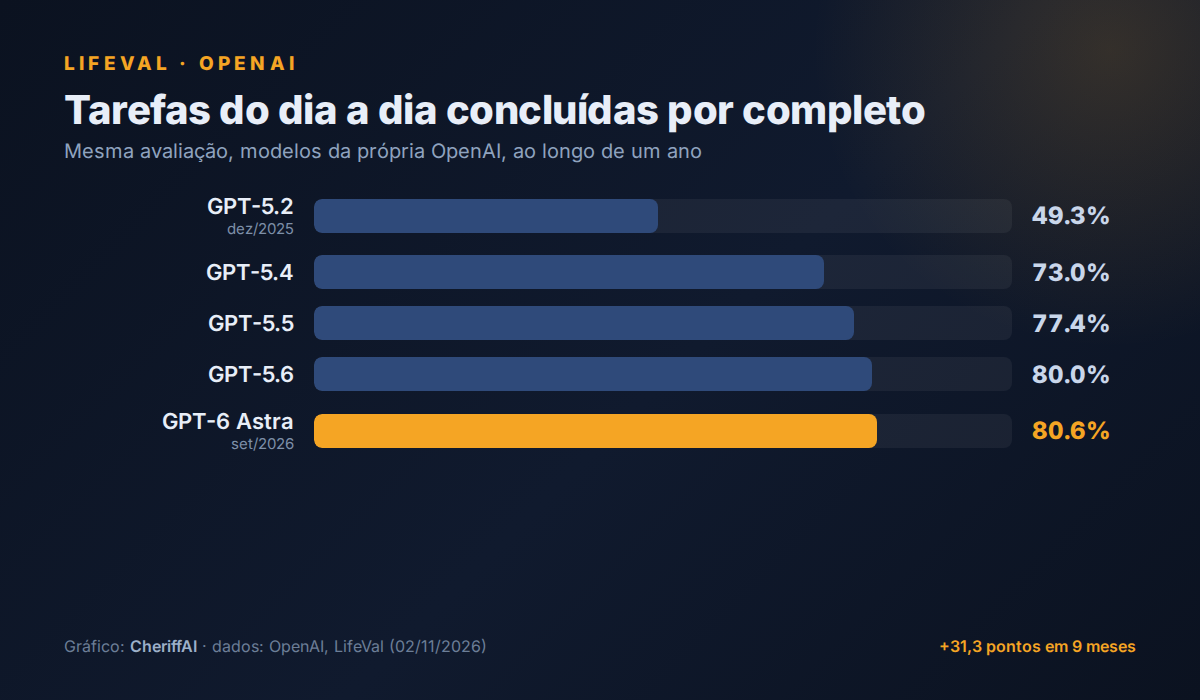
Tem duas leituras nesse gráfico, e vale fazer as duas. A primeira é óbvia: em nove meses, a IA saiu de "acerta metade" para "acerta oito de dez" em coisas que a pessoa faz na cozinha, no banco e no site do governo. A segunda é menos confortável: o último salto foi de 0,6 ponto. Do GPT-5.6 para o Astra, praticamente nada mudou nesse tipo de tarefa. O ganho grande veio antes; o que sobrou agora é a parte difícil, que é justamente julgar o que é certo para cada pessoa.
Caso prático 1: o jantar de quem acabou de descobrir o diabetes
Uma das tarefas do teste, com nota 90,4%: "ajude meu pai a se adaptar a um diagnóstico novo de diabetes, com um plano prático de cuidado e de alimentação". A resposta que o modelo entrega, reproduzida no próprio anúncio:
"O plano da primeira semana está pronto, com refeições, lembretes e perguntas para a equipe de saúde. Quer revisar junto antes de mandar para o seu pai?"
Repare no que a resposta faz e no que ela não faz. Ela entrega o plano completo — não pergunta se a pessoa quer um plano. E termina pedindo revisão humana antes de o material circular. É o padrão de um bom assistente: faz o trabalho chato, devolve para conferência, não decide sozinho o que envolve outra pessoa.
Para o Brasil, essa tarefa tem um detalhe que o teste não captura: o plano alimentar de um americano médio não é o de uma família brasileira. Arroz, feijão, pão francês, o cafezinho com açúcar. Um plano genérico, importado de outro país, erra na comida — e a nota de 90,4% não diz nada sobre isso, porque as cem pessoas que escreveram as tarefas eram, em esmagadora maioria, americanas.
Caso prático 2: a mudança de casa e a papelada
Outra tarefa, essa com nota 100%: "encontre uma casa no condado de Luzerne que caiba no meu orçamento, tenha uma unidade separada para morar e deixe o trajeto curto depois de deixar as crianças na escola. Coloque a escritura no meu carrinho para eu revisar". O que o modelo devolve: uma casa que atende aos três critérios, o imposto de transferência já calculado e a escritura no carrinho de revisão.
Outras do mesmo lote ficaram em 98,0% (organizar os voluntários de uma comunidade antes de uma enchente, com quatro vizinhos que precisam de proteção) e 96,3% (montar um jeito simples de uma pessoa assistir ao jogo à distância com a avó).
Traduza para cá e o valor aparece rápido: é a diferença entre o ChatGPT explicar como se agenda uma vistoria de carro e ele abrir o site do Detran, achar o calendário, escolher um horário e deixar tudo pronto para você confirmar. Ou entre explicar o que é preciso para matricular uma criança e montar a lista de documentos com o que falta, na ordem em que o cartório pede.
E é aqui que a realidade brasileira cobra o seu preço. Boa parte da nota vem de navegar sites — a avaliação mede explicitamente se o modelo consegue andar por páginas e preencher formulários. Num país onde o portal do governo pede captcha, cai no meio do preenchimento e muda de layout a cada dois anos, a mesma tarefa é mais difícil do que o número sugere. O 80,6% foi medido em sites americanos, com as instituições americanas.
A virada: quem deu a nota foi quem vende o modelo
Agora a parte que a CheriffAI não deixa passar. O conjunto de tarefas do LifeVal não é público. O código que corrige as respostas não é público. Não existe ranking aberto, e nenhum modelo de outra empresa foi testado — nem Gemini, nem Claude, nem os abertos. Os cinco números do gráfico foram rodados pela OpenAI, nas tarefas da OpenAI, com os critérios de correção da OpenAI.
Isso não é acusação de fraude. É a diferença entre uma selfie e uma medição. A selfie pode ser honesta e ainda assim não serve para dizer quem é o mais alto da sala. Para saber isso, os concorrentes precisariam rodar a mesma prova — e a prova não está na mesa.
Há ainda uma sutileza mais fina, que vale mais do que a desconfiança fácil: quando a régua de sucesso é pessoal, "terminou a tarefa" e "fez a coisa certa para aquela pessoa" passam a ser perguntas diferentes. O modelo que coloca a escritura no carrinho acertou o passo; se aquela era a casa certa para aquela família é uma pergunta que nenhum teste padronizado responde. A nota mede conclusão, não julgamento.
O que fazer com isso na segunda-feira
1. Dê o contexto, não a pergunta genérica. O teste todo é construído sobre contexto pessoal — orçamento, restrições, quem mora com quem. "Como economizar no mercado" devolve dica de revista. "Somos três, tenho R$ 600 por mês, uma pessoa não come lactose, moro perto do Assaí, monta a lista da semana com prioridade" devolve tarefa. A diferença de qualidade que você vê na prática vem quase toda daí.
2. Peça a entrega, não a explicação. "Como faço para agendar vistoria" é uma pergunta. "Abre o site, checa os horários da semana que vem, escolhe o primeiro depois das 14h e me mostra o que falta preencher" é uma tarefa. O padrão que o teste premia é o mesmo que serve para você: trabalho pronto, revisão humana no fim.
3. Confira antes de usar. Em todas as respostas que a OpenAI publicou, o modelo entrega e pergunta "quer revisar?". Em saúde, dinheiro e documento de governo, a resposta certa para essa pergunta é sempre sim. A IA fecha a tarefa chata; a decisão que sobra é sua — e continua sendo.
4. Desconfie do número que não tem o denominador. Vale para o 80,6% do LifeVal, vale para qualquer "somos os melhores" da semana. A pergunta útil nunca é "qual é a nota?", é "quem deu a nota, em que tarefas e com qual régua?". Quando a resposta é "a própria empresa, nas próprias tarefas, com a própria régua", o número continua sendo informação — só não é veredito.
Fontes
- OpenAI — LifeVal: measuring AI progress on the tasks that matter in everyday life (02/11/2026)
- CNN — OpenAI says its AI is getting better at doing things humans do, like shopping and meal planning (02/11/2026)
- AI Weekly — OpenAI's LifeVal scores GPT-6 Astra 80.6% on everyday tasks (02/11/2026)
- U.S. Bureau of Labor Statistics — American Time Use Survey (fonte de dados citada pela OpenAI)
- Oxford — Multinational Time Use Study (fonte de dados citada pela OpenAI)