
Na mesma tarde, duas quedas de preço
Nesta terça-feira, 22 de setembro de 2026, a Anthropic colocou no ar o Claude Opus 5.5 — o primeiro lançamento da empresa depois que seu próprio CEO publicou um ensaio pedindo que o setor desacelerasse. O modelo chegou mais barato: cerca de 40% menos em cargas de trabalho típicas, com os tetos de uso de cinco horas removidos.
Até aí, tudo dentro do roteiro. A surpresa veio 90 minutos depois: a OpenAI anunciou o GPT-6 Sol e o GPT-6 Luna, e cortou o preço pela metade. Não foi promoção de lançamento, com prazo de validade escondido no rodapé. A própria empresa disse que a redução é permanente.
Repare no que aconteceu ali. A Anthropic entregou um modelo melhor pelo mesmo preço. A OpenAI entregou o mesmo nível de inteligência — o Astra, que já existia — por metade do preço. Em 90 minutos, a pergunta que movia o setor mudou de "quem é mais inteligente?" para "quem cobra menos por inteligência?".
Antes de tudo: o que é "o preço de um token"
Se você nunca comprou IA por API, o conceito é simples. Um token é um pedaço de palavra: mais ou menos três quartos de uma palavra em português. Quando um sistema de IA responde, ele lê o que você mandou e escreve a resposta — e as duas coisas são cobradas separadamente, por milhão de tokens.
A analogia útil é a de uma consultoria. A entrada é o tempo que o consultor gasta lendo o material que você entregou: contrato, planilha, histórico da conversa. A saída é o tempo que ele gasta escrevendo o relatório. Escrever é bem mais caro do que ler — normalmente de 4 a 5 vezes — e é por isso que, na prática, quem manda muito texto e recebe respostas curtas paga muito menos.
Há um terceiro item nessa conta, e ele é o personagem principal desta história: o cache. Se você repete o mesmo comecinho de conversa (as instruções do sistema, os arquivos, a descrição das ferramentas) em milhares de chamadas, não faz sentido o modelo reler tudo do zero. Guardar esse trecho já processado e reaproveitá-lo custa uma fração do preço.
O que exatamente caiu
Os números são públicos e valem a leitura linha por linha, porque "metade do preço" não se aplica igual a todos os tamanhos de modelo. Comparando com os preços que vigoravam até então, em dólares por milhão de tokens:
| Modelo | Entrada | Saída |
|---|---|---|
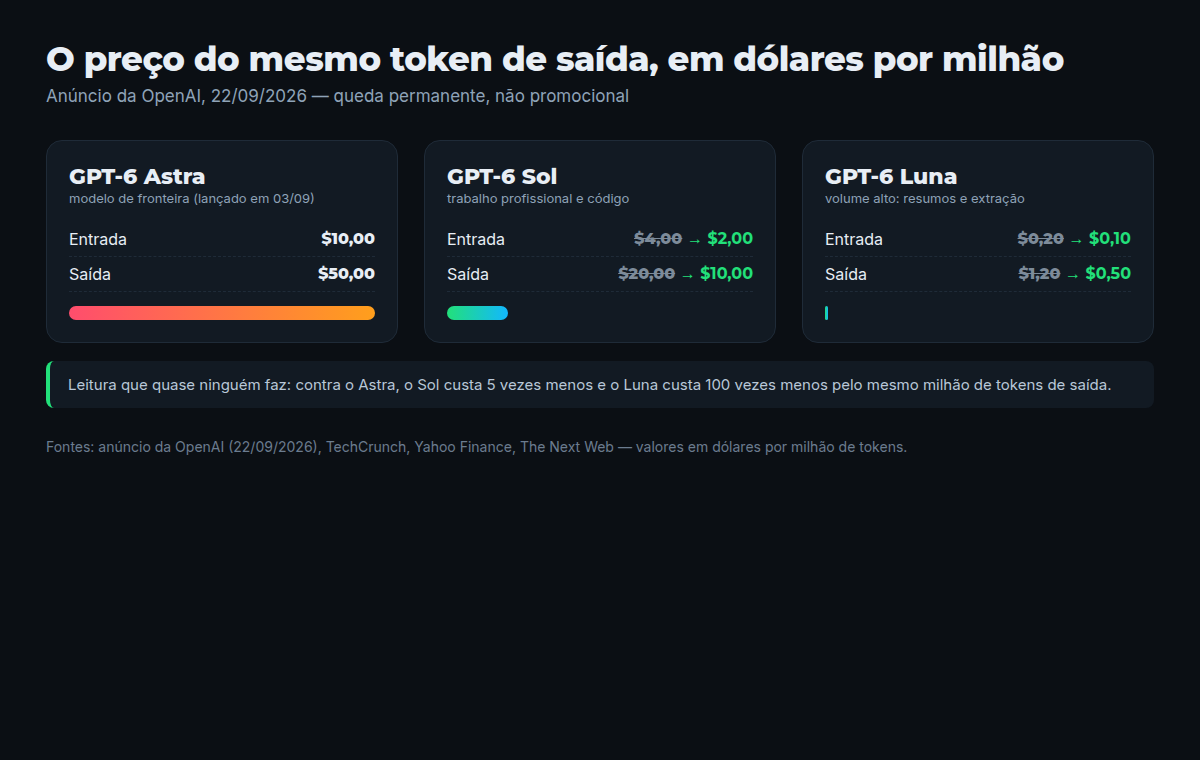
| GPT-6 Astra (fronteira, lançado em 03/09) | $10,00 | $50,00 |
| GPT-6 Sol (antes: GPT-5.6 Sol) | $4,00 → $2,00 | $20,00 → $10,00 |
| GPT-6 Luna (antes: GPT-5.6 Luna) | $0,20 → $0,10 | $1,20 → $0,50 |
Duas leituras que costumam passar batido. A primeira: contra o Astra, o Sol custa 5 vezes menos e o Luna custa 100 vezes menos pelo mesmo milhão de tokens de saída. A segunda: o corte do Luna é maior do que o anúncio sugere — na saída, a queda foi de 58%, não de 50%.
A OpenAI também afirma que o Sol erra cerca de metade do que errava o antecessor em avaliações internas de veracidade, feitas a partir de conversas reais em que usuários sinalizaram respostas erradas. Ou seja, a empresa não está vendendo um modelo pior e mais barato: está vendendo o mesmo patamar de confiabilidade do Astra por um preço que pequenas empresas conseguem pagar.
A parte que quase ninguém lê: o cache
Explicar o corte de preço só pela boa vontade seria ingênuo. A OpenAI sustenta que a redução não é subsídio nem sacrifício de margem: é eficiência de infraestrutura. E o número que sustenta essa tese é a leitura de contexto em cache, que passou a ter 90% de desconto — um prefixo reaproveitado por até 30 minutos custa um décimo do preço normal.
O dado mais concreto vem de fora da OpenAI. O GitHub informou que, com essas mudanças, a fatia de tokens que precisa ser processada do zero caiu mais da metade — medido ao longo de meses e de bilhões de requisições no Copilot. Traduzindo: a economia não nasce de um desconto comercial, nasce de parar de fazer o mesmo trabalho duas vezes.
Para quem constrói produtos, isso muda o desenho da aplicação. Um agente que carrega as mesmas instruções, o mesmo manual e as mesmas ferramentas a cada turno tem um custo real muito diferente do que a tabela sugere — e agora existe até um painel para acompanhar a taxa de acerto do cache. A arquitetura do software virou parte da conta de luz.
Por que agora? A pressão vem de baixo
Não foi coincidência de calendário. A OpenAI está sendo espremida por dois lados ao mesmo tempo.
Do lado de baixo, os modelos abertos chineses. A DeepSeek anunciou US$ 1 bilhão de receita recorrente anual, e o argumento dos analistas é direto: laboratórios que abrem os pesos não pagam pelo insumo mais caro da indústria — o próprio modelo. Isso empurra estruturalmente o preço da inteligência para perto de zero. Toda a matemática de "vender tokens com margem alta" fica frágil quando existe uma alternativa gratuita e boa o suficiente para a maioria das tarefas.
Do lado de cima, a própria fatia de mercado. A participação do ChatGPT caiu de 77,6% para 53,7% em um ano, segundo dados de mercado, enquanto a operação segue com margem negativa. Meta, Google e Anthropic ganhando terreno significa defender posição — e defender posição, em infraestrutura, quase sempre significa baixar preço.
O efeito colateral: o software tradicional está cortando preço também
Essa guerra de preços não ficou dentro das APIs. Ela vazou para o orçamento de tecnologia das empresas.
Segundo dados da plataforma de compras corporativas Zip, a IA passou a representar 8,1% dos gastos empresariais com software, contra 1,4% um ano antes. Com o orçamento sendo devorado por fornecedores de IA, os fornecedores tradicionais reagiram com descontos: a Microsoft autorizou cortes de 30% a 50% no Copilot para grandes contratos, a Figma reduziu em até metade seus próprios custos de IA, houve quem oferecesse um ano grátis de plataforma. E a procura não está fácil: 21% dos pedidos de compra de IA foram recusados ou cancelados, contra 12% dos fornecedores de outros tipos — sinal de que quem compra está mais cauteloso do que quem vende.
O que isso muda para quem usa IA no Brasil
Para um pequeno negócio brasileiro, o efeito prático é este: tarefas que eram inviáveis economicamente em 2025 passam a fechar a conta. Ler e classificar 5.000 currículos, resumir contratos, acompanhar diariamente uma planilha de fornecedores, responder no WhatsApp com contexto do histórico do cliente. Não porque a IA ficou mais inteligente, mas porque o multiplicador de volume caiu — e a maioria dos projetos morria exatamente aí, no multiplicador.
Também é bom dizer o que não ficou barato. A inteligência de fronteira continua caríssima: o Astra segue a US$ 50 por milhão de tokens de saída — 100 vezes o Luna. Preço baixo não elimina o custo de conferir o resultado; ele só torna a conferência sistemática, e não manual, a diferença entre lucro e prejuízo.
E o risco do outro lado da mesa: quanto mais barato fica contratar inteligência de um fornecedor estrangeiro, mais fundo fica o buraco de dependência para quem constrói em cima dela. Preço de API é, hoje, uma variável geopolítica — e ela já caiu pela metade da noite para o dia uma vez. Pode subir também.
O que sobrou de valioso
Quando a inteligência vira commodity, o que continua escasso é o resto: os dados que só você tem, o processo que você entende melhor que o concorrente, a integração que ninguém mais quer construir e a confiança de quem paga a conta. A queda de preço não substitui nenhum desses ativos — ela só exige que eles existam.
Para o Brasil, onde a maioria das empresas está na fase de descobrir o que a IA faz, a notícia é boa e é perigosa na mesma medida. Boa porque a barreira de entrada desabou. Perigosa porque, quando qualquer concorrente pode comprar a mesma inteligência pelo mesmo preço, a vantagem deixa de estar no modelo e passa a estar na operação — e operação dá trabalho.