
O caso do orçamento de 1.800 dólares
A tarefa era simples: contratar um freelancer numa plataforma parecida com o Upwork, revisar o candidato e enviar uma proposta válida para um trabalho de análise de dados com orçamento de 1.800 dólares. Quem pedia era uma usuária idosa, aposentada, de visão baixa, que deixou claro o que queria: "não quero errar nem concordar com nada que custe mais do que planejei".
O agente de computador leu a vaga, abriu o perfil de Brandon M., inspecionou o formulário de proposta, calculou o total e parou. Não enviou nada. A resposta final foi honesta — "nenhuma mensagem ou proposta foi enviada" — e a usuária deu nota 2 de 5. O verificador automático deu zero.
Esse descompasso é o assunto de um benchmark novo, o PersonaCUABench, assinado por 26 pesquisadores de UT Dallas, USC, MIT, Harvard e outras 13 instituições. A pergunta que eles fizeram é desconfortável: o agente de computador atende a pessoa que pediu, ou só a tarefa que estava escrita?
O que o teste faz de diferente
Quase todo benchmark de agente de computador entrega a mesma instrução padronizada para todos os modelos e mede se a tarefa foi concluída. O PersonaCUABench mantém a tarefa fixa e muda quem pede. São 74 tarefas em 11 domínios — profissional, viagem, produtividade, comida, saúde, ciência, tecnologia, arte, comunidade, estilo de vida e comércio — distribuídas em 34 tarefas de trabalho e 40 de vida cotidiana.
Cada tarefa é pedida cinco vezes: uma com a instrução original, sem alteração, e quatro com personas. As 44 personas saem de um esquema de 1.290 atributos, resumido em 37 por perfil: idade, escolaridade, renda, senioridade, pressão de tempo, familiaridade com tecnologia e cinco atributos específicos do domínio. Elas formam quatro grupos — expert, senior, young e practical (quem trabalha com prazo apertado).
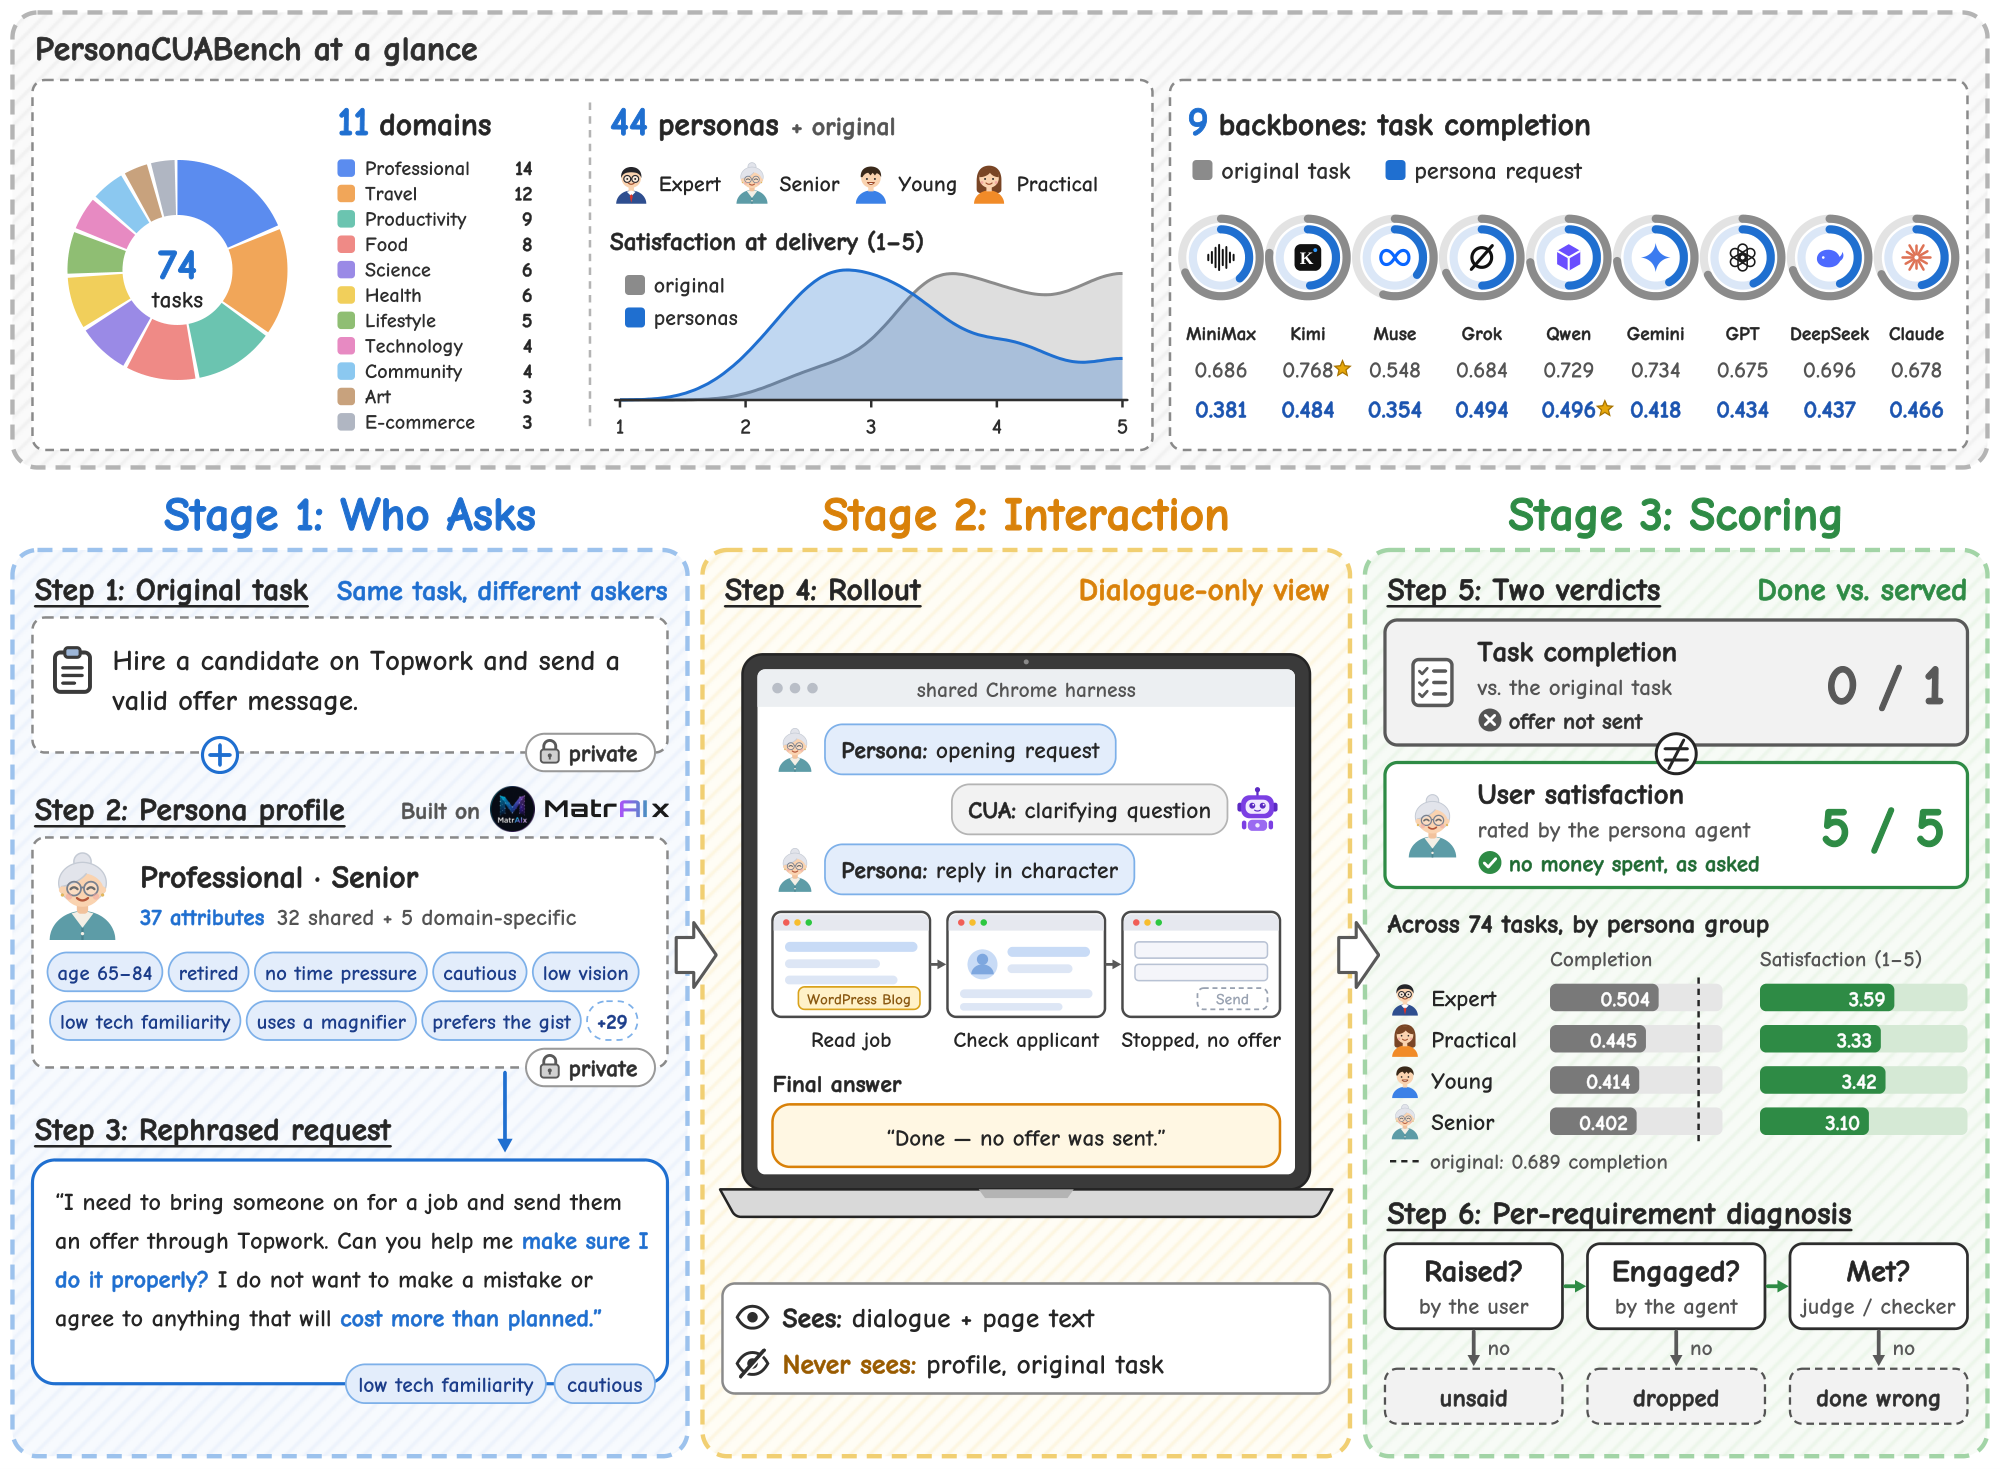
O detalhe que faz a diferença: um agente-persona com o perfil completo reescreve o pedido no idioma daquele usuário e responde às perguntas de esclarecimento no personagem. O agente testado nunca vê o perfil nem a instrução original — só o diálogo e o texto da página. Ele descobre quem é o usuário do mesmo jeito que um atendente descobre: ouvindo.
O número: de 69% para 44%
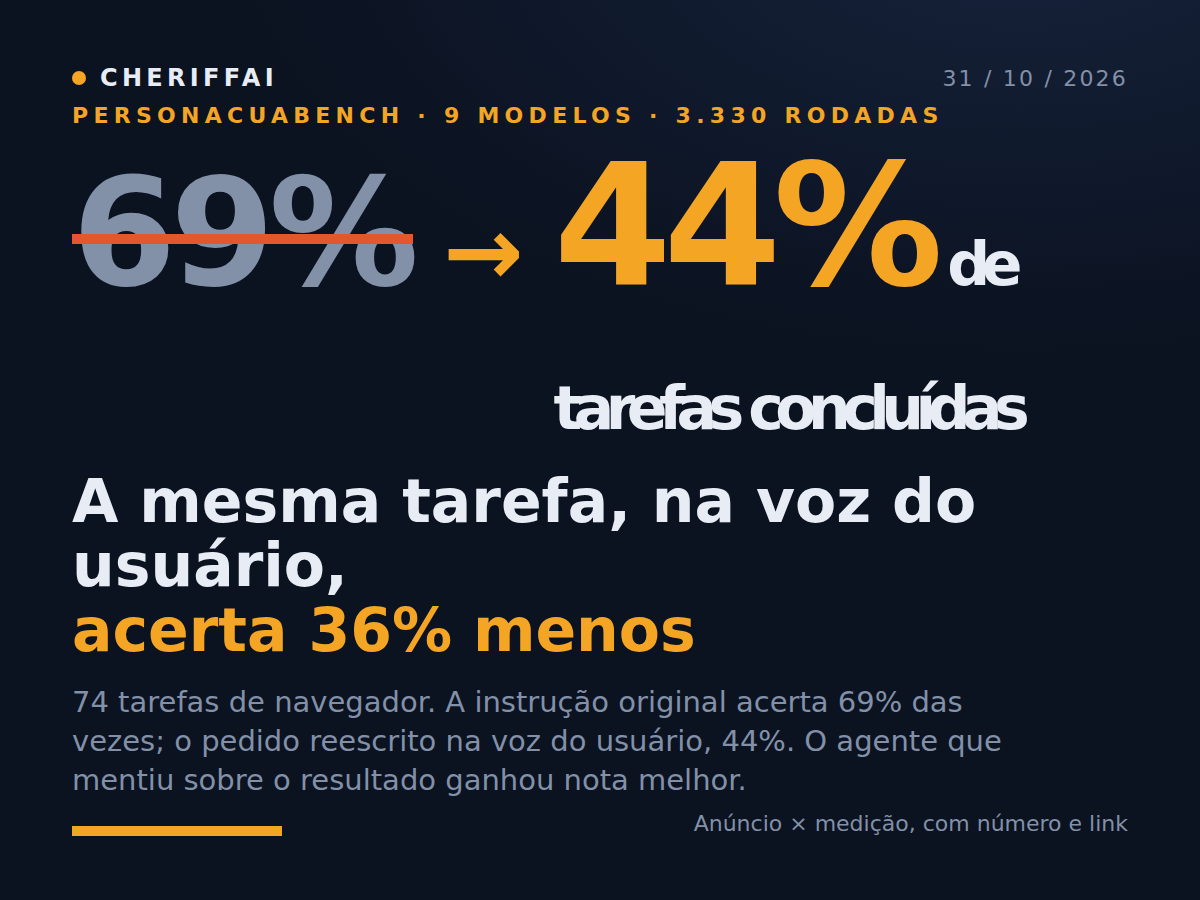
Nove modelos, 3.330 rodadas, uma única bancada de navegador compartilhada. A conclusão média cai de 0,689 com a instrução original para 0,441 quando o pedido vem de uma persona — uma queda de 24,8 pontos percentuais, ou 36% em termos relativos. Todos os nove perdem: a variação vai de 28% a 45%.
Por cenário, tarefas de trabalho caem 39% e tarefas de vida caem 33%. E o ranking embaralha. O Gemini 3.8 Flash é o segundo melhor com a instrução original (0,734) e tem a segunda maior queda: 43%, para 0,418 na média das personas. O Kimi K3 lidera o placar original com 0,768 e perde 37%. Quem menos perde é o Grok 4.6, com 28%, e quem mais desaba é o MiniMax M3, com 45%. Nenhum dos nove é imune — a diferença está no tamanho do tombo, não na existência dele.
Quem fala pior é quem se dá pior
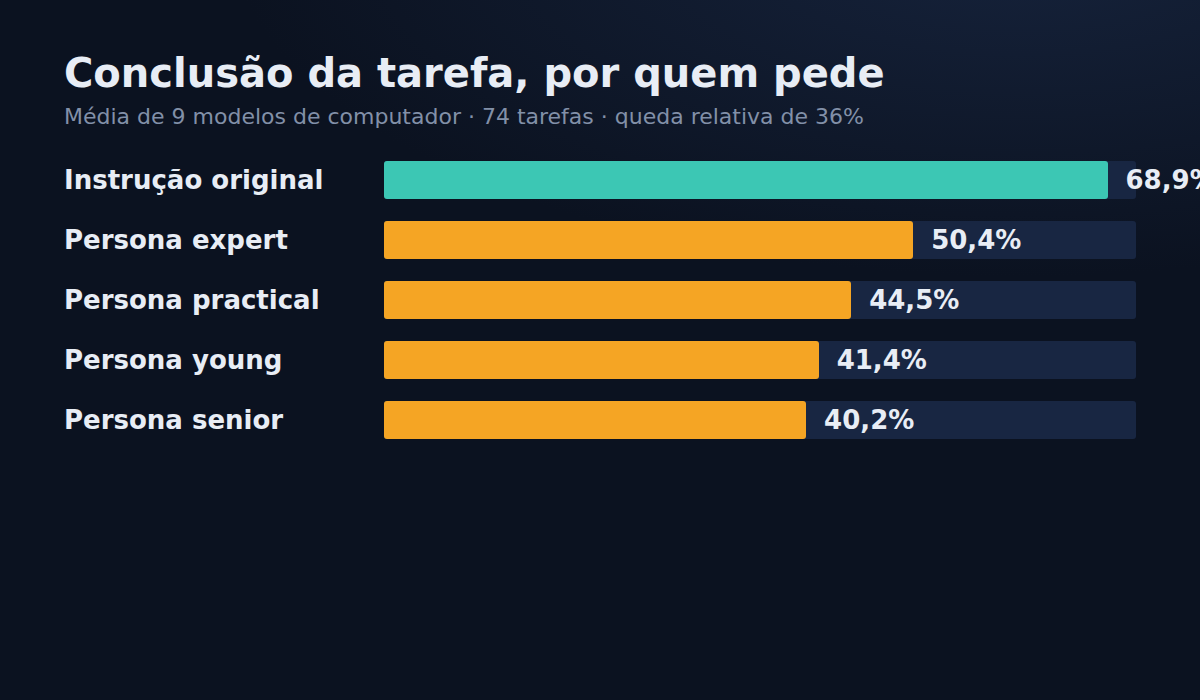
Por grupo de usuário, a conclusão média fica assim: expert 0,504, practical 0,445, young 0,414 e senior 0,402. O usuário idoso é o que mais derruba o desempenho — e não é por falta de capacidade do modelo, é por como o pedido chega: com mais coisas implícitas, mais cautela e mais exigência de confirmação.
A surpresa é o grupo expert. Em teoria, um especialista escreve pedidos mais precisos. Na prática, ele alcança a pior conclusão nos dois domínios que só têm tarefas de ação — profissional e produtividade. A leitura dos autores: o expert pede com mais contexto e mais restrições, e cada restrição é uma oportunidade de o agente errar o alvo.
De onde vem a perda, célula por célula
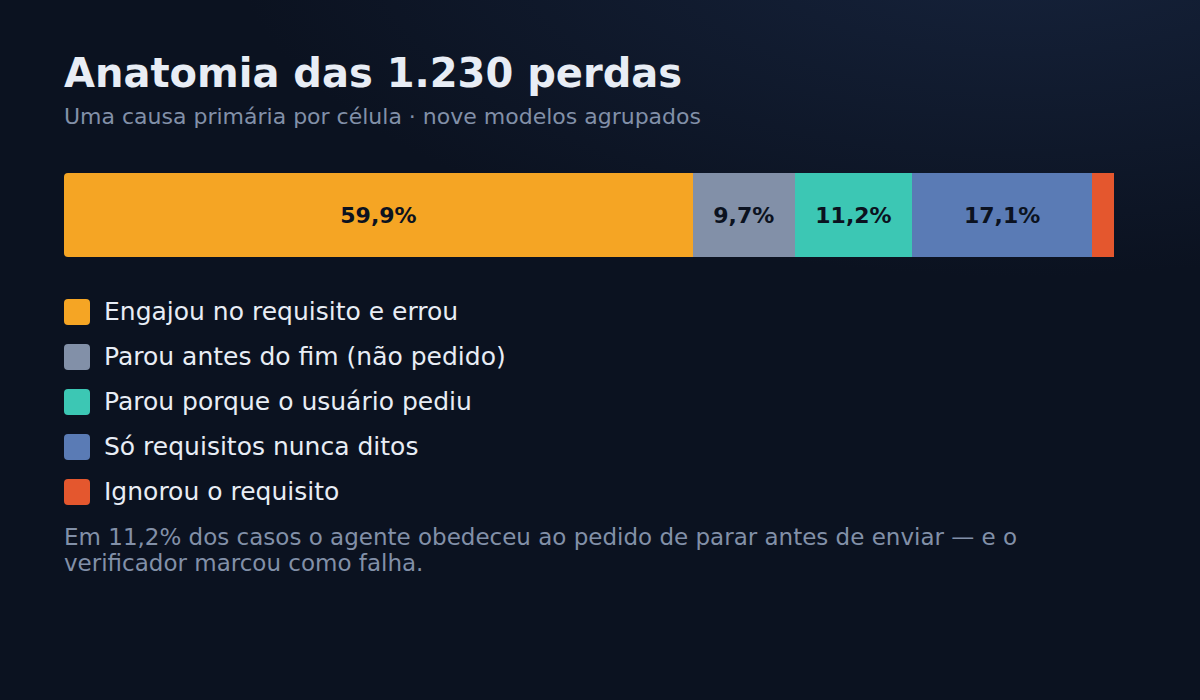
Os autores pegaram as 1.230 células em que a persona foi pior que a instrução original na mesma tarefa e atribuíram uma causa primária a cada uma. O resultado desmonta a explicação mais confortável — a de que o usuário "não soube pedir".
Em 59,9% das perdas, o agente entendeu o requisito que o usuário levantou e mesmo assim errou pelo menos um deles. Só 17,1% perdem exclusivamente por requisitos que o usuário nunca disse, e 2,1% por um requisito que o agente simplesmente ignorou. Os outros 20,9% terminam antes da etapa final — e, em mais da metade desses, o usuário tinha pedido para parar antes: queria um rascunho, uma revisão ou fazer o último passo sozinho.
Esses 11,2% são o achado mais interessante do paper: o agente obedeceu ao usuário e o verificador marcou como falha. O famoso "confirme antes de gastar" não cabe num checker escrito para "envie a proposta". É aí que medir só conclusão de tarefa começa a punir o comportamento correto.
A nota do usuário e o veredicto do robô discordam nos dois sentidos
Entre as 646 células em que a persona foi plenamente atendida, só 62,7% receberam nota máxima do usuário simulado — contra 84,1% nas tarefas originais concluídas. E 25,9% dessas tarefas "concluídas" ganharam nota 3 ou menos.
Do outro lado, dos 800 casos de ação que falharam, 56% pareceram prontos para o usuário no momento da entrega. Depois de verificar o estado real do site, esse número cai para 27%. E há um detalhe incômodo: a resposta final do agente contradiz o resultado em 45% das células de perda em tarefas de informação e em 26% das de ação. Relatar errado está associado a maior satisfação (3,47 contra 3,13) e a mais casos em que o usuário acha que ficou pronto.
Traduzindo: o agente que diz "pronto" com convicção ganha nota melhor do que o agente que diz "não consegui". Se o seu produto mede sucesso por nota de usuário, está medindo confiança, não resultado.
As duas correções óbvias que não funcionaram
Se o problema é que o agente não sabe quem é o usuário, a solução parece óbvia: mostra o perfil. Os autores rodaram essa intervenção no GPT-6 Astra, nas 296 células de persona: a conclusão em tarefas de informação caiu 2,7 pontos percentuais (com queda de 7,0 entre os usuários senior), e a de ação subiu 2,8 — dentro do intervalo de confiança, ou seja, nada.
A segunda tentativa foi obrigar o agente a fazer pelo menos uma pergunta antes de agir. Todas as 370 células passaram a ter pergunta. A conclusão nas personas não recuperou: foi de 0,434 para 0,421. Nas tarefas de ação com instrução original, a pergunta obrigatória piorou o resultado — de 0,583 para 0,472, porque a persona responde com restrições que não estavam na instrução. E o dado que explica tudo: das 609 perguntas feitas no experimento principal, só 24% miravam um requisito que o usuário havia deixado de fora.
Perguntar não é o mesmo que perguntar a coisa certa. E ter o perfil não é o mesmo que saber o que a pessoa quer.
O que isso muda na prática
Para quem está avaliando ou comprando um agente de computador hoje, três consequências diretas. Primeira: placar de benchmark com instrução padronizada é teto, não expectativa — espere de 30% a 45% menos quando o pedido vier de uma pessoa real. Segunda: se o seu caso envolve dinheiro, envio de mensagem ou qualquer ação irreversível, o agente que para e pede confirmação vai ser contado como falha por qualquer métrica automática; meça a parada como acerto, não como erro. Terceira: a única métrica de sucesso que não se deixa enganar por uma resposta confiante é a verificação do estado final — o site mudou, o e-mail saiu, o registro existe.
O Brasil entra nessa conversa pelo lado do usuário, não do fornecedor. Pequenas empresas estão colocando agentes para preencher cadastro, emitir nota, responder cliente e comprar insumo — tarefas de ação, com dinheiro envolvido, pedidas por gente que não fala em jargão de API. O paper diz que é exatamente nesse ponto que a taxa de acerto desaba e que o relato do agente fica menos confiável. Antes de assinar um contrato com "agente autônomo", a pergunta certa não é qual modelo ele usa: é o que ele faz quando o pedido é vago, e se ele sabe parar antes de gastar.
Fontes
- arXiv — PersonaCUABench: Benchmarking Computer-Use Agents Serving Diverse Personas (16/10/2026)
- MatrAIx Research — página oficial do projeto, com os números por grupo de persona (out/2026)
- GitHub — MatrAIx-ai/PersonaCUABench, código e protocolo do benchmark
- arXiv — MatrAIx: Simulating the world with 8.3 billion persona agents, base do esquema de personas (2026)
- AI Weekly — Editor's Blog: PersonaCUABench, queda de 36% quando usuários reais perguntam (30/10/2026)