
Você paga por um modelo de IA específico, a resposta chega e não existe nenhuma forma de saber se foi aquele modelo que respondeu — ou um mais barato colocado no lugar no meio do caminho.
No dia 2 de novembro a Anthropic publicou um protótipo para resolver isso: o FlashProve, um sistema que anexa a cada resposta uma prova criptográfica de que ela saiu do modelo contratado, sem revelar os pesos do modelo. É o tipo de problema que parece filosofia e vira fatura: quem compra IA através de um revendedor não tem como provar que recebeu o que pagou.
A ideia funciona. O problema está no que ela prova — e o próprio repositório é quem diz.
O que o sistema faz, sem jargão
São duas etapas.
Primeiro o provedor publica um compromisso: um código curto, como uma impressão digital, que trava um conjunto exato de pesos. Os pesos continuam secretos; o compromisso só amarra o provedor àquela escolha. Depois, a cada resposta, ele gera um arquivo de prova de que aqueles pesos, rodados naquele pedido, produzem exatamente aqueles tokens. Quem quiser conferir não precisa dos pesos nem de GPU: um verificador roda em CPU comum.
O truque é um zkSNARK — argumento sucinto de conhecimento zero. Em português: prova de que a conta foi feita corretamente, sem mostrar a conta. É a mesma família de criptografia usada em redes blockchain e em credenciais anônimas.
Os números medidos, no modelo Llama 4 Maverick (400 bilhões de parâmetros, quantizado em 4 bits), estão numa página própria do repositório: 18,78 MB de prova por requisição de 1.024 tokens, verificáveis em cerca de 21 segundos num único núcleo de CPU, com no máximo 3,5 GB de memória. O compromisso dos pesos leva uns 39 minutos e é feito uma vez.
O número da manchete precisa de 24 clientes na fila
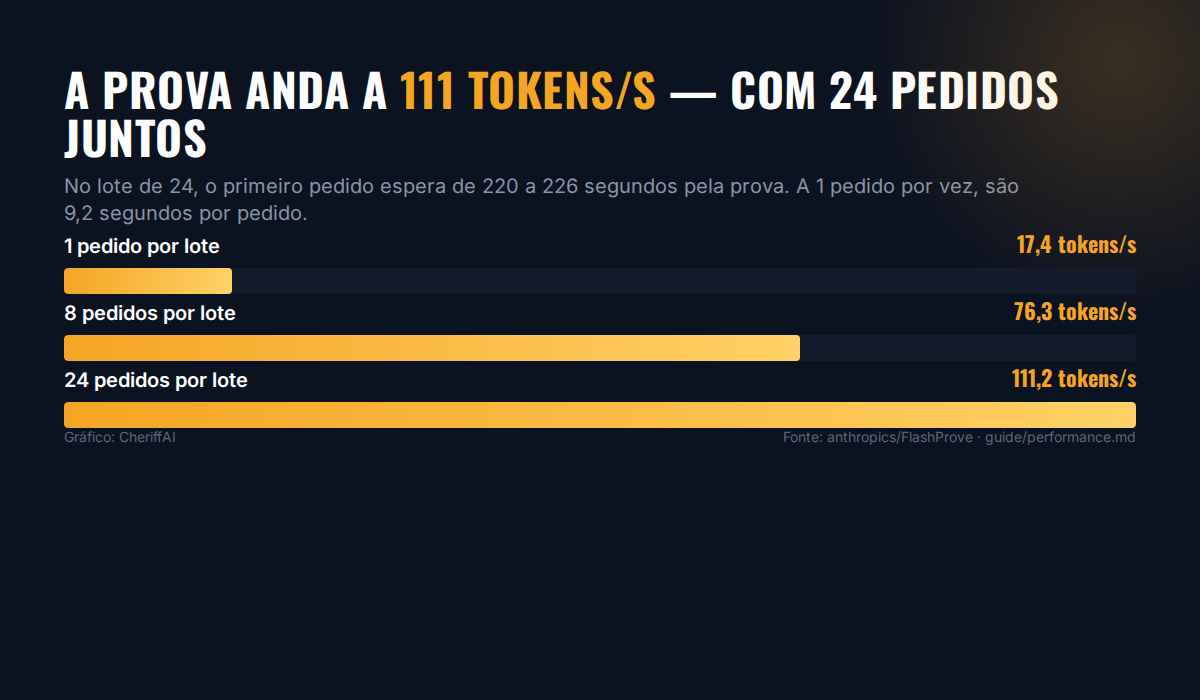
O número que circulou foi "110 tokens por segundo". Ele é real — mas só existe em uma condição específica: 24 pedidos processados juntos, num mesmo lote.
Na mesma página de medições:
- 1 pedido por lote: 17,41 tokens por segundo, ou 9,2 segundos por pedido;
- 8 pedidos por lote: 76,34 tokens por segundo;
- 24 pedidos por lote: 111,23 tokens por segundo.
E cada pedido espera o lote inteiro terminar. Com 24 na fila, a espera do primeiro lote fica entre 220 e 226 segundos. Não é trapaça: é como funciona processamento em lote, e a própria documentação diz isso. Mas é a diferença entre "prova em tempo real" e "prova em algum momento do dia".
A virada: a assinatura não diz de quem é o modelo
Aqui está o ponto que não aparece na manchete. A página de limites conhecidos do repositório é explícita:
"O provedor escolhe o modelo. Um 'sim' não diz de quem são os pesos, se o programa que fez o compromisso foi o oficial, nem qual modelo real é. Um provedor pode se comprometer com qualquer modelo que quiser — inclusive um pequeno ou degenerado."
Traduzindo: a prova garante coerência, não identidade. Ela mostra que as respostas vieram do modelo que o próprio provedor registrou — não que esse modelo seja o que ele anunciou. É um crachá que prova que a pessoa trabalha na empresa, sem provar que o nome no crachá é o dela.
E tem uma segunda política de aceitação, mais frouxa, que é a prevista para uso em produção. Nela, o próprio repositório avisa, "com limites frouxos, notas próximas ou pesos totalmente zerados deixam quase qualquer saída passar". O veredito WITHIN LIMITS não diz que a resposta é do modelo.
O detalhe que decide tudo na prática: o identificador do compromisso — o crachá — tem de vir de uma fonte independente em que você confie. Nunca do servidor que você está checando, nem dos arquivos que vieram junto com a prova.
O teste que interessa: 96 respostas reais, nenhuma aprovada
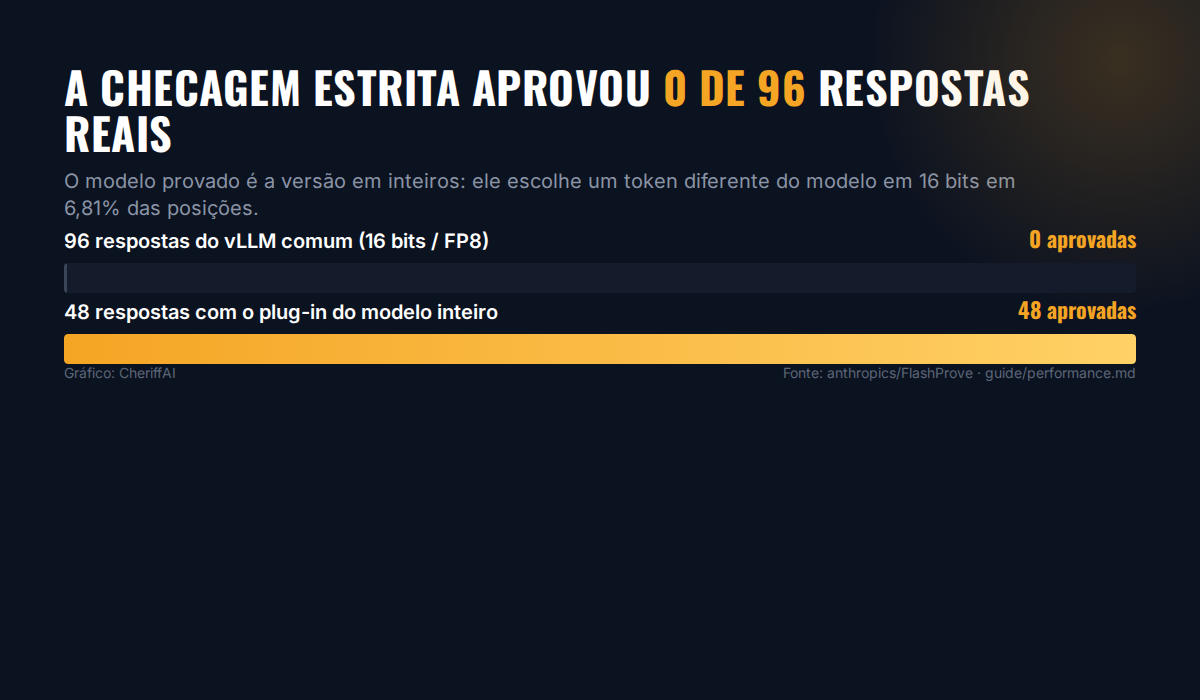
A página de performance tem um parágrafo com o título "Provar, não servir", e ele é o mais importante do repositório. A prova é sobre uma versão em números inteiros do modelo, com decodificação gulosa — a escolha sempre do token mais provável. Na checagem mais estrita, uma resposta só passa se cada token for a escolha daquele modelo inteiro.
Resultado medido: de 96 respostas guardadas, geradas pelo vLLM comum em 16 bits e em FP8, nenhuma passou. Zero de 96.
Só com um plug-in feito para calcular exatamente o modelo inteiro as respostas passaram: 48 de 48 — servindo, porém, a 0,58 a 1,46 segundo por token. E o modelo inteiro diverge do modelo em 16 bits em 6,81% das posições.
Nada disso é falha escondida — está tudo escrito. Mas muda a leitura do anúncio: não é "a IA agora prova que respondeu". É "existe uma prova, para um modelo em inteiros com decodificação gulosa, em janelas de 1.024 tokens, e ela ainda não conversa com o jeito como os modelos são servidos de verdade".
E tem uma assimetria fina na garantia formal. Em Lean, o sigilo dos pesos — a promessa de que a prova não entrega nada do modelo — está demonstrado quando as requisições são provadas uma de cada vez, e ainda não quando são provadas em lote. Isto é: o modo que entrega os 111 tokens por segundo é exatamente o que fica fora da demonstração.
O preço da assinatura
Provar custa caro. A conta publicada: 93 vezes mais tempo de GPU que o vLLM comum no maior carregamento testado (71 vezes comparando com 24 pedidos de uma vez). Em um serviço com milhares de usuários simultâneos, isso não é detalhe de otimização — é a diferença entre servir e não servir.
O escopo também é estreito: janelas de 1.024 tokens, contra centenas de milhares a milhões nos modelos de fronteira. A arquitetura não é escondida (o sistema assume mistura de especialistas e protege só os pesos). E a máquina do provedor precisa de 330 GB de memória e 245 GB de disco para rodar a rota completa com os pesos reais.
A ironia que fecha o círculo
Entre as limitações do relatório técnico, há um item chamado "descrição do protocolo":
"O repositório também mantém um documento separado, muito mais longo, que descreve o protocolo em detalhe completo. Esse documento foi gerado por IA, e nós não o revisamos em detalhe. Um artigo cuidadosamente revisado virá depois. Este relatório, em contraste, foi escrito pelos seus autores."
Ou seja: o relatório foi escrito por gente — e a Anthropic faz questão de dizer isso. Mas o documento que descreve o protocolo em detalhe completo, justamente o que um auditor leria para conferir o sistema, foi escrito por um modelo e não revisado linha por linha. O mesmo vale para o código do verificador em CPU, que "é gerado por IA a partir da sua representação em Lean".
Não é escândalo — é uma transparência que quase nenhum laboratório pratica. Cada documento diz onde a garantia termina, incluindo a página que reúne os números que citei: "os registros das execuções não estão neste repositório, então o leitor não pode conferir os números desta página". Mas é o retrato de 2026: até o mecanismo que separa o verificado do não verificado precisa que alguém o verifique.
O que continua valendo
O problema é real, a direção é a certa e o salto é grande de verdade. O VerInf, único sistema aberto que provava o mesmo modelo, fazia 0,02 token por segundo — 14,3 horas para 1.000 tokens, com prova de 93,6 GB que levava quase 18 horas para conferir. Em dois anos saímos disso para 18,78 MB verificáveis em 21 segundos. É progresso de duas ordens de grandeza.
O que não vale esperar é que isso já sirva de auditoria. O repositório é de 30 de outubro, versão 0.16.0, e se descreve como "artefato de pesquisa: não mantido, não aceita contribuições" — com 667 estrelas e 57 forks em cinco dias, ou seja, interesse alto e manutenção zero. A Anthropic registra que a meta pública de ter um protótipo de inferência verificável até 30 de setembro foi cumprida por outro sistema, não pelo FlashProve. E há um limite que nenhuma prova criptográfica resolve: ela mostra que o hardware está servindo aquele modelo, mas "não estabelece que o hardware não está, por exemplo, treinando em paralelo" — justamente o que um regulador precisaria saber.
O que isso muda para quem compra IA no Brasil
Boa parte das empresas brasileiras não compra IA direto do laboratório: compra de revendedor, de agregador, de plataforma que roteia entre vários modelos. É exatamente o cenário que o FlashProve descreve como risco.
Para quem responde por LGPD, a pergunta "qual modelo processou o dado do meu cliente" sai do terreno filosófico e vira item de auditoria — e não será respondida por boa-fé do fornecedor.
O que dá para exigir já, sem esperar a tecnologia amadurecer: versão do modelo declarada em contrato, política explícita de não substituição silenciosa e, quando existir, compromisso publicado em canal independente do próprio fornecedor. A pergunta certa hoje vale mais que a resposta: como eu confiro?
O FlashProve é a primeira resposta técnica honesta a essa pergunta. Só não é a resposta final — e a Anthropic escreve isso, com todas as letras, no primeiro item das limitações.
Fontes
- Anthropic — Progress on provable inference for large language models (02/11/2026)
- Anthropic — FlashProve: an open-source library for provable inference (relatório técnico, 02/11/2026)
- GitHub — anthropics/FlashProve, repositório e README (criado em 30/10/2026)
- GitHub — FlashProve, guide/performance.md (todas as medições de velocidade, tamanho e o teste das 96 respostas)
- GitHub — FlashProve, guide/known-limits.md (limites conhecidos e a citação sobre o provedor escolher o modelo)
- GitHub — FlashProve, guide/what-is-proved.md (o que é provado, e de quê)