
No dia 15 de outubro, a NVIDIA colocou no ar um modelo de linguagem com 74 bilhões de parâmetros que cabe inteiro numa placa de vídeo de 24 GB. Não é um modelo pequeno treinado do zero: é um modelo de 120 bilhões de parâmetros espremido até ocupar o espaço de um arquivo de 22 GB. O nome entrega a intenção: Nemotron 3.5 Bolt 74B-A9B 24GB.
É uma mudança de categoria. Até esta semana, "modelo aberto" no topo da fronteira significava um download que quase ninguém consegue rodar: 650 GB e quatro GPUs, como no Step 5 que abriu os pesos, ou 816 bilhões de parâmetros que pedem dois Mac Studios com 512 GB de memória cada, como o Muse Spark Open da Meta, lançado no mesmo dia. O Bolt é o oposto: foi desenhado para caber no computador em que você está lendo isto.
Só que tem um detalhe que a página de lançamento não coloca na manchete: o modelo fala inglês, espanhol, francês, alemão, italiano e japonês. Português não está na lista.
O que exatamente foi lançado
Segundo o model card no Hugging Face, são 74 bilhões de parâmetros totais com apenas 9 bilhões ativos por token. A arquitetura é híbrida: camadas Mamba-2 (mais baratas para contexto longo) misturadas com camadas de atenção, no esquema de mistura de especialistas em que só uma fração da rede é acionada a cada palavra gerada. Também é multimodal de entrada: aceita texto, imagem e vídeo, e responde em texto.
| Item | Valor |
|---|---|
| Parâmetros | 74B totais / 9B ativos |
| Memória ocupada | 24 GB (arquivo quantizado de ~22 GB) |
| Contexto máximo | 256 mil tokens |
| Entradas | texto, imagem e vídeo |
| Licença | OpenMDW-1.1 (uso comercial e não comercial) |
| Onde roda | llama.cpp, vLLM, Ollama, LM Studio, Unsloth |
| Idiomas declarados | inglês, espanhol, francês, alemão, italiano, japonês |
O modelo é filho do Nemotron 3.5 Super VL, de 120 bilhões de parâmetros totais e 12 bilhões ativos, que a NVIDIA também abriu e que aceita até 1 milhão de tokens de contexto. A ideia do Bolt é simples de enunciar e difícil de executar: pegar o irmão grande e comprimi-lo até caber no orçamento de memória de uma placa de consumo, sem perder o suficiente para deixar de ser útil.
Como 148 GB viram 22 GB
A primeira etapa é de arquitetura, não de compressão de arquivo. A NVIDIA usou uma técnica própria, o Star Elastic, em que um roteador procura, camada por camada, quantos especialistas e qual largura interna cabem dentro do limite de 24 GB com contexto de 128 mil tokens, e depois treina o modelo comprimido imitando o pai (destilação). Na prática: o top-K de especialistas cai de 22 para 9, o total vai de 120B para 74B e os parâmetros ativos de 12B para 9B.
A segunda etapa é a que assusta: quantização para 2 bits. Os pesos dos especialistas, que são a maior parte do modelo, foram guardados em IQ2_XXS, o que dá 2,0625 bits por elemento — contra 16 bits do formato BF16 original. Outras camadas ficaram em NVFP4 e Q8_0. Resultado: o modelo sai de 148 GB em BF16 para 22,1 GB, e é essa diferença que transforma "modelo de data center" em "modelo de desktop".
A analogia útil é a de uma orquestra gravada em fita: você não pode guardar cada instrumento com precisão de estúdio, então guarda o suficiente para reconhecer a música. A NVIDIA chama o processo de destilação com consciência de quantização (QAD) justamente porque o modelo é treinado sabendo que vai ser espremido. E o relatório técnico mede o preço: a média em nove benchmarks cai de 57,58 no pai para 54,74 no Bolt comprimido, perda de 2,85 pontos, ou 4,94%, medida antes das etapas de recuperação.
Há também um truque de velocidade: um modelo auxiliar de 1,13 bilhão de parâmetros, o LiLiCorr, que "chuta" os próximos tokens e deixa o modelo grande apenas conferir. É o que faz a decodificação passar de 80 tokens por segundo em hardware móvel.
O que a NVIDIA anuncia
A página de pesquisa da NVIDIA afirma três coisas: que o Bolt é o número 1 no PinchBench, número 2 no WebArena e número 2 no BrowseComp — sempre "quando comparado a modelos com pegada de memória parecida". E afirma 84 tokens por segundo no benchmark de codificação AIPerf, rodando em um notebook RTX Spark, a linha de hardware que a NVIDIA começou a vender exatamente no dia seguinte ao lançamento.
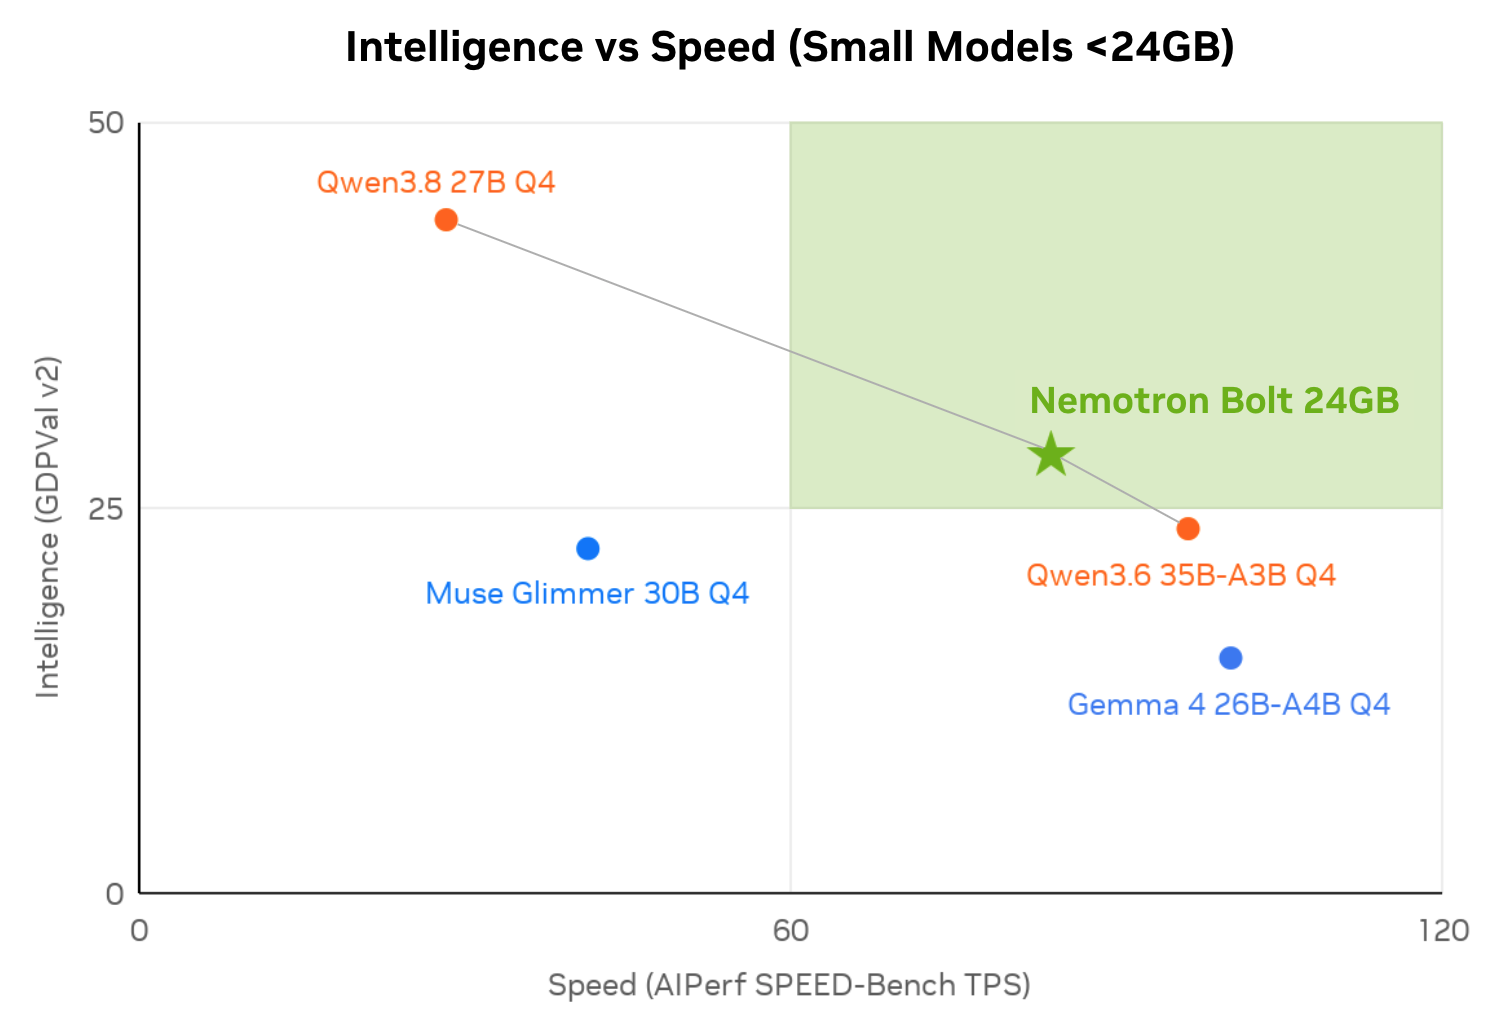
A leitura honesta desse gráfico é o que interessa. O Bolt não é o modelo mais inteligente da faixa: o Qwen3.8 27B, com 27 bilhões de parâmetros densos, fica acima dele no eixo vertical — a cerca de 44 contra 28 no índice GDPVal — e paga por isso com 28 tokens por segundo contra 84. O Bolt também não é o mais rápido: Qwen3.6 35B e Gemma 4 26B passam de 96 e 100 tokens por segundo. O que a NVIDIA está vendendo, e o gráfico mostra isso corretamente, é a melhor combinação das duas coisas dentro de 24 GB.
O que a medição independente mostra
O Bolt foi testado fora da NVIDIA no mesmo dia do lançamento. O serviço de benchmarks llm-speed rodou o GGUF oficial de 22 GB no llama.cpp em três placas de consumo, com todas as camadas na GPU: 107,3 tokens por segundo numa RTX 4090, 87,8 numa RTX 3090 e 154,7 numa RTX 5090, com contexto de 4 mil tokens. O pico de memória ficou em 22,0 GB de 24,6 GB disponíveis na 4090.
Ou seja: o número de 84 tokens por segundo da NVIDIA não é teto, é o que o notebook dela entrega — uma 4090 comum faz mais. E o encaixe em 24 GB se confirma, com uma ressalva importante que o benchmark registra: é encaixe para um usuário. Quando o teste tentou decodificação concorrente nas placas de 24 GB, o servidor registrou repetidamente "Context size has been exceeded". Na 4090, o maior contexto testado sem estourar foi 16 mil tokens; na 3090, 8 mil. Bem longe dos 256 mil do model card.

Três números da tabela da NVIDIA merecem atenção porque contrariam a manchete:
- Velocidade: no AIPerf, o Bolt marca 83,99 tokens por segundo contra 96,63 do Qwen3.6 35B-A3B e 100,56 do Gemma 4 26B-A4B. E, no teste de ponta a ponta com trajetórias reais de agente (AA AgentPerf Local), o Bolt leva 600,8 segundos para completar o mesmo replay que o Qwen3.6 termina em 453,97 e o Gemma 4 em 480,68. Ser maior e mais lento tem custo.
- PinchBench: a NVIDIA diz "número 1", mas a tabela dela mesma mostra Qwen3.6 35B-A3B com 88,07 e o Bolt com 87,82. As duas coisas são verdade ao mesmo tempo: o primeiro lugar vale dentro do recorte "modelos pequenos" do leaderboard, não na lista inteira.
- Conhecimento: em AA-Omniscience, o Bolt acerta 16,90 contra 22,17 do Gemma 4 26B e 19,47 do Qwen3.6. E a taxa de não-alucinação é 61,27, abaixo dos 65,85 do Qwen3.6. O Bolt sabe menos sobre o mundo e inventa um pouco mais — o que é coerente com 2 bits: o modelo foi otimizado para agir, não para lembrar.
Onde ele ganha de forma clara é no que a NVIDIA projetou: uso de terminal (Terminal-Bench 2.1 com 50,98 contra 44,38 e 37,22), navegação com resultado (BrowseComp 66,75 contra 48,74 e 26,30), uso de ferramentas (MCP-Atlas 52,20) e WebArena com visão (50,86). É um modelo de agente, não de enciclopédia.
Um detalhe que merece crédito: numa nota de rodapé, a NVIDIA informa que o Qwen3.6 35B reporta 62,8 no MCP-Atlas, mas que ela mediu 51,2 ao rodar as 500 tarefas públicas. Ou seja, a própria fabricante refez o número do concorrente e publicou o resultado menor. É o tipo de coisa que deveria ser padrão na indústria e quase nunca é.
O detalhe que decide no Brasil
O model card lista os idiomas cobertos: inglês, espanhol, francês, alemão, italiano e japonês. E diz, em letras claras, que "inglês e linguagens de programação são os idiomas primários". Português não aparece.
Isso não significa que o modelo não escreva em português — modelos multilíngues generalizam, e um agente que chama ferramentas em JSON não depende de idioma. Significa algo mais específico e mais chato: ninguém mediu. Se você vai usar o Bolt para atendimento, geração de contrato, laudo ou conteúdo em português do Brasil, você é a primeira pessoa a testar isso. Na prática, a recomendação é rodar exatamente o seu caso antes de decidir — é o mesmo critério que aplicamos quando avaliamos um modelo aqui.
Para empresas brasileiras, porém, há um argumento que não é de benchmark: o dado não sai da máquina. Um modelo que roda em 24 GB de VRAM permite processar documentos com dado pessoal sem mandar nada para fora, o que muda a conversa sobre LGPD de "como justificar a transferência internacional" para "não houve transferência". O preço disso é o hardware, pago em real, e a manutenção de um servidor local — a conta que a nuvem embutia na assinatura.
A mesma semana mostrou o outro extremo
Vale olhar os três lançamentos juntos, porque eles definem o que "aberto" passou a significar em outubro de 2026. O Muse Spark Open, da Meta, abriu 816 bilhões de parâmetros (42 bilhões ativos), contexto de 1 milhão de tokens e entrada de texto, imagem, vídeo e áudio — mas o checkpoint em 4 bits pede cerca de 530 GB e roda em dois Mac Studio M5 Ultra, cada um com 512 GB de memória unificada. O Step 5 pede 650 GB e quatro GPUs. O Bolt pede uma placa de 24 GB.
São três respostas diferentes para a mesma promessa de "pesos abertos": o modelo que se baixa, o modelo que se roda com investimento de servidor, e o modelo que se roda no desktop. Só o terceiro muda o que um time pequeno consegue fazer sem contratar nuvem. E só ele vem com o custo escondido de ser o menos capaz dos três.
O que fica
O Nemotron 3.5 Bolt resolve um problema real e resolve com engenharia honesta: comprimir um modelo grande é melhor do que treinar um pequeno, quando o limite é memória, e a NVIDIA publicou o método, os dados de treino e o relatório técnico para quem quiser conferir. A medição independente confirma o encaixe em 24 GB e mostra que a velocidade vai além do número oficial.
O que ela também mostra é que o Bolt é o melhor modelo por gigabyte, não o melhor modelo. Em conhecimento geral ele perde para concorrentes com metade dos parâmetros; em português, ninguém sabe ainda. Para uma empresa brasileira decidindo onde colocar a IA dela, isso resume a escolha: se o problema é privacidade e custo por token em volume, o caminho local ficou viável esta semana; se o problema é acertar mais, o modelo maior e mais lento continua ganhando — mesmo que ele não caiba na sua placa.
Fontes
- NVIDIA Research — Nemotron 3.5 Bolt 74B-A9B 24GB (15/10/2026)
- Hugging Face — model card e tabela de benchmarks do Nemotron 3.5 Bolt (15/10/2026)
- NVIDIA — Technical Report: compressão, quantização e custo em acurácia (out/2026)
- NVIDIA Blog — Nemotron 3.5 Super VL e a família Bolt (15/10/2026)
- llm-speed — medição independente em RTX 3090, 4090 e 5090 (15/10/2026)
- arXiv — Star Elastic: compressão guiada por roteador (2026)
- arXiv — Quantization-Aware Distillation (2026)
- Meta AI Research — Introducing Muse Spark Open (15/10/2026)
- PinchBench — recorte de modelos pequenos citado pela NVIDIA
- WebArena leaderboard — comparação de modelos abertos por faixa de tamanho