
O maior dia da matemática — e a fatura que veio junto
Em 6 de outubro, às 18h do horário de Nova York, a OpenAI publicou no GitHub um repositório chamado simplesmente openai/math. Dentro dele: 722 manuscritos de matemática organizados em 372 famílias de resultados relacionados, todos produzidos por um modelo interno que a empresa não lançou e nem nomeou.
O número que assusta não é só o tamanho da pilha. Segundo o próprio arquivo README do repositório, o modelo foi exposto a cerca de 4.000 problemas abertos e cada resultado consumiu, em média, três horas de raciocínio equivalente ao ChatGPT Pro. Um porta-voz disse à Scientific American que quase tudo saiu de um único prompt dado a um único agente — ou seja, sem o enxame de 10 mil agentes que, meses antes, tinha resolvido o problema de Navier-Stokes.
Se você já leu algo aqui no blog, sabe o que fazemos em seguida: pegar o número anunciado e medir. E é aí que a história fica interessante, porque no dia seguinte três dessas provas caíram.
O erro de sinal que derrubou três provas — e mexeu em 14
O próprio repositório mantém um arquivo de histórico. Na entrada de 7 de outubro, um dia depois do anúncio, está escrito com todas as letras: em “Algebraicity of Weil classes on split abelian eightfolds” existe um erro de sinal. Esse único sinal invalida um argumento de cancelamento de traços e, por dependência, a construção usada por outros dois artigos.
Resultado: três manuscritos foram retirados — o original e mais dois que dependiam dele. No mesmo dia, a OpenAI revisou outros 14 (reparos de prova, enunciados corrigidos, hipóteses explícitas, uma citação obsoleta removida) e adicionou 6 novas formalizações. A coleção pública passou de 722 para 719 manuscritos. Os três retirados continuam acessíveis, com aviso explicando a lacuna.
Nada disso é escândalo: errar faz parte. O que chama atenção é o método. O laboratório publicou tudo junto — material conferido por máquina e material que ninguém pode conferir — e o desmentido veio dentro de casa, em menos de 24 horas. Como escreveu o matemático Matt Baker, do Georgia Tech, com os recursos que tem, “não há razão para publicar de forma tão desleixada”.
“42% formalizado”. Nossa contagem diz 24%.
Aqui é onde a medição independente separa o anúncio do fato.
O README afirma que o repositório tem “~42% dos resultados top-line formalizados”. O histórico fecha a conta em 300 de 719. O problema: “resultado top-line” não é definido em lugar nenhum. É um numerador sem lista e um termo sem régua.
Então fomos contar o que dá para contar. O repositório publica um catálogo de formalizações — o arquivo que lista, item por item, quais artigos têm resultado principal provado em Lean, linguagem em que um computador confere cada passo lógico. Contamos as entradas em 14 de outubro: 173. Sobre 719 manuscritos, isso é 24%. Não 42%.
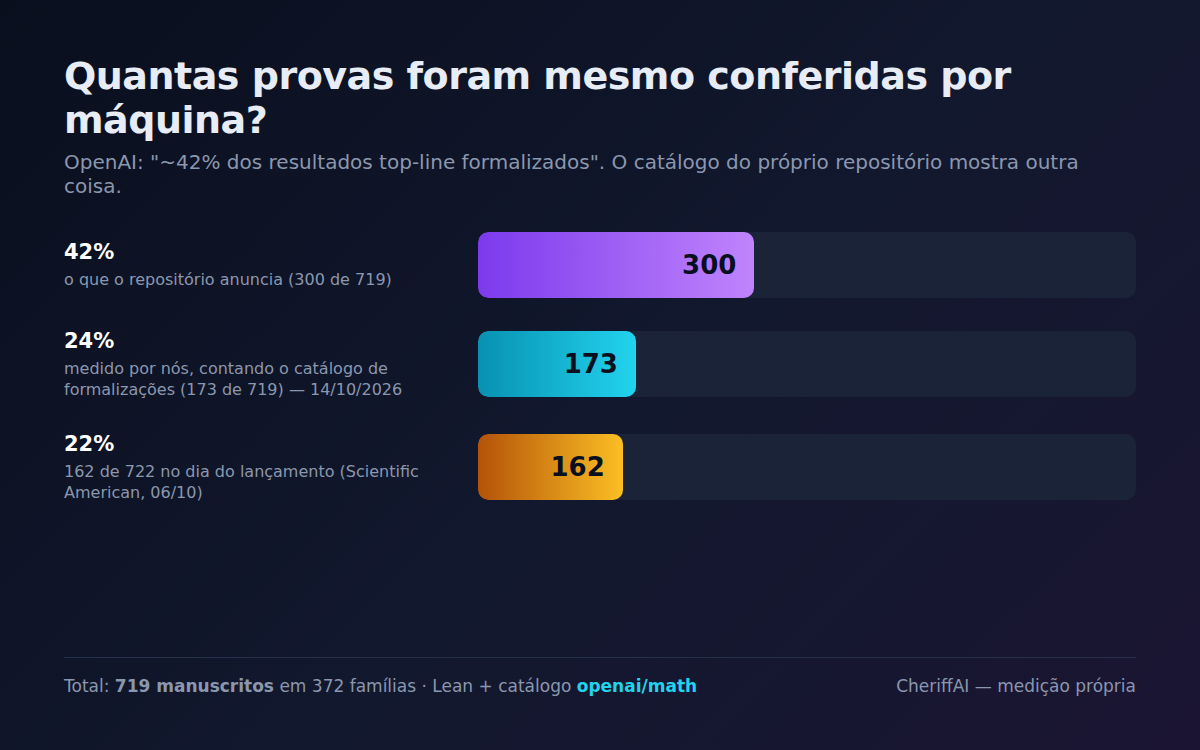
Não estamos sozinhos nessa conta. No dia do anúncio, a Scientific American registrou 162 de 722 com resultado principal formalizado — cerca de 22%. A diferença entre 22%, 24% e 42% não vem de mentira: vem de definição. Muda o que se conta no numerador e o que se conta no denominador. Mas essa é exatamente a pergunta que qualquer leitor deveria fazer diante de uma porcentagem: contando o quê, contra o quê, sobre qual fatia?
“Verificado” não é um carimbo — é uma pergunta com três partes
Vale entender o que a palavra “formalizado” garante. Quando um modelo resolve um problema, ele primeiro escreve a prova em linguagem natural e depois tenta traduzi-la para Lean, um assistente de provas que checa se a prova formal decorre de fato do enunciado formal, com um kernel confiável e minúsculo. É poderoso e é estreito.
Estreito porque uma checagem bem-sucedida no Lean prova só uma coisa: que a prova formal está correta para aquele enunciado formal. Ela não prova que o enunciado formal diz a mesma coisa que a frase em português (ou inglês) do artigo. É a chamada lacuna de fidelidade. E ela não é hipótese: um artigo de matemáticos de Cambridge e do King's College London documenta ao menos duas discrepâncias entre a prova em linguagem natural e o código Lean da solução de Navier-Stokes anunciada pela OpenAI. Nas palavras dos próprios autores, provas automáticas “não devem ser consideradas confiáveis sem o mesmo escrutínio por pares ao qual outras provas são submetidas”.
Do outro lado, quem defende o Lean tem argumento forte. O britânico Kevin Buzzard, que mais fez para popularizar a ferramenta entre matemáticos, resumiu recentemente: “Você não engana o Lean; você aprende isso muito cedo. Ele não aceita prova por autoridade nem prova por intimidação.” Matt Baker, do Georgia Tech, estima em menos de 1% a chance de um erro do tipo “a prova formal é de outro teorema” passar batido.
Os dois lados convivem. Lean derruba a chance de uma prova errada; não derruba a chance de uma prova irrelevante, copiada de técnica existente ou que resolve um problema que não era o problema.
O que os matemáticos pediram × o que foi entregue
Antes do lançamento, a OpenAI consultou o AGMAI, grupo consultivo de nove matemáticos de destaque hospedado no Institute for Advanced Study, em Princeton. As recomendações do grupo saíram em 29 de setembro. A TechCrunch comparou o documento com o que saiu do repositório.
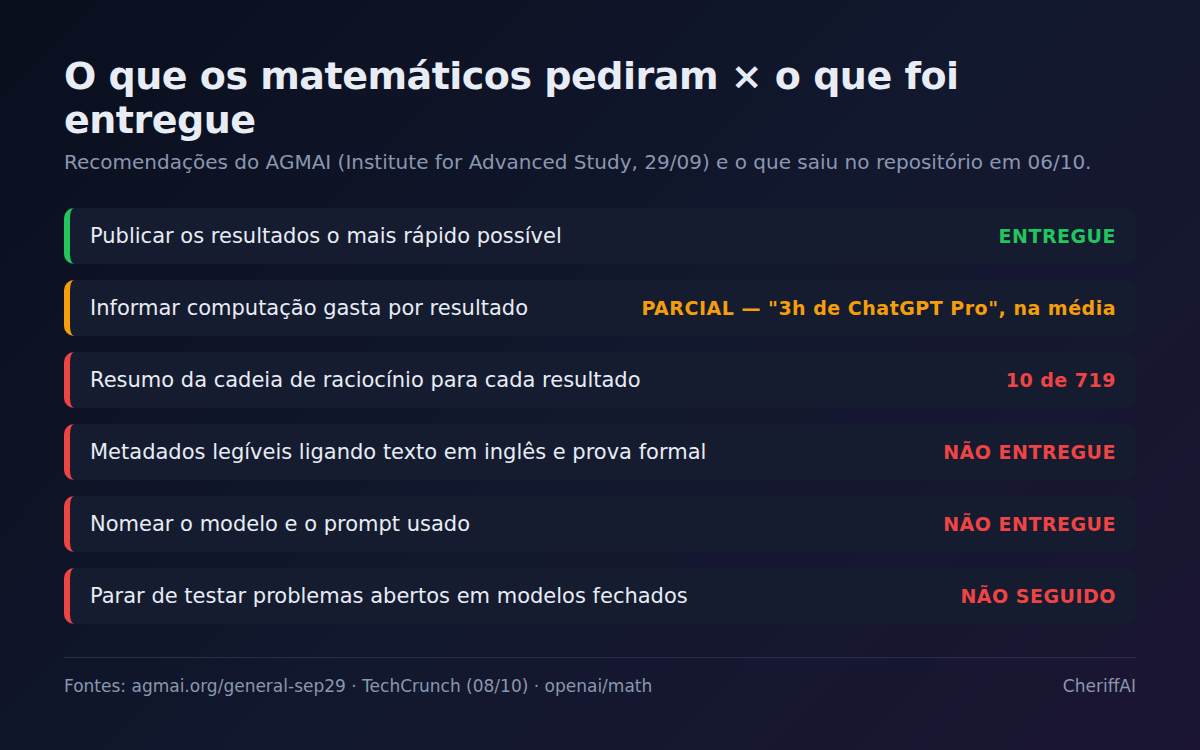
Três pontos pesam mais:
- Raciocínio para cada resultado: o AGMAI pediu a cadeia de raciocínio. O repositório traz resumos para 10 dos 719 manuscritos — a própria TechCrunch conta dez.
- Metadados ligando texto e prova formal: pedido explicitamente e não entregue.
- Parar de testar problemas abertos em modelos fechados: era o primeiro pedido do grupo. O README diz, com estas palavras, que a empresa avalia modelos proprietários em problemas abertos de matemática.
O custo humano disso foi resumido por Terence Tao: problemas “estão sendo resolvidos autonomamente por prompteres de IA sem interesse no campo”, que não conseguem “responder perguntas sobre o resultado, dar palestras ou interagir com o resto da área”. Melanie Wood, de Harvard, disse à TechCrunch a mesma coisa em uma frase: quando o modelo responde, “não há entendimento humano no momento da publicação — e agora começa o trabalho”.
Nem tudo é hype: o que passou no crivo
Seria desonesto encerrar aqui. Parte do material aguentou o teste — inclusive um teste feito fora da OpenAI.
Um matemático da comunidade reproduziu de forma independente a conferência Lean do resultado sobre a quase-hipótese de Riemann (a prova de que a função zeta não tem zeros com parte real maior que 7/8). Rodou contra o desafio original e contra um desafio escrito por ele mesmo, ligou um segundo kernel de verificação e obteve aceitação nos dois. Os 2.924 módulos da prova compilaram sem erro nem aviso, e a lista de axiomas usados é curta: três. No mesmo dia, outro pesquisador estendeu o resultado sobre multiplicação de matrizes (expoente ω ≤ 2,25), que valia para números complexos, para um campo mais geral.
Ou seja: existe sinal real aqui. Existem provas que passam por checagem mecânica, reproduzível, com código aberto. O que não existe é o atalho que o marketing sugere — “a IA resolveu 372 problemas abertos”. O que existe é uma pilha de 719 manuscritos em que uma parte foi conferida por máquina, uma parte menor foi conferida por humanos, três caíram em um dia e o resto espera fila.
O gargalo mudou de lugar — e isso vale para quem usa IA no Brasil
A lição mais útil deste episódio não é sobre matemática. É sobre verificação.
Durante anos, o gargalo da IA foi gerar: modelo maior, mais dados, mais GPU. Agora o gargalo é conferir. A produção cresceu mais rápido do que a capacidade humana de checar — e o desequilíbrio aparece primeiro onde a exatidão é obrigatória, como na matemática. Vai aparecer em seguida onde há dinheiro e risco: laudo médico, parecer jurídico, cálculo contábil, código em produção.
Para uma empresa brasileira que já usa IA, isso vira três perguntas de auditoria simples, que podem entrar em qualquer política interna hoje:
- Verificado por quê? Por um humano, por um teste automatizado, por um modelo? São níveis diferentes de garantia.
- Contra o quê? Contra o enunciado original ou contra uma tradução dele? A lacuna de fidelidade do Lean é a mesma que existe entre o pedido do cliente e o prompt que você escreveu.
- Sobre qual fatia? 42% ou 24%? 10 de 719? Um número sem denominador é uma opinião.
É isso que separa uma entrega de IA confiável de uma pilha de arquivos bonitos. E é por isso que aqui na CheriffAI a regra é chata e repetitiva: todo número tem fonte, data e denominador. Inclusive os nossos.
Fontes
- GitHub — repositório openai/math, README e history.md (consultados em 14/10/2026)
- OpenAI — README do repositório: 719 manuscritos, 372 famílias, ~3h de compute por resultado, ~4.000 problemas (06/10/2026)
- OpenAI — history.md: 3 retiradas, 14 revisões e 6 novas formalizações (07/10/2026)
- OpenAI — catálogo de formalizações em Lean (base da nossa contagem: 173 entradas em 14/10/2026)
- Scientific American — OpenAI unleashes hundreds more math results upon a field already in shock (06/10/2026)
- TechCrunch — OpenAI's math solutions aren't meeting the field's standards yet (08/10/2026)
- arXiv 2610.08144 — Navier–Stokes lost in translation: por que a verificação em Lean não garante a prova em linguagem natural (out/2026)
- AGMAI (Institute for Advanced Study) — recomendações para laboratórios que publicam matemática gerada por IA (29/09/2026)
- Matt Baker (Georgia Tech) — Some early morning thoughts on the OpenAI dump (08/10/2026)
- OpenAI Developer Community — First look at mathematics manuscripts (06–07/10/2026, inclui a reverificação independente da prova sobre a função zeta)
- Hacker News — OpenAI withdraws three mathematical results (discussão, 08/10/2026)