
32 minutos
Na quarta-feira (21/10), a OpenAI anunciou que milhares de agentes de IA leram e interpretaram dados de milhões de células de cérebro de camundongo em 32 minutos. O número rodou o mundo em uma tarde. A pergunta que quase ninguém fez é mais simples: 32 minutos de quê?
A resposta está no próprio preprint publicado no bioRxiv em 16/10 — cinco dias antes do anúncio e, como todo preprint, sem revisão por pares. É um trabalho sério, com números públicos e código aberto. E é também um exemplo perfeito do que a CheriffAI faz todo dia: separar o que foi medido do que foi estimado.
O que exatamente foi feito
Três instituições assinam o trabalho: OpenAI, PerturbAI e Scripps Research. O material de partida não foi gerado por eles: é um atlas CRISPR de cérebro inteiro que já existia, publicado pela PerturbAI em março de 2026.
Os números do conjunto de dados, medidos por quem o construiu: 7,7 milhões de células, 19.070 mRNAs e 8.588 guias (sgRNAs), cobrindo quase 2.000 genes ligados a doenças, com os tipos celulares anotados pela taxonomia do Allen Institute. São camundongos vivos, neurônios de verdade, e o efeito de desligar um gene de cada vez.
O problema que esse tipo de experimento cria é novo e desconfortável: a coleta de dados ficou mais rápida que a interpretação. Um laboratório consegue perturbar dois mil genes; ninguém consegue ler, cruzar com a literatura e explicar dois mil resultados em tempo humano. É esse gargalo — e não a biologia — que os agentes atacam.
Um agente por gene, 1.946 no total
O método tem nome de manual: raciocínio biológico distribuído. Em vez de entregar o atlas inteiro a um modelo e pedir "explica isso", a equipe rodou 1.946 agentes em paralelo, cada um responsável por uma perturbação. Cada agente recebia o perfil de expressão gênica daquele gene por tipo celular, acesso a ferramentas de análise e acesso à literatura científica.
Cada um devolvia um relatório estruturado: achados, evidência quantitativa, interpretação, referências, ressalvas e sugestões de próximo experimento. Depois, agentes de síntese comparavam os relatórios entre si para achar convergências, divergências e relações entre genes. O resultado é um atlas de raciocínio: um grafo ligando genes, efeitos celulares, papers e mecanismos possíveis.
A escala do que foi lido impressiona mais que o tempo: 39.185 leituras de artigos registradas e 16.445 citações retidas — em média 19 papers lidos e 8 citados por perturbação.
O placar real: 48 de 55
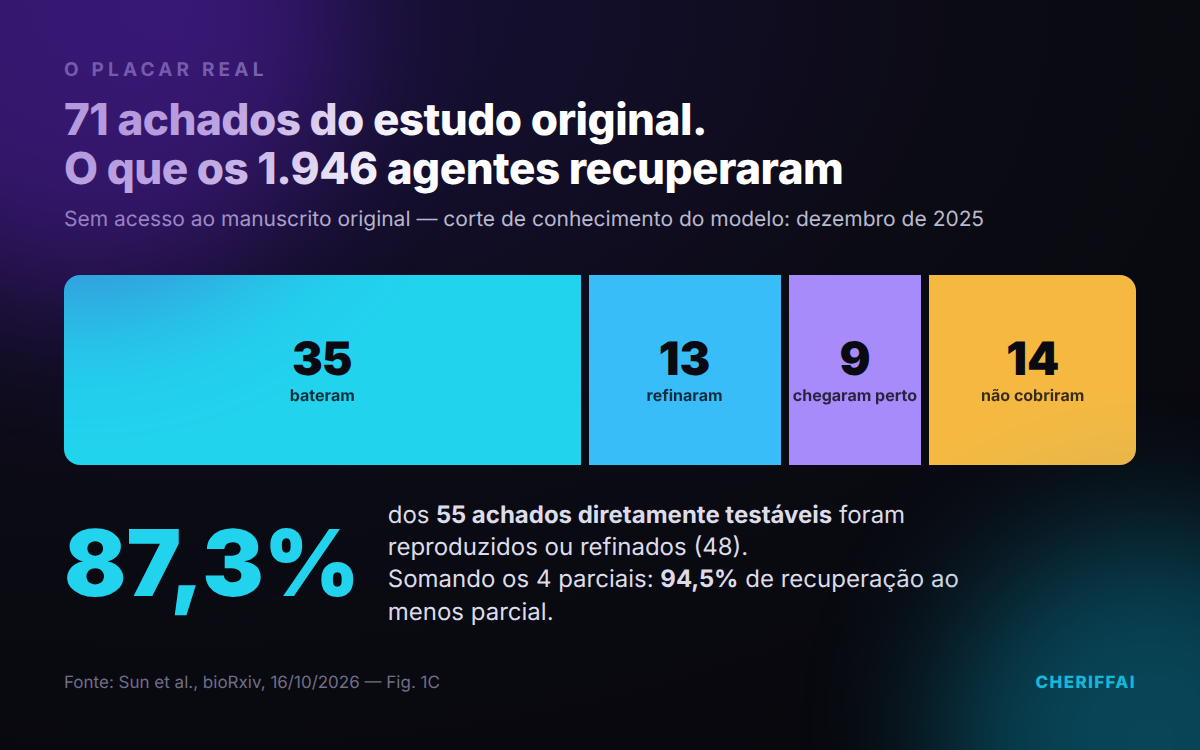
O teste mais duro do paper é também o mais elegante. Os pesquisadores esconderam o manuscrito original e suas conclusões dos agentes. O modelo usado, GPT-Rosalind-5.5, tem corte de conhecimento em dezembro de 2025; o estudo original saiu em março de 2026. Ou seja: o sistema não podia ter decorado a resposta.
Dos 71 achados do estudo original, os agentes reproduziram 35, refinaram 13, chegaram parcialmente em 9 e não cobriram 14. Restringindo aos 55 achados diretamente testáveis com os dados fornecidos: 48 batem ou refinam — 87,3% — e quatro chegam perto. São 94,5% de recuperação ao menos parcial.
Tem mais três medições que merecem respeito:
— Em perturbações que o modelo nunca viu (1.674 no treino, 272 separadas para teste), os agentes acertaram a força da resposta com acurácia balanceada de 0,705, identificando corretamente 82% dos casos sem resposta e 59% dos casos com resposta.
— Na tarefa de prever quais neurônios morrem, o enxame teve recall mediano de 0,36 no top 50, contra 0,18 do agente único, 0,26 de uma referência de essencialidade genética (DepMap) e 0,14 de um ranking por magnitude de mudança. É o dobro do agente único — numa tarefa em que o acaso não ajuda.
— Em julgamento cego, especialistas humanos preferiram os relatórios do enxame aos do agente único em 75% das comparações, segundo o anúncio da OpenAI.
O que o "32 minutos" mede — e o que não mede
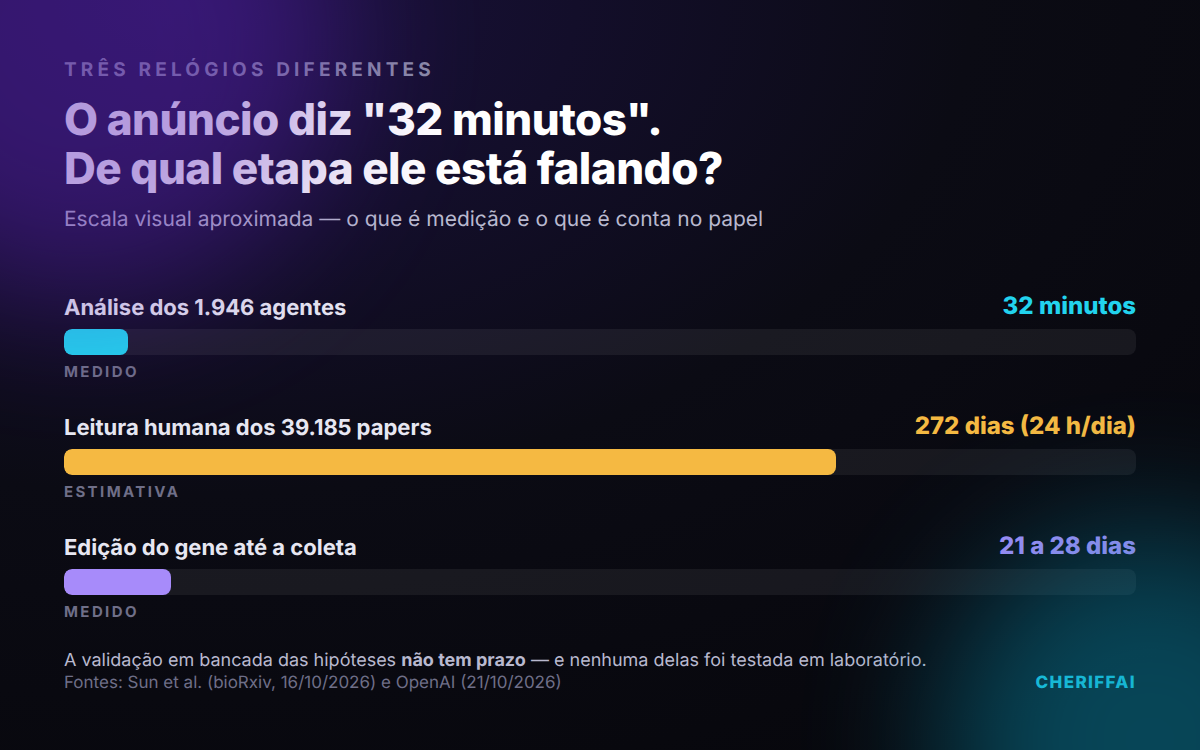
Aqui o anúncio escorrega, e o preprint é honesto sobre isso. O número de comparação — "meses a um ano" de trabalho humano — é uma estimativa ilustrativa, com premissas explícitas: US$ 22 por hora, 15 minutos para interpretar uma perturbação e 10 minutos por artigo lido. O próprio artigo escreve, na legenda da figura, que isso não é desempenho humano medido.
Refiz a conta com as premissas deles: 39.185 artigos × 10 minutos = 6.531 horas de leitura, ou 272 dias ininterruptos. Somando 1.946 perturbações × 15 minutos, chega-se a 292 dias — 9,6 meses. A estimativa bate. E, a US$ 22 a hora, custaria cerca de US$ 154 mil de salário. É uma conta no papel, não uma cronometragem.
Segundo ponto, mais importante: os 32 minutos cobrem só a análise computacional. Ficam de fora a coleta das 7,7 milhões de células, os experimentos de CRISPR — o próprio paper menciona o intervalo de 21 a 28 dias entre a edição do gene e a coleta — e, sobretudo, a validação em bancada. Nenhuma das hipóteses levantadas foi testada em laboratório. Não há tratamento, não há remédio, não há cura.
Onde o enxame erra
Do total de 1.519 achados de alta confiança, os agentes classificaram: 27,6% concordando com a literatura, 41,9% como inferência (mecanismo plausível, sem observação direta), 6,6% em conflito com o que se sabia e 23,8% sem nenhum precedente recuperado. Quase um quarto do que o sistema escreveu não tem lastro bibliográfico — e "nenhuma literatura encontrada" significa falha de busca, não inexistência de estudo.
O paper também testa a si mesmo, o que é raro e louvável: os pesquisadores trocaram as identidades das perturbações mantendo os dados. Se o sistema estivesse "entendendo", o casamento com a literatura deveria desabar — e desabou: os achados marcados como "concordam" caíram de 29,3% para 13,2% (embaralhando dentro do experimento) e para 6,1% quando os nomes vinham de genes fora do estudo. Sóbrou 6,1% de concordância espúria — o ruído do método, medido.
Na predição de resposta, os erros foram explícitos: 41 respostas perdidas e 30 superestimadas, contra 201 acertos. O sistema é bom, não é oráculo.
O achado que vale a pena entender
Entre os leads, dois exemplos mostram o tipo de coisa que o método entrega — hipótese específica, testável, e nenhuma promessa.
O primeiro: Tsc1 e Tsc2, dois genes que trabalham juntos no controle do mTOR. Desligar um ou outro tem efeito parecido em vários grupos de neurônios. No cerebelo, não: desligar Tsc2 mexeu em 83 genes; desligar Tsc1, em zero. Isso conversa com a esclerose tuberosa, em que alterações no cerebelo estão ligadas a mutações de TSC2.
O segundo, e mais comentado: DCTN1, cujas mutações causam a síndrome de Perry, uma doença neurodegenerativa com sintomas de Parkinson. Desligar Dctn1 aumentou a expressão de genes que fabricam colesterol. O agente cruzou isso com a literatura de transporte de colesterol e propôs uma pergunta: e se o problema não for a quantidade de colesterol, mas ele não chegar onde o neurônio precisa? Se for isso, restaurar o transporte poderia proteger neurônios. Se. É uma hipótese, e a própria OpenAI a apresenta como hipótese.

Quem mediu isso
Vale a transparência que o padrão da casa exige. Dos 14 autores do preprint, seis são funcionários da OpenAI, dois são da PerturbAI — que tem dois co-fundadores entre os autores. A avaliação por "especialistas humanos cegos" foi conduzida pela mesma equipe que construiu o sistema. Os conflitos de interesse estão declarados no próprio artigo, o que é correto, mas não transforma a avaliação em independente.
Do lado bom: o código do framework está no GitHub sob licença MIT e o corpus pode ser consultado sem instalar nada. Do lado realista: o repositório foi criado em setembro, tem zero estrelas, e o acesso hospedado roda hoje num endereço temporário. O dataset, esse sim, mostra adoção: 2.931 downloads no último mês.
O que isso muda para quem faz IA no Brasil
O deslocamento aqui não é "a IA descobriu uma cura". É mais estrutural e mais útil: o gargalo da ciência mudou de lugar. Durante décadas, o caro era o experimento. Agora o experimento é tão produtivo que a interpretação virou o limite — e interpretação, ao contrário de um sequenciador, pode rodar em software.
Para um laboratório brasileiro com orçamento apertado, a consequência prática é direta: se o dado é público (e este é), e o método está aberto sob MIT, a barreira para extrair mais do próprio experimento caiu. Não é preciso um cluster de GPUs: é preciso um bom desenho de agentes, disciplina de evidência e alguém capaz de julgar as hipóteses no fim. É exatamente a competência que não se terceiriza.
A lição que fica é a mesma de sempre na CheriffAI: o anúncio entrega o número bonito, a medição entrega o número completo. 32 minutos é verdade. Meses é estimativa com premissa declarada. 48 de 55 é medição, e vem com os sete que ficaram de fora. O que ainda não existe — e o texto da OpenAI diz isso com clareza — é a bancada.
Fontes
- OpenAI — Using thousands of AI agents to uncover new leads in biological data (21/10/2026)
- bioRxiv — Sun et al., Distributed AI agents enable comprehensive discovery of biological insights at scale (16/10/2026, doi:10.64898/2026.10.15.759436)
- Hugging Face — PerturbAI Brain-Wide In Vivo CRISPR Atlas (7,7 milhões de células)
- GitHub — jinlabneurogenomics/distributed_agent, licença MIT